

数据分析类Python项目计划书范文:爬虫清洗与可视化方案

编写一份结构规范、边界明确的 Python 数据分析项目计划书,核心在于把“业务目标”切实拆解为工程可落地的“采集机制”、“清洗管线”与“展示交互”三个技术闭环。很多团队在立项时常因缺乏严密的接口设计与风险边界,导致后续采集受阻、脏数据蔓延或图表脱离业务诉求。本文以“全国互联网技术岗位招聘数据与技能需求分析”为具体实施范例,完整呈现一份包含爬虫调度、数据清洗、指标建模与动态可视化的标准计划书范文。
一、项目概述与业务目标
本计划书旨在构建一套端到端自动化的数据采集、质量清洗与多维看板系统。项目聚焦于各大招聘公开渠道的岗位数据,通过自动化程序提取岗位名称、所属薪资、工作地点、经验年限、学历要求及岗位描述详情,为人才流动趋势、技能热度演变提供高可信度的数据支撑。
为确保项目可量化评估,立项期明确以下核心交付指标:
- 数据吞吐指标:单次全量采集有效样本数不低于 50,000 条,字段完整率达到 95% 以上。
- 清洗规范指标:实现非结构化薪资文本向标准数值字段(最低薪资、最高薪资、标准化月薪)的 100% 规则化转换,去除无意义字符与重复发帖。
- 看板可用性指标:可视化响应延时控制在 1 秒以内,支持按城市、经验、技能标签的下钻联动与动态筛选。
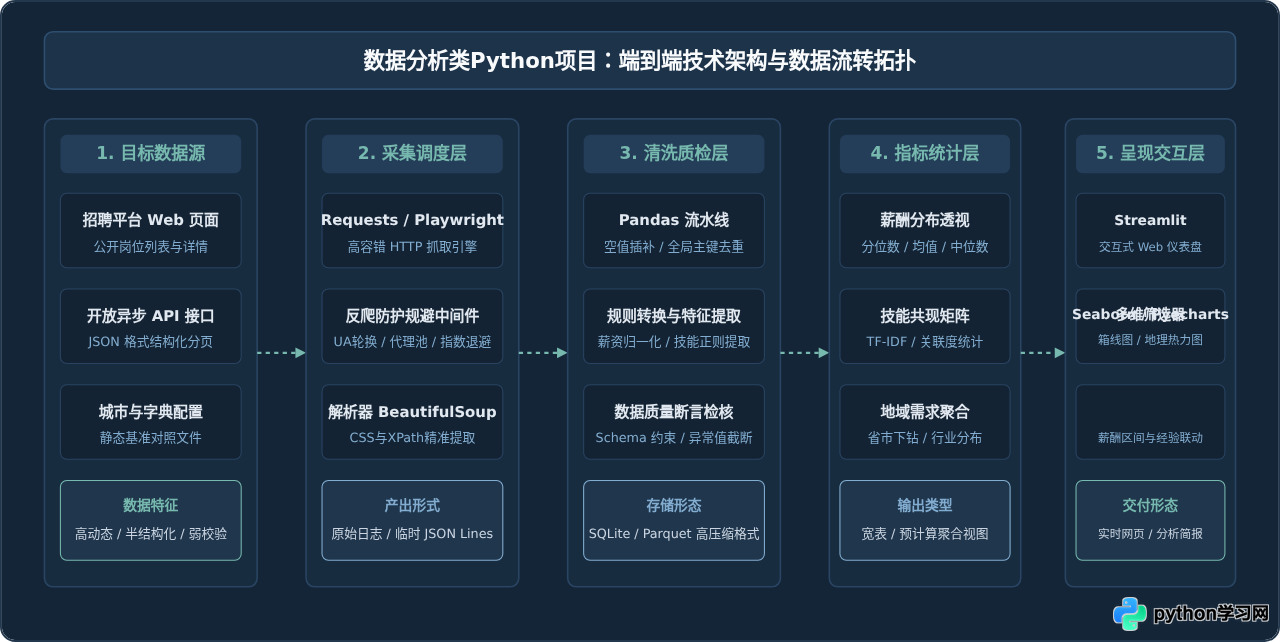
二、数据采集(爬虫)工程方案
采集阶段是保证原始数据广度与时效性的基石。在设计数据抓取模块时,必须平衡好“请求效率”、“服务稳定性”与“合规礼貌爬取”三者的关系。
1. 爬虫选型与网络请求策略
本项目采用以 requests + urllib3 连接池为主、针对高对抗反爬接口配合 playwright 进行轻量级无头渲染的双模方案。核心抓取逻辑基于会话保持机制,配置合理的连接复用与随机延时:
- 请求频率节流:每个工作线程在发起连续 HTTP 请求之间强制休眠
random.uniform(1.2, 3.5)秒,严格遵守目标站点的并发限制。 - User-Agent 指纹库:维护包含 Chrome、Firefox、Edge 等现代主流浏览器标识的 UA 池,每次请求动态轮询。
- 状态码与退避算法:对 429(Too Many Requests)与 503 等异常状态码实施指数退避重试(重试等待时间为 2^retry 秒),单条 URL 连续失败 3 次即隔离至异常重试队列,避免阻塞主流水线。
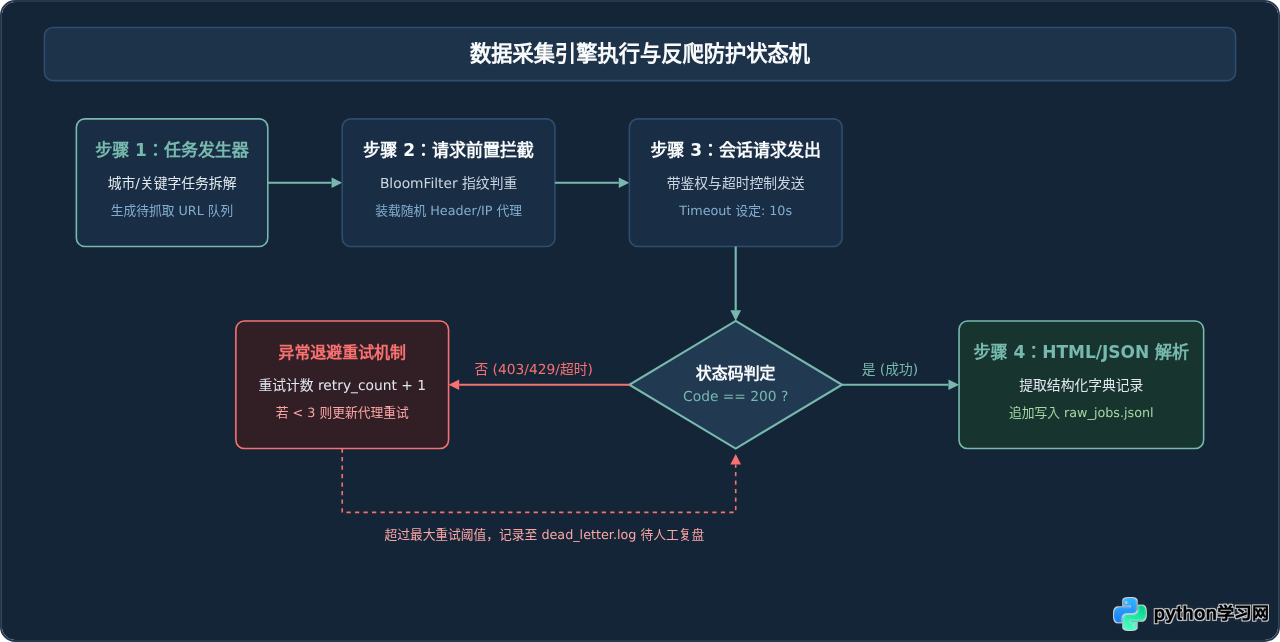
2. 核心采集模块代码实现范式
以下为计划书中约定的采集器核心代码实现框架。该模块被封装为可复用的 JobScraper 类,确保并发线程与配置参数完全解耦:
import time
import random
import logging
from typing import Dict, Any, List, Optional
import requests
from fake_useragent import UserAgent

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class JobScraper:
    def __init__(self, base_url: str, max_retries: int = 3):
        self.base_url = base_url
        self.max_retries = max_retries
        self.session = requests.Session()
        self.ua = UserAgent()

    def _get_headers(self) -> Dict[str, str]:
        return {
            "User-Agent": self.ua.random,
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
            "Connection": "keep-alive"
        }

    def fetch_page(self, keyword: str, page: int) -> Optional[str]:
        params = {"keyword": keyword, "page": page}
        for attempt in range(1, self.max_retries + 1):
            try:
                # 礼貌爬取:随机间隔 1.5 - 3.0 秒
                time.sleep(random.uniform(1.5, 3.0))
                response = self.session.get(
                    self.base_url,
                    headers=self._get_headers(),
                    params=params,
                    timeout=10
                )
                if response.status_code == 200:
                    return response.text
                elif response.status_code in [429, 403]:
                    logging.warning(f"触发反爬阈值,状态码: {response.status_code},正在进行第 {attempt} 次退避...")
                    time.sleep(2 ** attempt * 2)
            except requests.RequestException as e:
                logging.error(f"网络异常 (第 {attempt} 次尝试): {str(e)}")
                time.sleep(attempt * 2)
        return None
三、数据清洗与预处理方案
采集所得的原始数据通常充斥着无规则的文本混杂、薪资格式不齐、空值与脏字符。数据清洗方案的核心目标是将半结构化字段转换为具备明确类型语义(int, float, category)的分析宽表。
1. 清洗规则体系与业务转换逻辑
针对招聘场景的典型字段,计划书确立以下 4 项确定性处理准则:
- 薪资字段正则化:招聘信息常见表达有“15k-25k·14薪”、“8千-1.2万”、“300-500元/天”。建立正则解析器,统一将其换算为“标准月薪(千元)”与“年薪基准(万元)”。
- 工作经验归纳:将“应届生”、“1-3年”、“3-5年”、“5-10年”、“10年以上”标准化为序数分类变量;无法判断者填入“经验不限”。
- 技能实体提取:通过预设的技术关键词词库(Python、SQL、Tableau、Spark、Pandas、PyTorch),使用分词与正则表达式在职位描述(Job Description)中扫描有效技能项,构建二值矩阵或标签列表。
- 去重与脏数据剔除:以
(公司名 + 岗位名称 + 所在行政区)组合哈希作为唯一业务主键,过滤一周内重复发布的冗余职位。
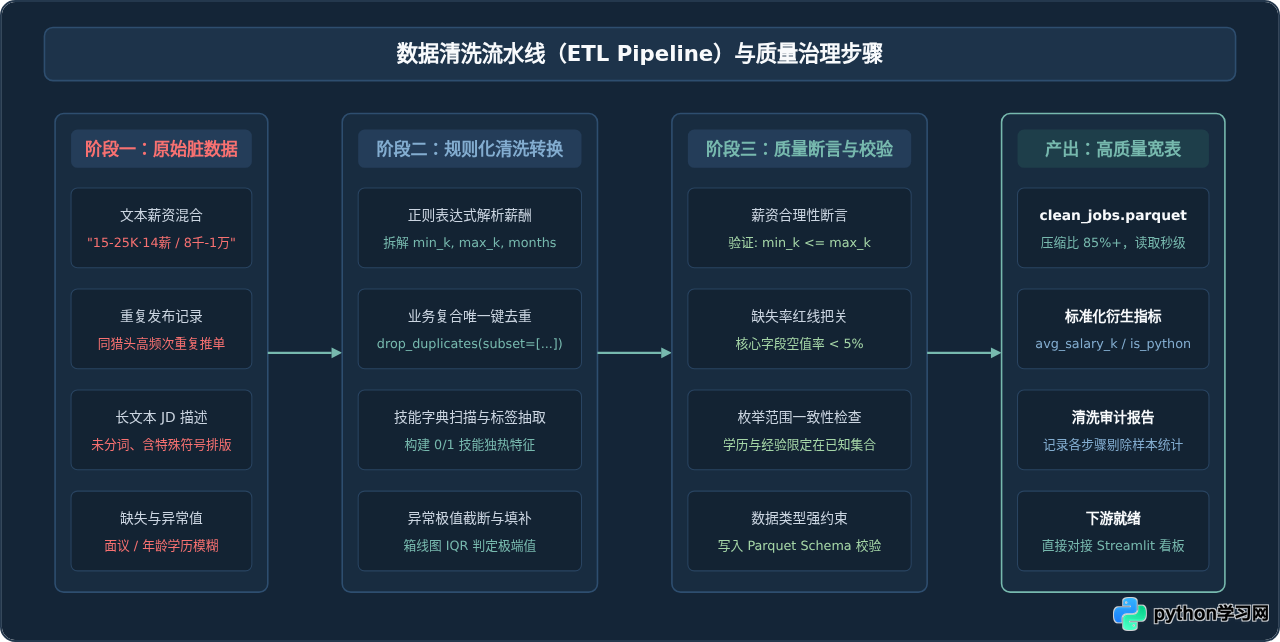
2. Pandas 清洗核心管线示例
import re
import pandas as pd
import numpy as np

def parse_salary(val: str) -> pd.Series:
    """
    将非结构化薪资字符串转换为统一的千元月薪区间
    示例: '15-25K·14薪' -> (15.0, 25.0, 20.0, 14)
    """
    if not isinstance(val, str) or val in ["面议", "薪资面议"]:
        return pd.Series([np.nan, np.nan, np.nan, 12])

    # 匹配月薪与年终薪数
    pattern = r"(\d+\.?\d*)-(\d+\.?\d*)\s*([kK千万])(?:\s*·\s*(\d+)薪)?"
    match = re.search(pattern, val)
    if not match:
        return pd.Series([np.nan, np.nan, np.nan, 12])

    low, high, unit, months = match.groups()
    low, high = float(low), float(high)
    months = int(months) if months else 12

    # 统一折算为以 '千元 (k)' 为基准单位
    if unit in ["万"]:
        low *= 10
        high *= 10

    avg_k = (low + high) / 2.0
    return pd.Series([low, high, avg_k, months])

def clean_jobs_pipeline(df_raw: pd.DataFrame) -> pd.DataFrame:
    df = df_raw.copy()

    # 1. 唯一主键去重
    df.drop_duplicates(subset=["company", "job_title", "city"], inplace=True)

    # 2. 薪资解析衍生
    salary_cols = ["salary_min_k", "salary_max_k", "salary_avg_k", "salary_months"]
    df[salary_cols] = df["raw_salary"].apply(parse_salary)

    # 3. 经验年限标准化
    exp_mapping = {
        "在校/应届": "应届生",
        "1年以内": "1年以下",
        "1-3年": "1-3年",
        "3-5年": "3-5年",
        "5-10年": "5-10年",
        "10年以上": "10年以上"
    }
    df["experience"] = df["raw_experience"].map(exp_mapping).fillna("经验不限")

    # 4. 关键技术标签抽取 (二值化特征)
    skills = ["Python", "SQL", "Pandas", "Tableau", "Spark", "PyTorch"]
    for skill in skills:
        df[f"skill_{skill.lower()}"] = df["job_description"].str.contains(
            rf"\b{skill}\b", case=False, na=False
        ).astype(int)

    # 5. 质量筛选:剔除薪资空值与极度异常值 (月薪 > 150k 或 min > max)
    df = df.dropna(subset=["salary_avg_k"])
    df = df[(df["salary_avg_k"] <= 150) & (df["salary_min_k"] <= df["salary_max_k"])]

    return df
四、数据可视化与分析看板方案
可视化是释放数据商业价值的交互终端。本计划书选定 Streamlit 作为看板框架,结合 Seaborn 与 Plotly 打造兼具探索性与交互性的分析界面。
技术选型权衡:相比于传统 Django/Vue 前后端分离模式,Streamlit 支持纯 Python 代码快速产出响应式布局,能够与 Pandas DataFrame 共享内存,极大缩短开发交付周期;在并发访问规模 < 500 的内部研报与决策场景下,具备极高的投入产出比。
1. 看板四大核心分析维度
| 分析板块 | 推荐图表类型 | 核心业务价值与洞察目标 |
|---|---|---|
| 薪酬空间透视 | 箱线图 (Boxplot) + 核密度估计图 (KDE) | 剔除极端发帖影响,呈现不同工作年限下的真实薪酬中位数、25%与75%分位分布。 |
| 城市需求热度 | 地理气泡图 (Geo Scatter) + 柱状条形图 | 对比北上广深与新一线城市的岗位绝对数量、平均薪酬差异,辅助人才流动规划。 |
| 核心技能矩阵 | 横向条形图 + 技能共现热力图 (Heatmap) | 量化 Python、SQL 与大数据组件的同时出现频率,识别最受市场欢迎的高薪技能组合。 |
| 学历与岗位要求 | 双向堆叠柱状图 (Stacked Bar) | 展示不同薪资分段内对大专、本科、硕士学历的门槛分布,剖析学历溢价效应。 |
五、项目实施里程碑、风险控制与交付物清单
项目整体按 4 周实施周期推进,严格执行“迭代式交付、每阶段设门禁(Quality Gate)”的敏捷管理原则。每个里程碑必须输出对应成果并通过质量审查后方可进入下一环节。
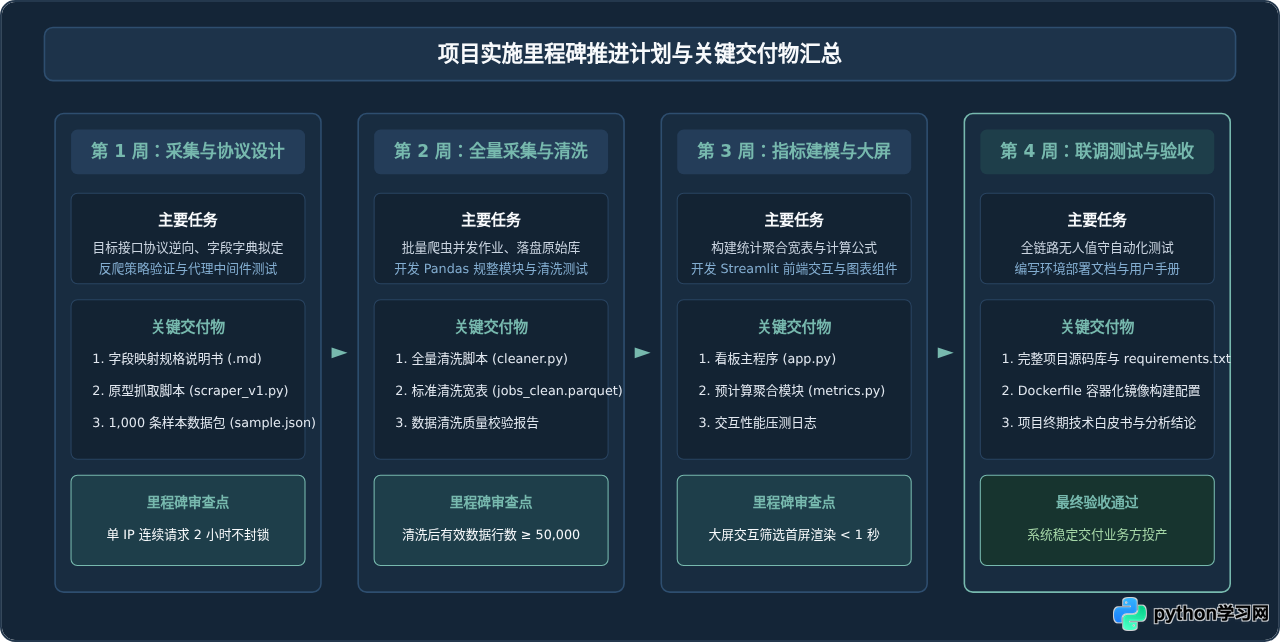
项目风险防范与应对预案
- 目标网站结构调整与前端混淆:在解析层建立容错回退机制,采用基于文本模式识别与通用标签路径的兜底提取策略,当解析命中率低于 80% 时自动发出邮件告警。
- 网络反爬规则升级:预留商业动态隧道代理接口,当内置 IP 池封禁率超过 30% 时,自动无缝切换为按量计费的动态住宅代理服务。
- 数据倾斜与分析口径偏差:在分析报告与大屏显著位置标注样本覆盖范围与限制条件(例如:仅统计公开披露薪资岗位,不包含保密特聘岗位),避免商业决策产生盲区。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









