

Python读取CSV时怎么指定列或跳过行?

在 Python 中读取 CSV 数据时,真实文件往往并不纯净:文件开头常包含说明性注释、作者信息或空行,同时单行可能包含数十个甚至数百个字段,全量读入不仅浪费内存还会拖慢解析速度。针对这些问题,最简洁高效的解决路径主要有两种:如果项目允许使用第三方数据分析库,使用 pandas.read_csv() 配合 skiprows 与 usecols 参数是最直接的一体化方案;如果处于受限生产环境或编写轻量脚本,使用 Python 标准库内置的 csv 模块配合 next()、列表推导或 csv.DictReader 则能在零外部依赖的前提下完成逐行过滤与字段提取。
一、使用 Pandas 高效指定列与跳过行
在数据处理与分析场景中,pandas.read_csv() 是功能最全面且调用最简练的接口。它内置了高度优化的底层 C/Rust 引擎,可以在文件解析之初就完成行跳过与列抽取,避免将整张大表完整展开到内存中。
1. 如何跳过指定的行(skiprows 与 skipfooter)
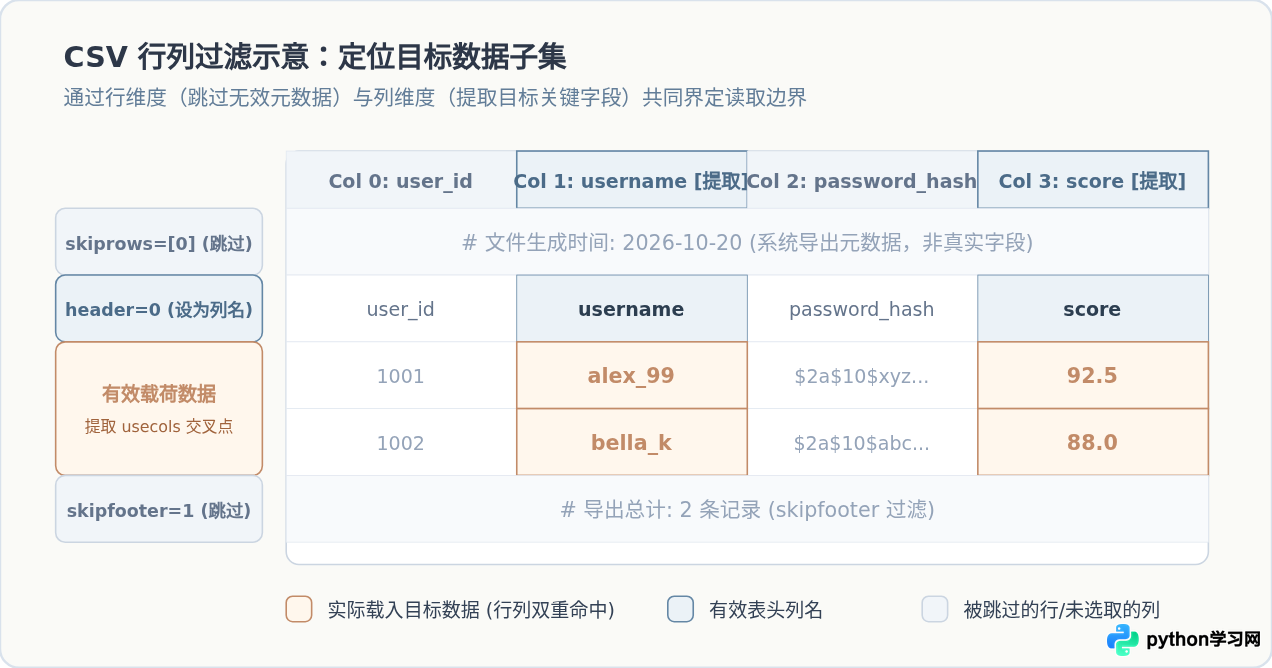
skiprows 参数支持三种传参格式,分别适应不同规律的行跳过需求:
- 跳过固定前 N 行:直接传入整数,例如
skiprows=2,将直接跳过文件最开头的 2 行。 - 跳过任意特定行号:传入行索引列表(从 0 开始),例如
skiprows=[0, 2, 5],只会跳过第 0、第 2 和第 5 行,其余行正常解析。 - 基于动态条件过滤行:传入一个可调用函数(如 lambda)。该函数接收当前行索引
x(0 代表第一行),返回True时表示跳过该行。例如skiprows=lambda x: x % 2 == 1可用于跳过所有奇数行。
import pandas as pd

# 示例 1:跳过文件前 2 行说明信息,并将第 3 行识别为表头
df1 = pd.read_csv('records.csv', skiprows=2)

# 示例 2:跳过指定行(如第 0 行和第 4 行的异常记录)
df2 = pd.read_csv('records.csv', skiprows=[0, 4])

# 示例 3:跳过注释行(如以 '#' 开头的文本行可以直接配置 comment 参数)
df3 = pd.read_csv('records.csv', comment='#')

# 示例 4:跳过文件末尾的最后 3 行汇总说明(需指定 engine='python')
df4 = pd.read_csv('records.csv', skipfooter=3, engine='python')注意:当使用 skipfooter 跳过末尾行时,Pandas 默认的 C 解析引擎不支持该特性,必须显式声明 engine='python',否则会触发 ParserWarning 警告。
2. 如何指定要加载的列(usecols)
如果原始 CSV 文件包含几十个字段,但分析任务只需要其中几个,使用 usecols 可以在源头降低 80% 以上的内存开销:
- 按列名称指定:传入包含目标列名的列表,例如
usecols=['username', 'score']。 - 按列索引位置指定:传入从 0 起算的列序号列表,例如
usecols=[1, 3]。 - 按函数条件匹配列名:传入接受列名字符串并返回布尔值的函数,例如
usecols=lambda col: col.startswith('user_')。
# 示例 5:同时指定跳过前 2 行,并且仅加载 'username' 与 'score' 两列
df = pd.read_csv(
    'records.csv',
    skiprows=2,
    usecols=['username', 'score']
)

print(df.head())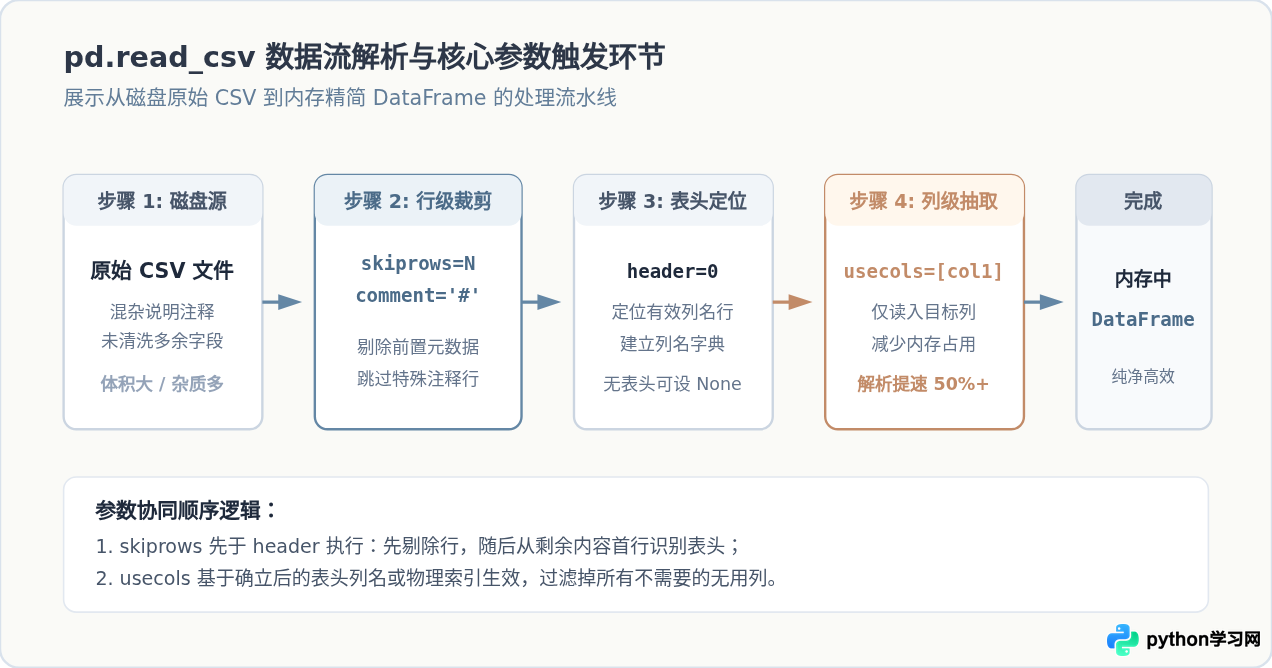
二、使用 Python 内置 csv 模块(零外部依赖)
当运行环境没有安装 Pandas,或者在内存严格受限(例如嵌入式环境或处理几十吉字节的巨型 CSV 文件)时,Python 标准库自带的 csv 模块是首选方案。它以流式生成器的方式逐行读取,内存占用始终恒定在 O(1)。
1. 使用 csv.reader 跳行与提取列
csv.reader 返回一个迭代器,每迭代一次产出一行字符串列表。控制行和列的做法非常直观:
- 跳过起始行:使用 Python 内置函数
next(reader)推进迭代器;跳过多行时可循环调用,或使用itertools.islice。 - 提取指定列:对每一行列表进行索引切片或列表推导式提取,例如
[row[1], row[3]]。
import csv
from itertools import islice

with open('records.csv', mode='r', encoding='utf-8') as f:
    reader = csv.reader(f)

    # 做法 A:调用一次 next() 跳过第 1 行元数据
    # next(reader)

    # 做法 B:使用 islice 跳过前 2 行(例如 1 行说明 + 1 行空行)
    # islice(迭代对象, 跳过数量, None)
    clean_reader = islice(reader, 2, None)

    # 读取真正的表头行
    header = next(clean_reader)
    print("表头:", [header[1], header[3]])

    # 遍历数据行,只提取第 1 列 (username) 和第 3 列 (score)
    for row in clean_reader:
        if not row:  # 预防空行
            continue
        username = row[1]
        score = row[3]
        print(f"用户: {username}, 分数: {score}")
2. 使用 csv.DictReader 按字段名提取
如果列顺序可能发生变动,按列索引硬编码容易出现数据错位。此时使用 csv.DictReader 会更加稳妥:
import csv

with open('records.csv', mode='r', encoding='utf-8') as f:
    # 如果文件开头有 2 行与表头无关的描述,先通过底层文件指针跳过
    for _ in range(2):
        f.readline()

    # 此时文件指针停留在第 3 行(真正的表头),DictReader 将自动以此行作为 keys
    reader = csv.DictReader(f)

    # 遍历时仅按字典键提取需要的列
    target_fields = ['username', 'score']
    for row in reader:
        selected_data = {k: row[k] for k in target_fields if k in row}
        print(selected_data)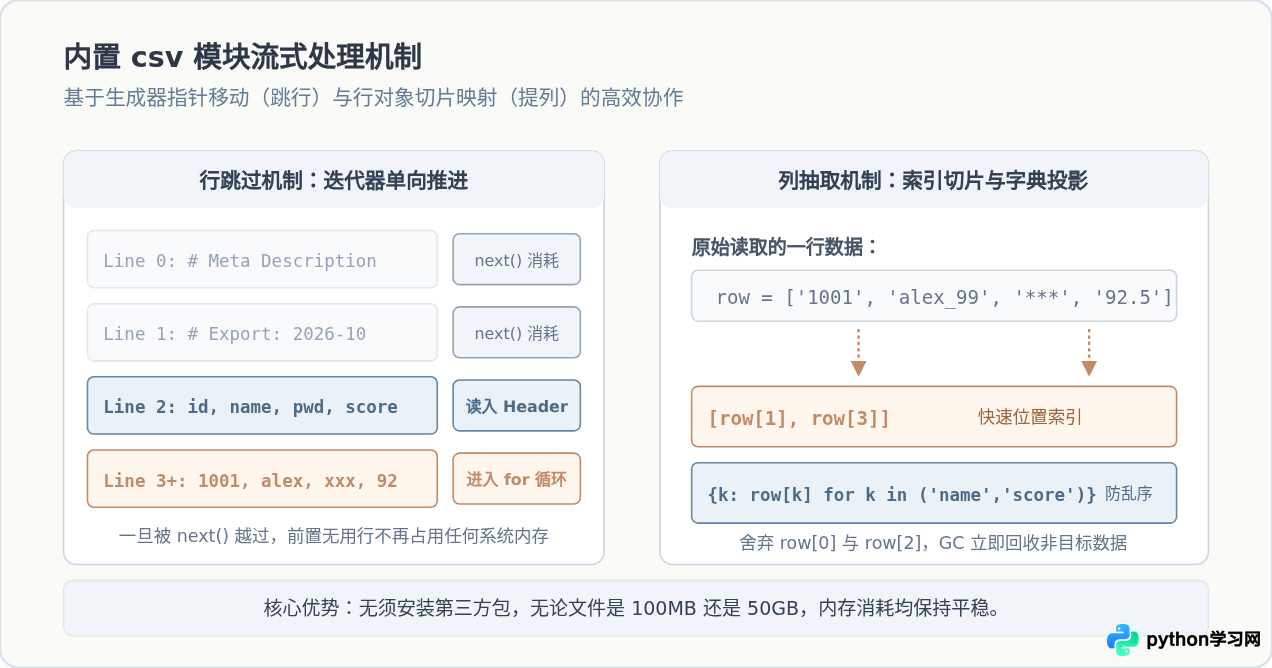
三、常见边界情况与排查指南
在实际编码中,很多人在组合使用 skiprows 与 usecols 时会遇到各种报错或数据解析偏位,以下是四个最容易踩坑的场景:
1. skiprows 与 header 的相对位置混淆
初学者容易疑惑:如果使用 skiprows=2,那么 header 的序号从哪里算起?
在 Pandas 的底层解析逻辑中,skiprows 发生在文件行读取的最前沿。被跳过的行直接被抛弃,不再进入后续解析。因此:
- 如果原文件第 0 行和第 1 行是注释,第 2 行才是列名;
- 设置
skiprows=2后,原第 2 行成为 Pandas 看到的第一行,此时默认header=0就会正确将原第 2 行识别为列名; - 反之,如果不使用
skiprows,而直接指定header=2,Pandas 会自动把第 2 行作为列名,并将第 0、1 行丢弃。这两种写法效果相近,但skiprows更加语义明确。
2. usecols 传入列名报错 KeyError
当使用 usecols=['username', 'score'] 时,如果代码抛出类似 KeyError: "Usecols do not match columns",通常由以下两个原因导致:
- 列名带有看不见的空格:很多 CSV 生成工具导出的表头其实是
"username "或" score",肉眼不易察觉。可以使用pd.read_csv('test.csv', nrows=1).columns.tolist()打印真实列名,或在读取前配置列名修剪。 - BOM 编码干扰:Windows 导出的 UTF-8 文件常常在首字符带有不可见 BOM(
\ufeff),导致第一列列名变成\ufeffuser_id。此时只需在read_csv()中添加参数encoding='utf-8-sig'即可自动剥除 BOM 头。
3. 文件末尾有多余空行或统计信息
很多财务报表会在文件最底部附带“制表人:张三,导出时间:xxx”等说明,导致读取时最后几行字段数不匹配。处理方法如下:
# 方法一:明确知道末尾有 2 行非数据内容
df = pd.read_csv('report.csv', skipfooter=2, engine='python')

# 方法二:如果末尾只是空行,配置 skip_blank_lines=True(Pandas 默认开启)
# 方法三:遇到格式残缺的异常尾行,声明 on_bad_lines='skip' 自动跳过损坏行
df = pd.read_csv('report.csv', on_bad_lines='skip')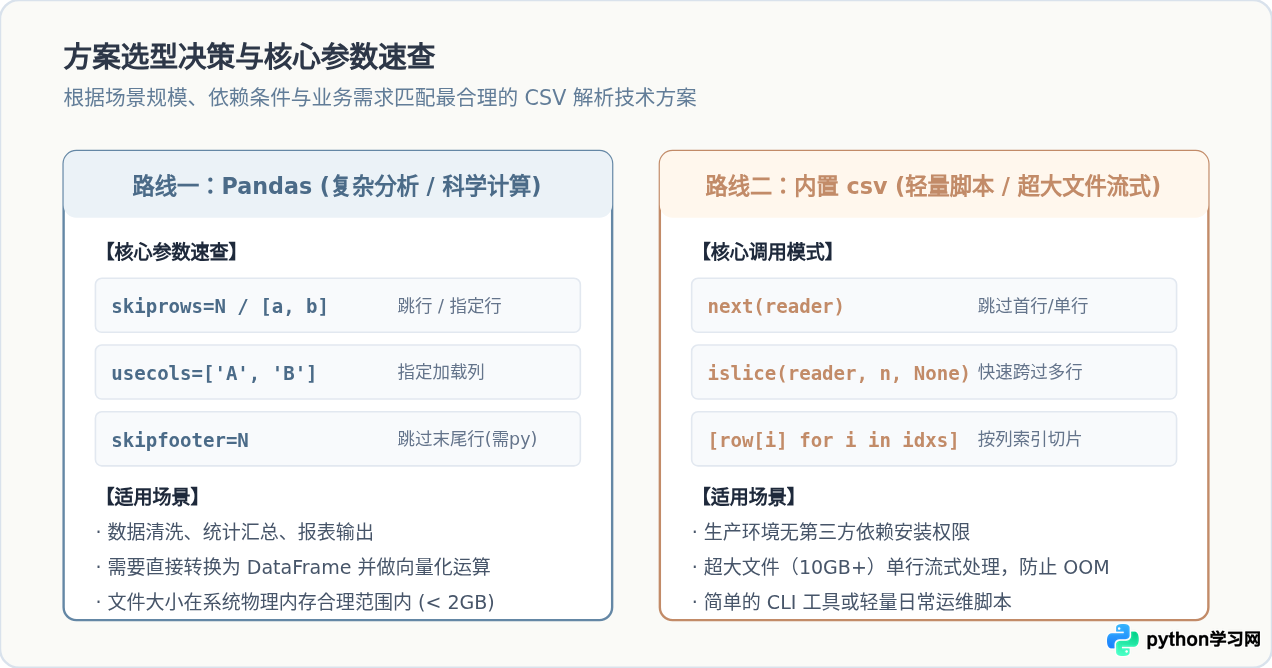
四、总结
回答“Python读取CSV时怎么指定列或跳过行”这一问题,本质是根据项目运行环境和数据规模在便捷性与轻量性之间做出恰当的选择:
| 需求场景 | 推荐方案 | 跳过行方法 | 指定列方法 |
|---|---|---|---|
| 常规数据分析与清洗 | pandas.read_csv |
skiprows=n 或 skiprows=[0,2] |
usecols=['col1', 'col2'] |
| 排除末尾统计/制表信息 | pandas.read_csv |
skipfooter=n, engine='python' |
配合 usecols 提取 |
| 超大文件(GB级)低内存流式 | 内置 csv.reader |
循环 next(reader) 或 islice |
列表推导 [row[0], row[2]] |
| 防范列顺序变动的轻量脚本 | 内置 csv.DictReader |
在初始化前通过 f.readline() 跳行 |
字典推导 {k: row[k]} |
掌握这两种思路的参数与机制后,无论是面对混有前置注释的小型报表,还是面对只有几列有价值的数十吉字节工业日志,都能在 Python 中游刃有余地完成精准提取与高效加载。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









