

Python标准库需要单独安装吗

核心结论:Python标准库不需要单独安装。官方Python在设计上秉持著名的“自带电池”(Batteries Included)哲学,在安装Python解释器的主程序时,整套标准库已经被完整打包并写入了系统磁盘。初学者无需执行任何 pip install 命令,只需在Python脚本中通过 import 语句引入即可直接使用。
一、为什么Python标准库不需要安装
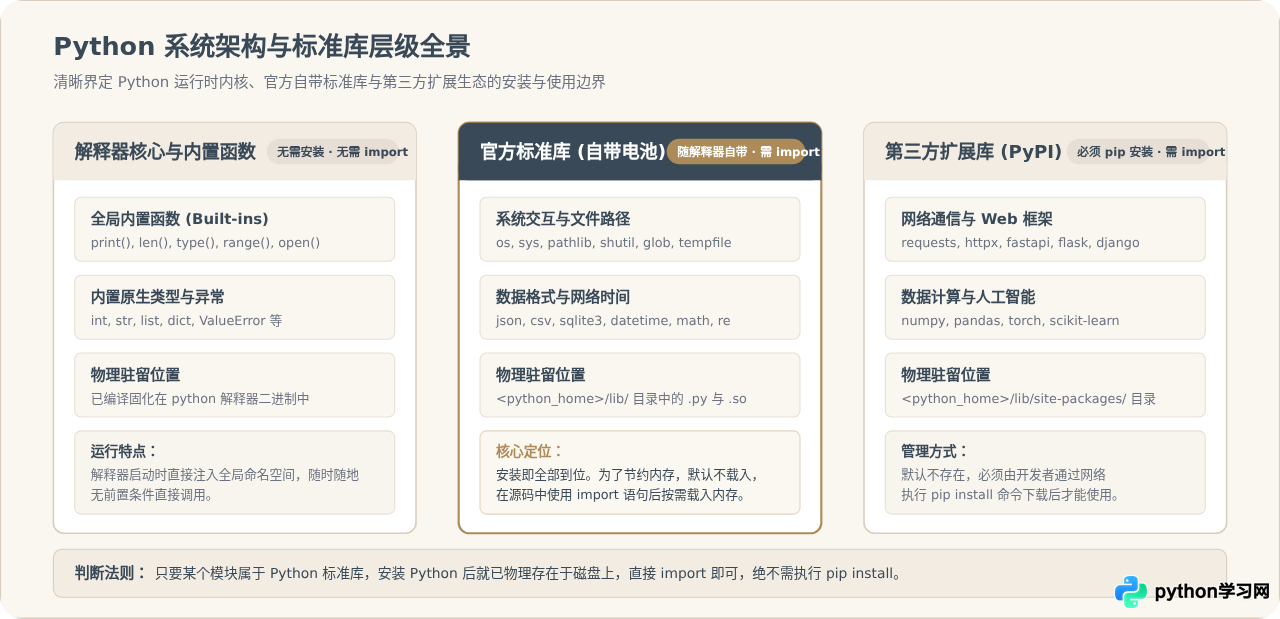
很多刚接触编程的学习者在运行代码时,常常被各种包管理工具(如 pip、conda)和环境配置困扰,容易产生一种“所有功能模块都需要单独下载安装”的误解。实际上,Python将语言功能划分为层次分明的三大部分:底层解释器与内置函数、官方标准库,以及第三方扩展库。
标准库(Python Standard Library)是Python语言官方规范的一部分。官方开发团队在发布每一个Python版本(例如 Python 3.10、3.11 或 3.12)时,都会将这套经过全面测试、具有极高向后兼容性的库同解释器打包在一起发布。无论您是在 Windows 下运行安装包,在 macOS 上使用官方 PKG,还是通过系统包管理工具安装完整版 Python,标准库代码都已经静默存放于您计算机的 Python 库目录之中。
二、标准库与“内置函数”的区别
很多初学者会疑惑:“既然标准库不用安装,为什么我不能像调用 print() 或 len() 那样,直接在代码里调用 os.path.join() 呢?”
这就涉及到 Python 的内存管理与命名空间机制:
- 内置函数(Built-in Functions):如
print()、len()、abs()、range()、open()等。它们是 Python 解释器在启动时自动注入全局命名空间(Builtin Scope)的基础函数。调用它们无需任何声明。 - 标准库模块(Standard Library Modules):如
os、sys、math、json、datetime、re等。虽然它们已经被安装在磁盘上,但为了保证 Python 解释器启动轻量、节省内存,并避免成千上万个函数名发生命名污染,它们不会在启动时自动载入内存。必须在代码中使用import显式引入。
# 内置函数:无需 import,开箱即用
text = "Hello Python"
print(len(text))  # 示例输出:12

# 标准库模块:已随 Python 安装,但必须通过 import 载入内存使用
import math
import json

result = math.sqrt(64)
print(result)  # 示例输出:8.0

data_str = json.dumps({"title": "Python标准库", "installed": True})
print(data_str)  # 示例输出:{"title": "Python标准库", "installed": true}
三、标准库的使用与验证步骤
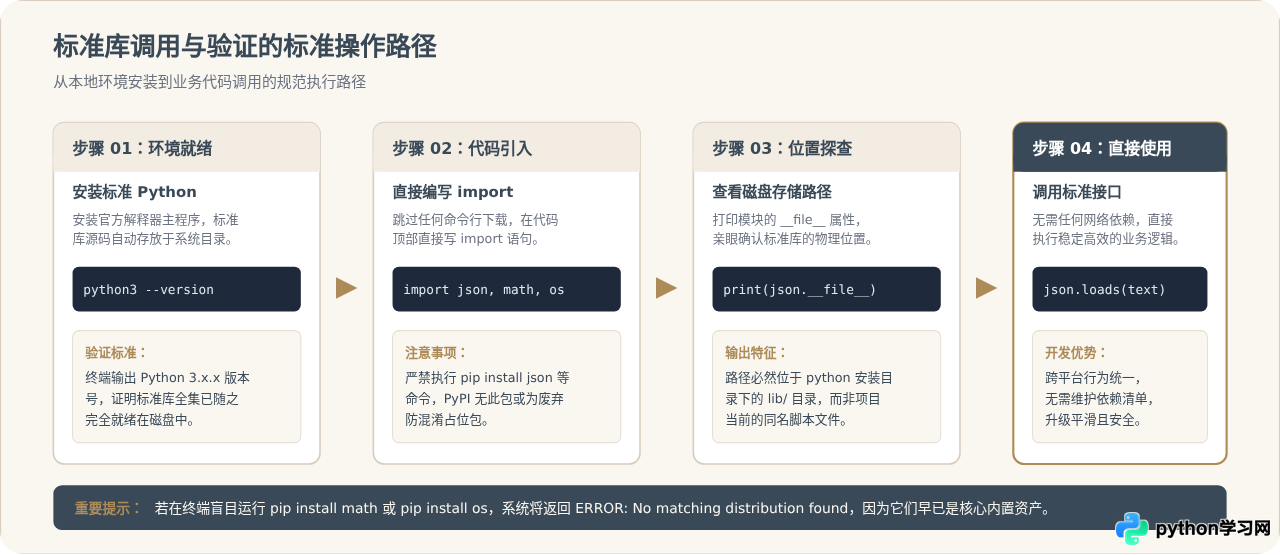
使用标准库的过程非常清晰。开发者不需要配置额外的包源镜像,不需要连网,也不需要等待下载进度。下方的流程展示了从安装 Python 到调用标准库的完整路径:
如何查看当前 Python 环境的标准库路径
如果您想了解标准库具体存放在计算机的哪个文件夹下,可以在 Python 交互环境中运行以下代码:
import os
import sys

# 查看 os 模块在磁盘上的具体路径
print(os.__file__)
# 示例输出 (macOS/Linux): /usr/local/lib/python3.11/os.py
# 示例输出 (Windows): C:\Python311\Lib\os.py

# 查看内置于解释器内核、无独立 .py 文件的核心模块列表
print(sys.builtin_module_names[:5])
# 示例输出: ('_abc', '_ast', '_codecs', '_collections', '_functools')
四、为什么有时会提示“找不到模块”或报错
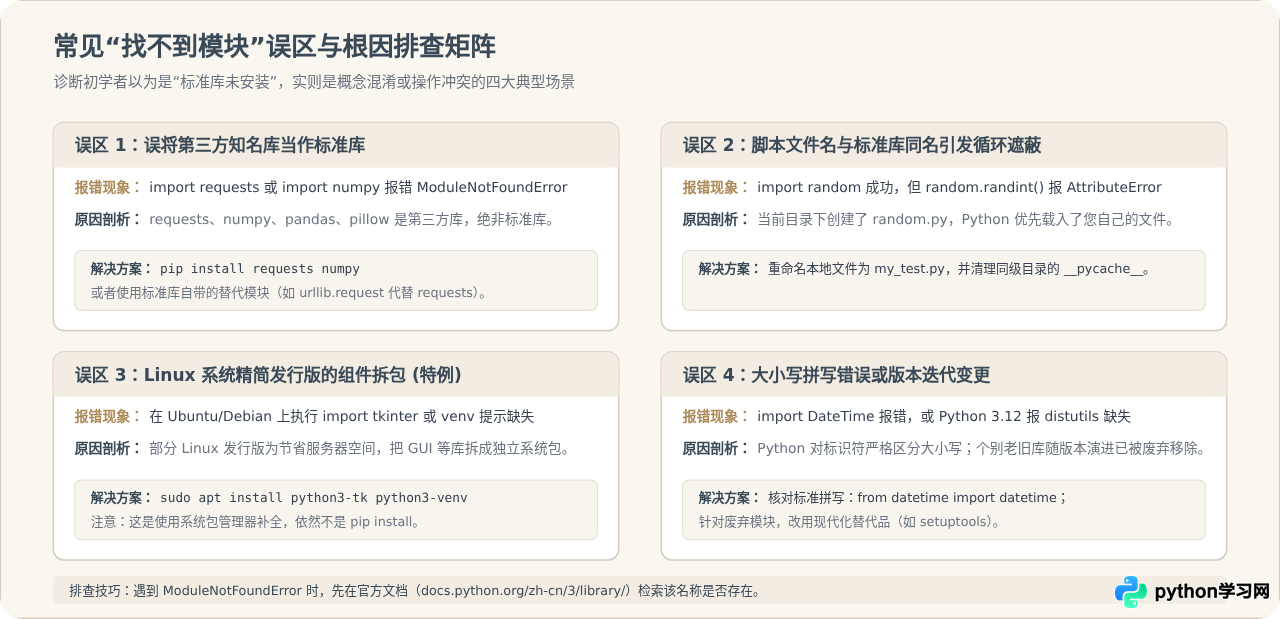
既然标准库不需要安装,为什么在实际开发中,有些开发者还是会遇到 ModuleNotFoundError: No module named 'xxx' 或 AttributeError 呢?通常是以下四种情况引起的:
常见混淆:哪些库需要 pip 安装,哪些直接 import
很多热门模块由于普及率极高,教程随处可见,以致于很多初学者误以为它们也是“标准库”。下表整理了常见功能下标准库与第三方库的对应关系:
| 功能领域 | 官方标准库(自带,无需安装) | 常用第三方库(必须 pip install) |
|---|---|---|
| HTTP 请求 / 网页抓取 | urllib.request, http.client |
requests, httpx, aiohttp |
| 数据解析与序列化 | json, csv, xml.etree |
ujson, orjson, pyyaml |
| 时间与日期处理 | datetime, time, calendar |
pendulum, arrow, dateutil |
| 数学与随机计算 | math, random, decimal |
numpy, scipy |
| 数据表格与分析 | sqlite3, collections |
pandas, polars |
| 单元测试与断言 | unittest, doctest |
pytest |
| 图形界面 (GUI) | tkinter |
PyQt5, PySide6, wxPython |
五、全景总结与开发建议
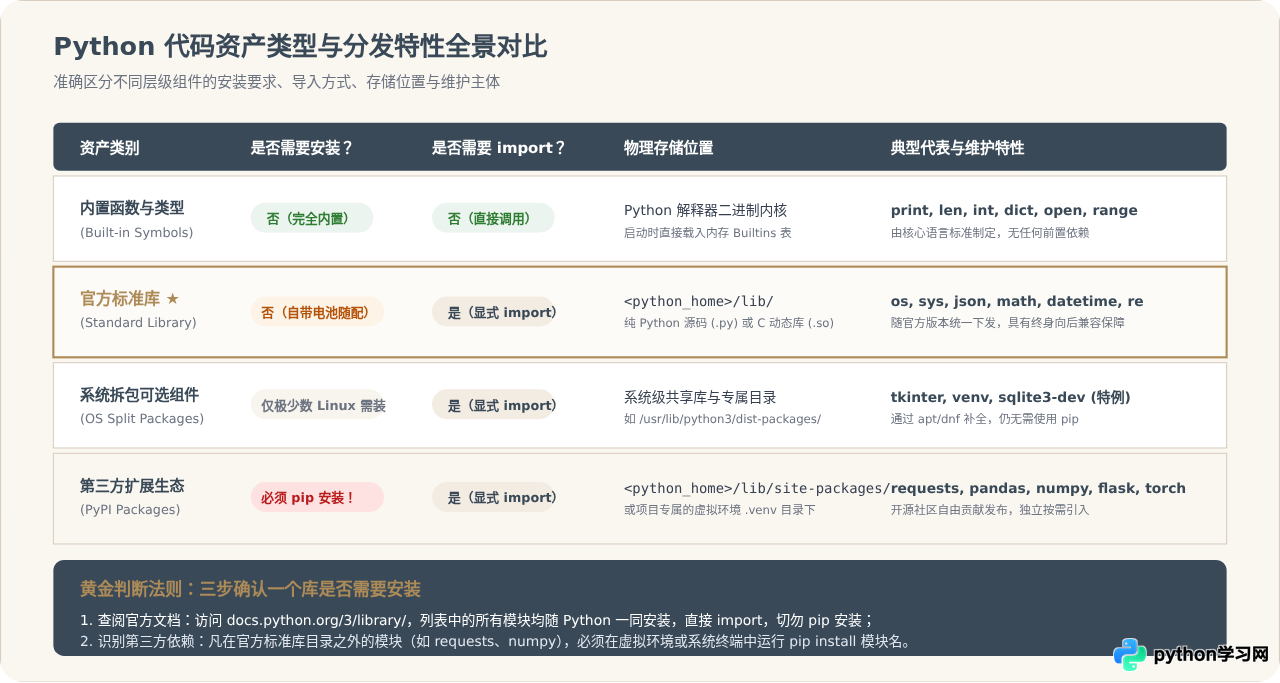
为了让开发者在面对任何 Python 库时都能胸有成竹、清晰界定,我们通过以下全景矩阵总结不同代码资产的分发方式与调用规则:
在日常编写脚本或工程开发中,请记住以下三条实用准则:
- 优先选择标准库:如果一项轻量级任务用标准库就能完成(例如简单的 HTTP 请求、JSON 读写、正则匹配、路径拼接),优先使用
urllib、json、re和pathlib。这样能使您的项目保持“零外部依赖”,无需担心依赖包版本冲突,在任何新安装的 Python 环境中均可即刻运行。 - 不要对标准库执行 pip:标准库模块不存在独立的 PyPI 发布源。若强行执行
pip install json等命令,可能遭遇不存在的报错,或者误安装第三方的同名投毒/占位包。 - 避免脚本同名冲突:练习写代码时,绝不要把自己的脚本文件命名为
random.py、math.py、string.py或json.py,这会导致当前项目中的import优先加载您的本地文件,从而破坏标准库的正常调用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









