

企业级大模型应用开发:数据隐私保护与本地化部署方案

把公司的财务报表、客户名单或者核心代码扔进公共的大模型API里,很多CTO的第一反应是心跳加速。虽然服务商都承诺不训练用户数据,但在金融、医疗或法律这些强监管行业,“数据不出域”往往是一条不可逾越的红线。
其实,现在的开源生态已经足够成熟,完全可以在公司内部搭建一套“看得见、摸得着”的私有大脑。这不仅仅是把模型下载下来跑起来那么简单,更关键的是如何在保证响应速度的同时,把权限控制和数据隔离做扎实。
选对模型与量化:在显存和智商间找平衡
本地部署最大的拦路虎通常是硬件成本。很多人以为必须买满配H800才能跑大模型,其实对于大多数企业内部问答场景,7B到14B参数量的模型经过量化后,单张消费级显卡就能胜任。
目前Llama 3、Qwen 2或ChatGLM3等开源模型都有很好的中文支持。重点在于“量化”,也就是用精度换空间。INT4量化通常能在几乎不损失对话逻辑能力的前提下,将显存占用减半。比如一个7B模型,FP16精度需要约14GB显存,而INT4只需要4-5GB,这意味着你可以用一张RTX 4090甚至更旧的显卡启动服务。
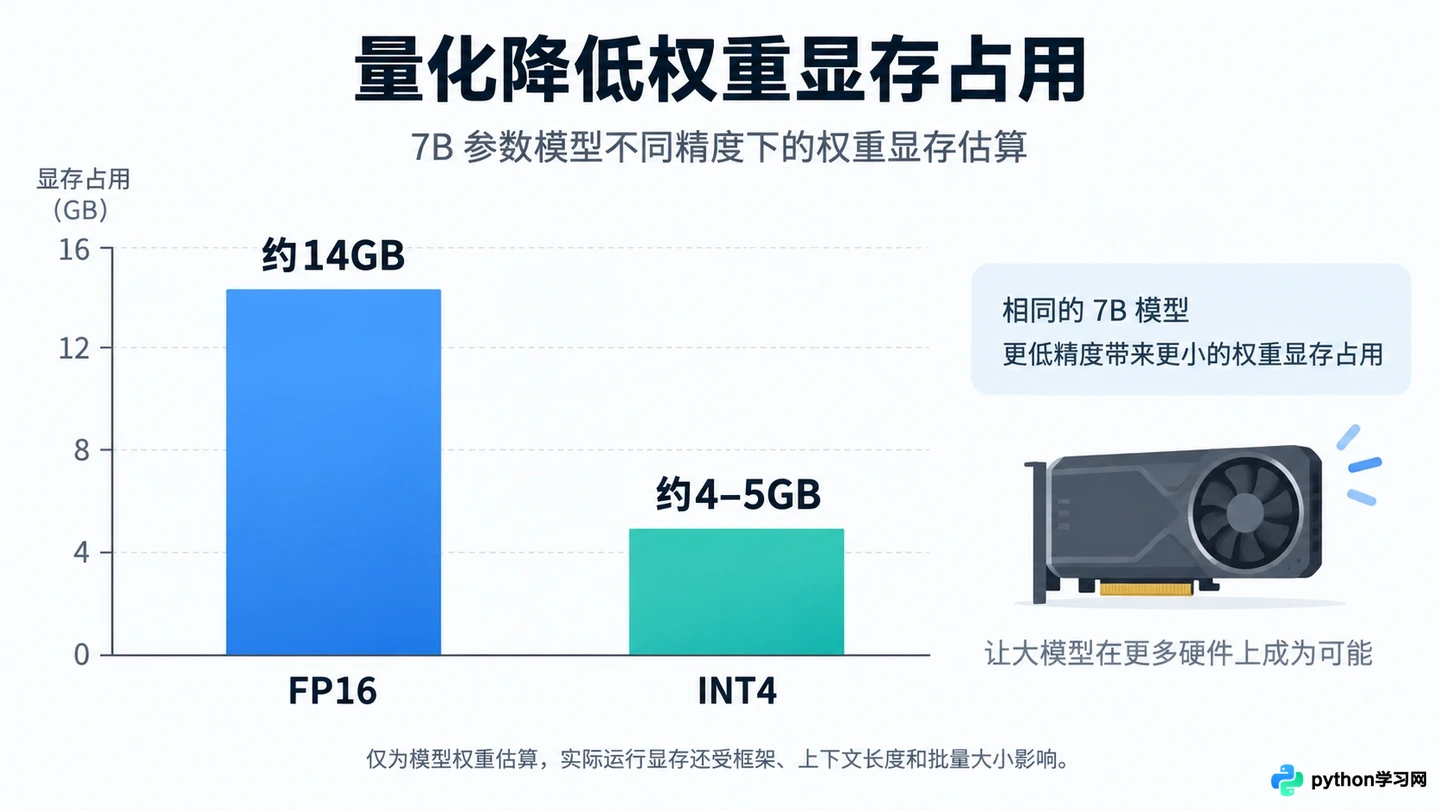
INT4量化显著降低显存门槛,使消费级显卡也能运行主流开源模型
在工具选择上,Ollama是目前最友好的入门方案,它封装了底层的llama.cpp,一条命令就能拉起服务。如果追求更高的并发吞吐量,vLLM则是生产环境的首选,它支持PagedAttention技术,能显著降低显存碎片,让同样的硬件支撑更多用户同时提问。
构建RAG架构:让模型只说“知道”的事
光有模型还不够,企业应用的核心价值在于私有知识。直接微调模型不仅成本高,还容易产生“幻觉”。更靠谱的做法是RAG(检索增强生成),即把文档切片存入向量数据库,提问时先检索相关片段,再交给模型总结。
这里有一个常被忽视的细节:检索阶段的权限过滤。不能简单地建立一个巨大的向量库让所有人查,否则实习生可能搜到高管的薪资结构。
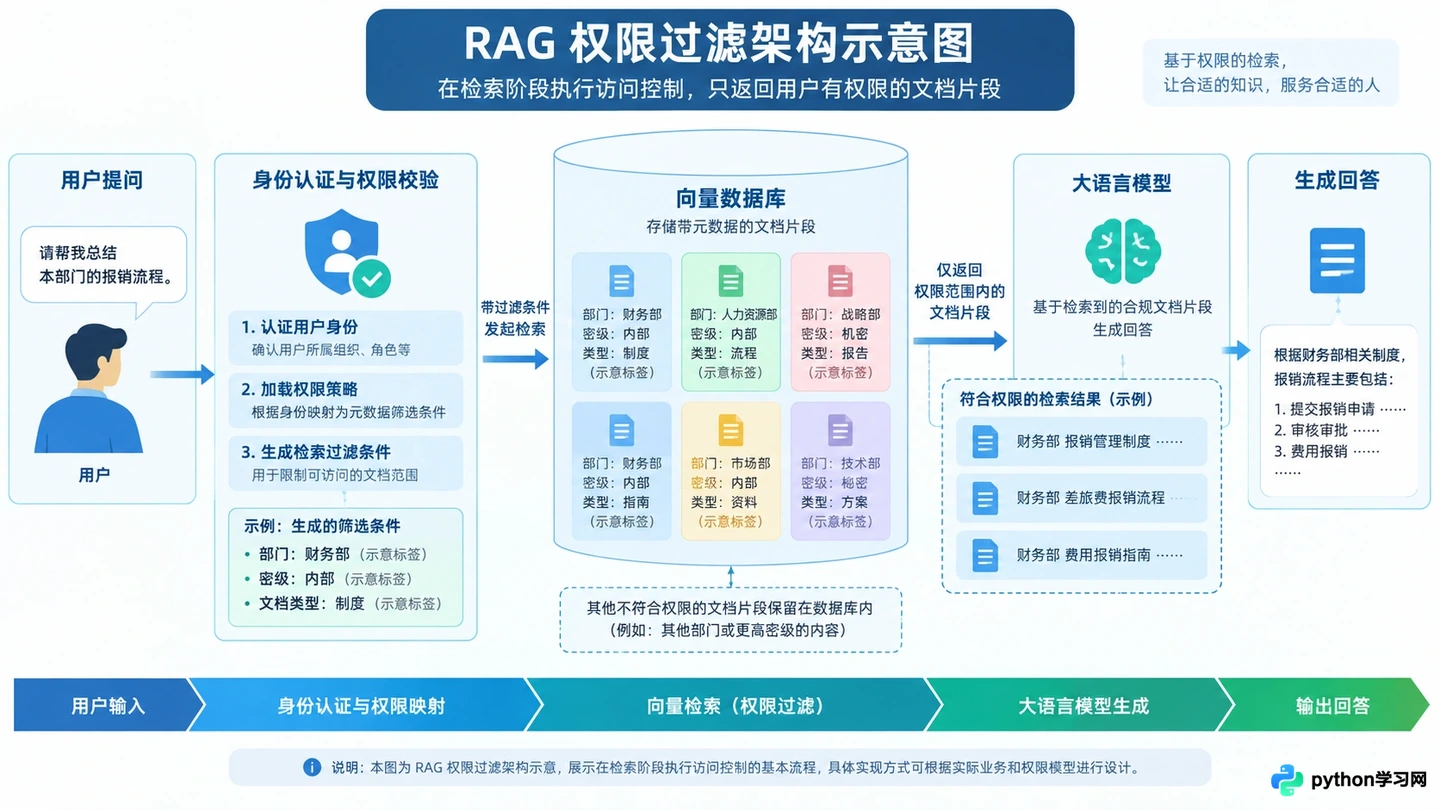
在向量检索阶段加入用户身份元数据过滤,确保数据隔离
正确的做法是在向量化入库时,给每个文本块打上“部门”或“密级”标签。当用户发起查询时,系统先获取当前用户的身份标识,在向量数据库检索语句中强制加入元数据过滤条件。这样,模型接收到的上下文永远是经过权限清洗的安全数据,从源头上杜绝越权访问。
接口网关与审计:守住最后一道门
模型跑通了,不代表应用就安全了。企业内部可能有多个业务系统调用同一个大模型服务,这时候需要一个统一的API网关来做流量控制和内容风控。
网关层主要做两件事:一是输入输出过滤,拦截包含敏感关键词(如身份证号、特定项目代号)的请求;二是完整的日志审计。每一次提问、引用的文档片段以及模型的最终回答,都需要结构化存储。
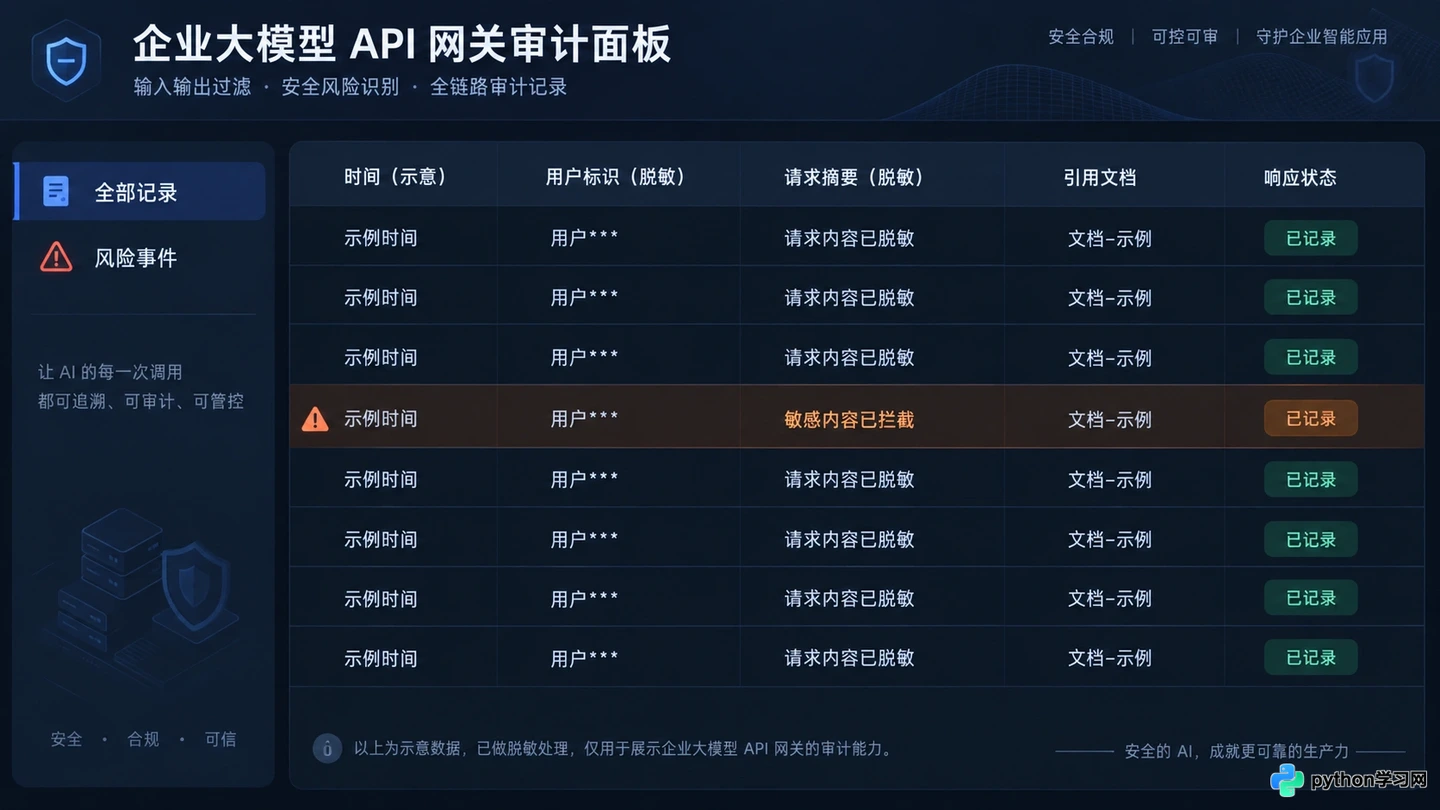
结构化记录每次交互的输入、引用源及输出,便于合规审计
这不仅是为了事后追溯,更是为了优化模型表现。通过分析日志,你可以发现哪些文档被频繁引用但效果不佳,进而调整切片策略或补充缺失的知识库内容。对于敏感操作,还可以设置人工审核环节,确保高风险回答不会直接触达终端用户。
部署形态的取舍
最后,关于部署位置,混合云往往比纯本地更现实。核心敏感数据留在本地服务器,运行小参数量的专用模型;而对于通用的创意写作或代码辅助,可以通过脱敏后调用云端大模型。
这种分层架构既满足了合规要求,又避免了重复造轮子。技术团队不需要一开始就追求大而全,先从某个具体部门的知识库助手做起,跑通“数据入库-权限检索-安全回答”的闭环,再逐步扩展到全公司,才是更稳妥的路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









