

通义千问API支持离线调用吗?与开源Qwen部署的区别

刚把代码跑起来,拔掉网线或者断开Wi-Fi,程序立刻报错“Connection refused”或者“Timeout”。这时候很多人会疑惑:我买的不是智能模型吗?怎么连不上网就变砖了?
其实问题出在对“API”这个词的理解上。通义千问API本质上是一个远程服务接口,你的电脑只是发送请求的终端,真正的大脑——也就是庞大的模型参数和推理算力,都远在阿里云的数据中心里。
所以,第一个结论很明确:通义千问API不支持离线调用。只要是用API Key鉴权的方式,就必须保持稳定的网络连接。
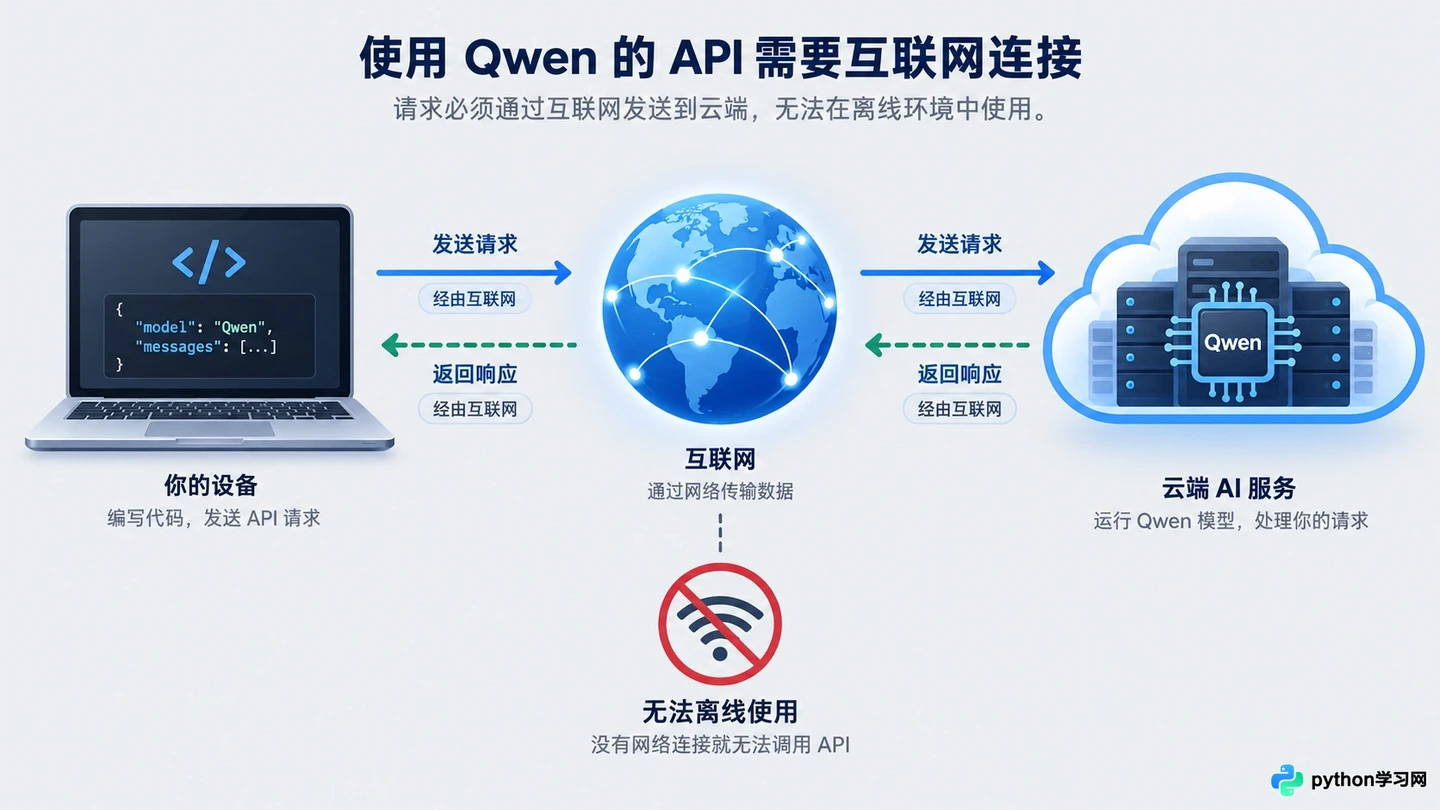
API调用必须经过互联网连接云端服务器
如果你因为数据安全、内网环境或者延迟敏感等原因,确实需要“离线”使用大模型,那你需要走的不是API通道,而是另一条路:下载并部署开源的Qwen模型。
这两者虽然同源,但在使用体验和维护逻辑上完全是两回事。
API调用:省心但必须在线
使用通义千问API就像是用自来水。你不需要知道水厂在哪里,也不用关心水管怎么铺,只要拧开龙头(发送HTTP请求),水(生成结果)就来了。
这种方式的最大优势是零维护。你不用买昂贵的GPU服务器,不用配置CUDA环境,也不用担心显存溢出。阿里云负责所有的硬件升级、模型优化和高可用保障。
但代价也很明显:
- 强依赖网络:没有互联网连接,服务不可用。
- 数据出域:你的提示词和返回结果需要经过公网传输到云端。虽然大厂有严格的安全合规流程,但对于金融、医疗等对数据隐私极度敏感的场景,这依然是一个需要评估的风险点。
- 按量计费:用得越多,费用越高,长期高频调用可能比自建服务器更贵。
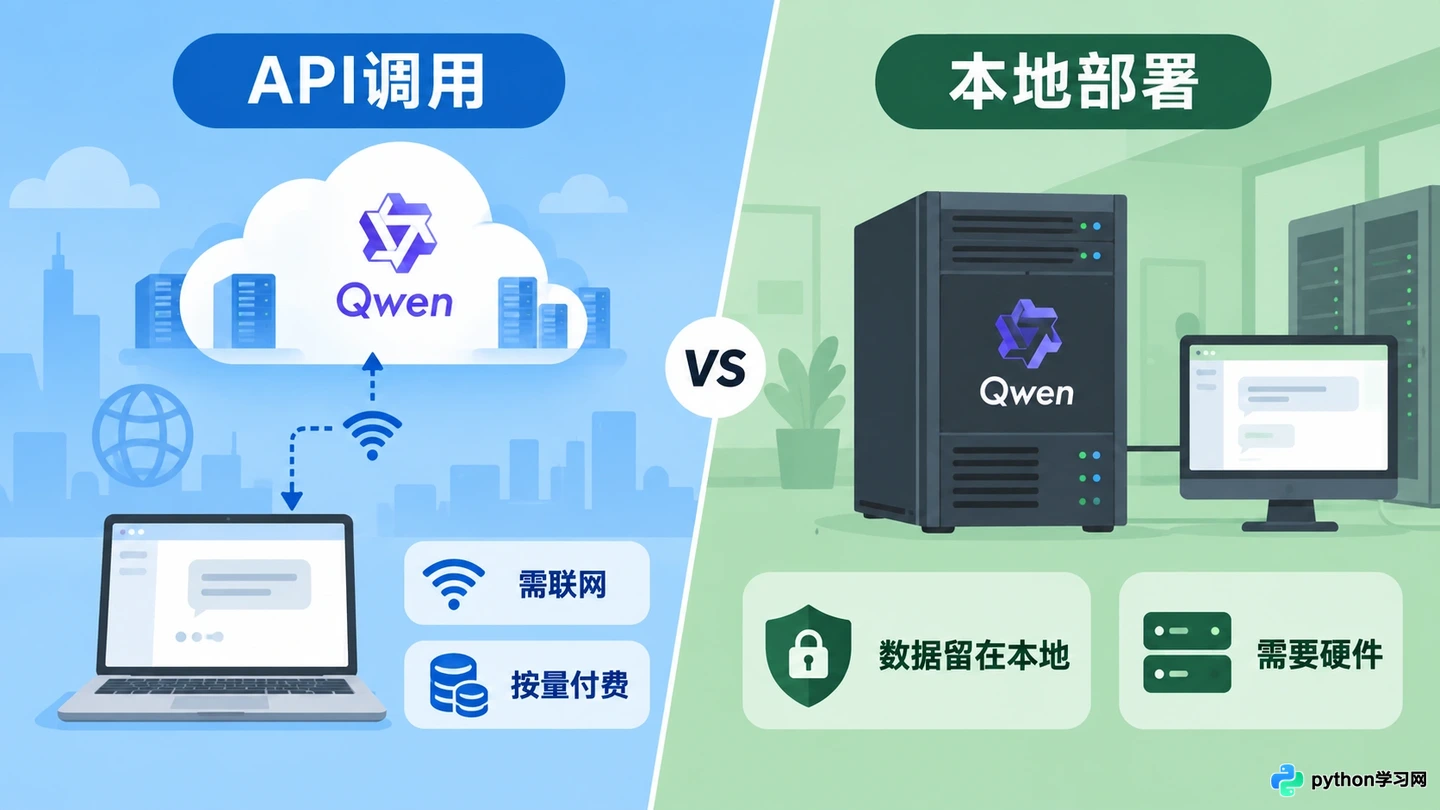
API服务与本地部署的核心差异对比
开源Qwen部署:自由但门槛高
如果你希望模型完全运行在自己的电脑上或公司内网服务器里,断网也能跑,那就需要去Hugging Face或ModelScope下载Qwen的开源权重文件。
这时候,你不再是“用户”,而是变成了“运维”。
你需要自己准备硬件。运行一个7B参数的模型,至少需要一张显存够大的显卡;如果是72B这样的大参数版本,可能需要多卡互联甚至专门的推理集群。接着,你要安装Ollama、vLLM或者Transformers库,把模型加载进显存。
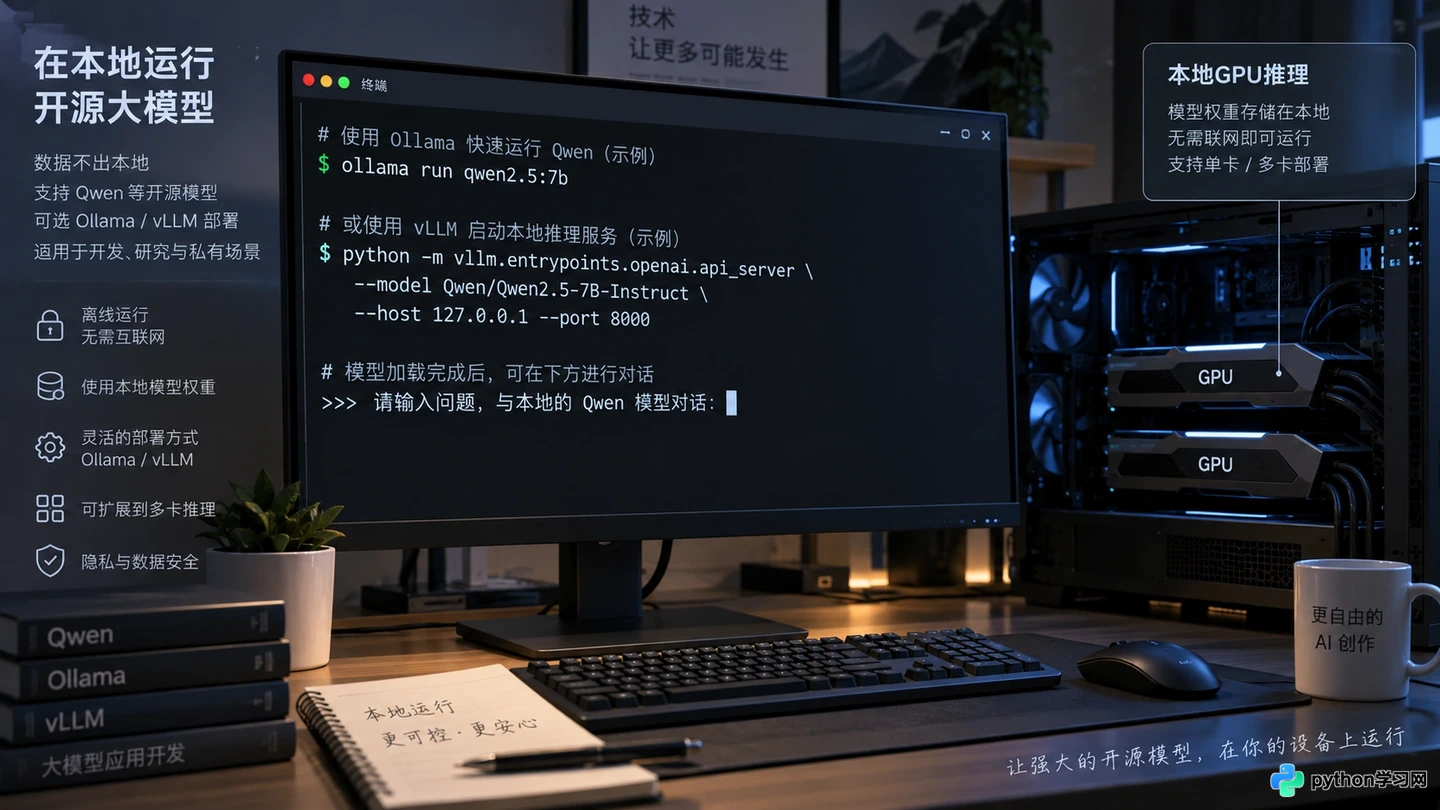
本地服务器运行开源Qwen模型的终端界面
一旦部署成功,好处是立竿见影的:
- 完全离线:局域网甚至单机即可运行,无惧网络波动。
- 数据隐私:所有数据都在本地闭环,不出内网,满足最严格的合规要求。
- 可定制性:你可以对模型进行微调(Fine-tuning),让它更懂你的行业术语,这是通用API很难做到的深度定制。
但麻烦也随之而来:显卡驱动冲突、显存不足报错、推理速度慢、服务宕机重启……这些技术问题都需要你自己或团队来解决。
该怎么选?看这三个关键点
面对这两种方式,不用纠结技术名词,直接看你的实际场景:
1. 看网络环境 如果你的应用必须在外网访问,或者开发环境本身就在云上,直接用API最快。如果是在封闭的内网、涉密单位,或者边缘设备(如机器人、车载系统)上,只能选本地部署开源模型。
2. 看数据敏感度 如果只是用来写写文案、查查资料,API完全够用且方便。如果处理的是客户身份证号、病历、核心代码库等敏感信息,且公司规定数据不得出境或上云,那么本地部署是唯一合规的选择。
3. 看技术储备与预算 没有专门的AI运维团队,也不想折腾服务器,选API。如果有现成的GPU资源,且有工程师能搞定环境配置和后续维护,本地部署在长期大规模调用下可能更具成本效益。
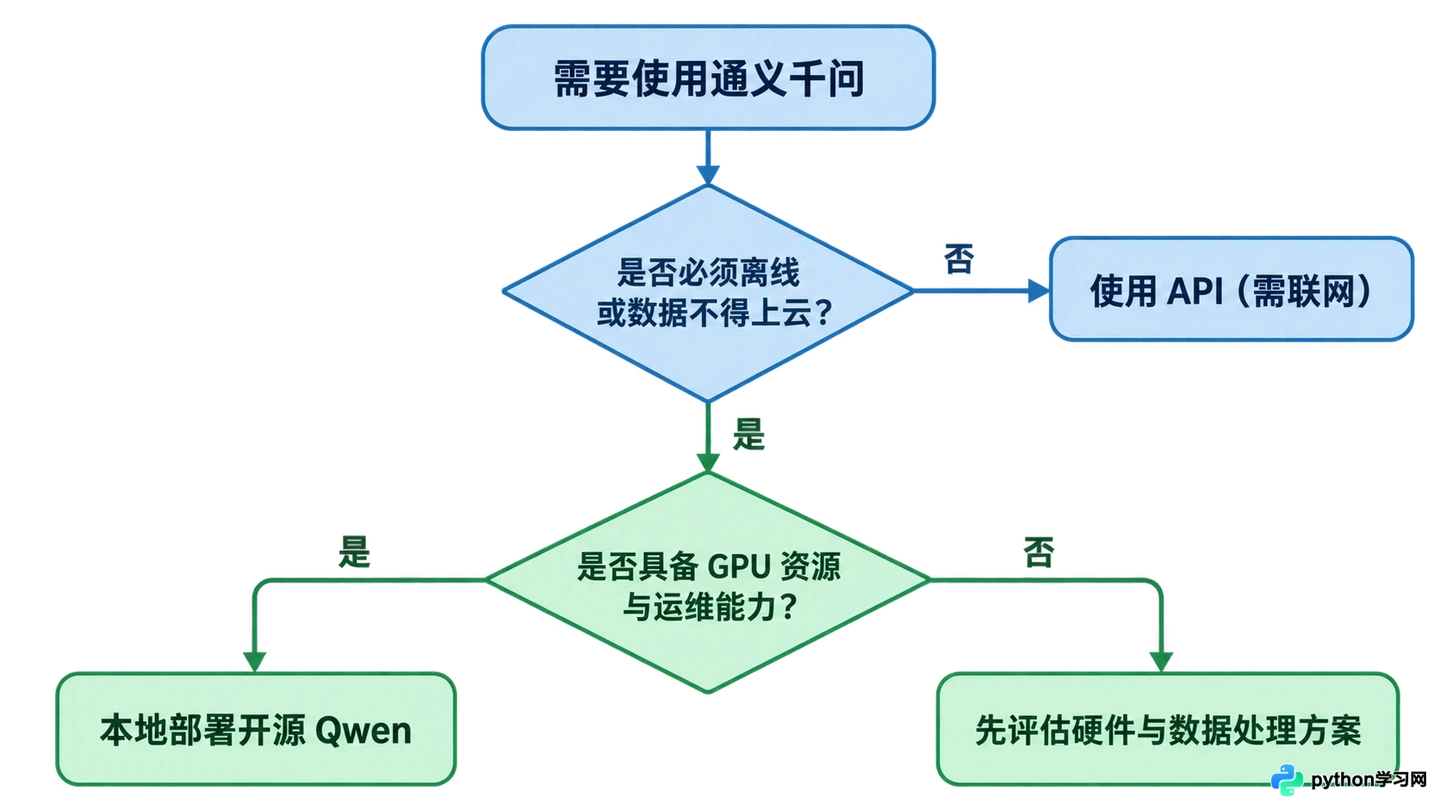
根据需求选择API或本地部署的决策路径
简单来说,想要“开箱即用”且能接受联网,就选通义千问API;想要“数据私有”且具备技术能力,就下载Qwen开源模型自己搭。
别指望给API传个参数就能让它离线工作,那是两个不同的产品形态。理清这个界限,能帮你少走很多配置环境的弯路。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









