

Python中is与==、/与//有什么区别?易混淆运算符对比解析

在 Python 中,is 与 ==、/ 与 // 是两对形式相似但运作机制截然不同的运算符。简而言之:is 检查两个变量是否指向同一个内存地址(身份同一性),而 == 检查两个变量的内容与值是否相等;/ 始终执行真浮点除法并返回浮点数,而 // 执行向下取整的地板除法(Floor Division),朝负无穷方向取整。搞混这两对符号是导致 Python 条件判断失效及数值运算隐蔽偏差的常见根源。
一、is 与 == 的本质区别:身份同一性 vs 数值相等性
理解 is 与 == 的区别,核心在于分清 Python 中对象的“身份(Identity)”与“数值(Value)”。每一个 Python 对象在内存中创建后,都具备唯一的内存地址编号(可通过内置函数 id() 查看),同时具备其存储的数据内容。
== 是比较运算符,调用的是对象内置的 __eq__() 方法。它关心的是“两个容器里的东西是不是等价的”。只要两者的值或业务规则匹配,比较结果就为 True。
is 是同一性运算符。它比较的是两个对象的物理引用,等价于比较 id(a) == id(b)。它关心的是“这两个变量名是不是贴在同一个物理内存对象上的标签”。
# 示例:列表对象对比
list_a = [1, 2, 3]
list_b = [1, 2, 3]
list_c = list_a

print(list_a == list_b)  # 输出: True  (内容完全相同)
print(list_a is list_b)  # 输出: False (各自在内存中分配独立空间)
print(list_a is list_c)  # 输出: True  (list_c 引用了与 list_a 相同的对象)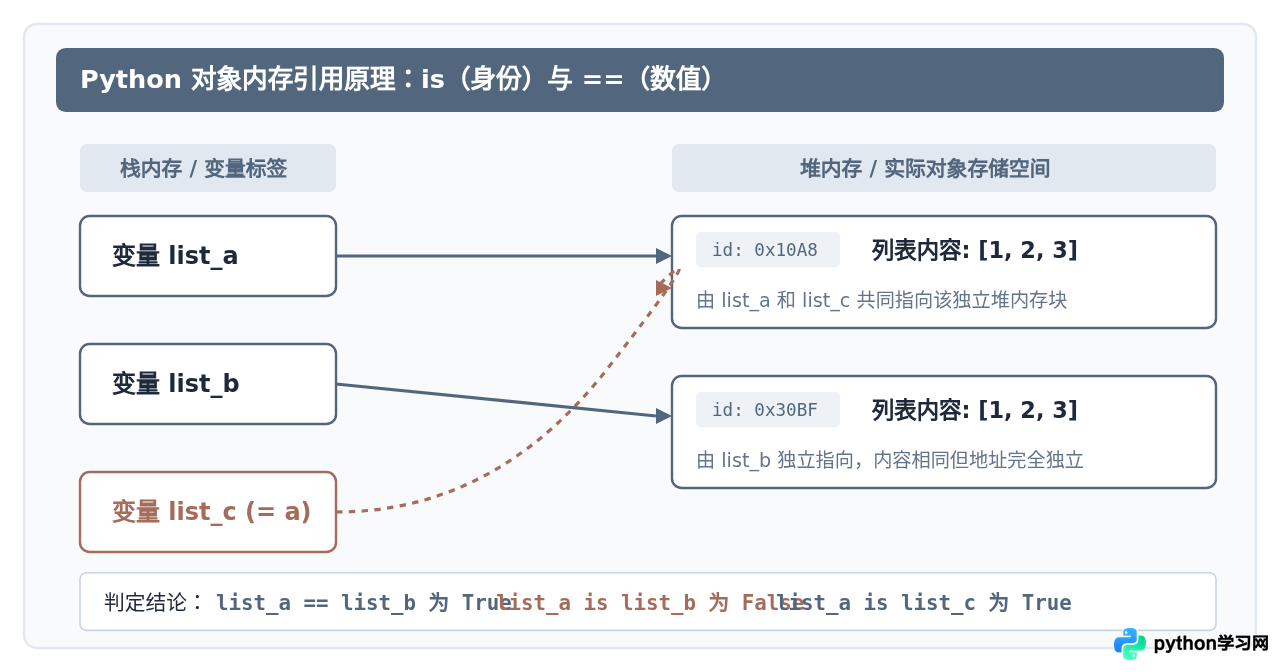
小整数池与驻留机制引起的常见陷阱
初学者在测试数字或字符串时,经常会遇到令人困惑的现象:
x = 100
y = 100
print(x is y)  # 输出: True

m = 1000
n = 1000
print(m is n)  # 交互式命令行中常输出: False (脚本或代码块中可能被常量折叠优化)
为什么 100 is 100 成立,而 1000 is 1000 可能为 False?这是 CPython 运行时的性能优化机制导致的:
小整数对象池:CPython 解释器在启动时预先创建并缓存了 [-5, 256] 范围内的所有整数对象。任何时刻赋值该范围内的数字,Python 都会直接复用已有单例对象的内存地址。因此在这个范围内 is 返回 True。超出此范围的大整数,通常会新建对象,内存地址各不相同。
字符串驻留(Interning):符合标识符规则的短字符串往往会被自动驻留共享。但若带有特殊字符或由运行时动态拼接生成,则不会驻留。
is 来比较数字大小或字符串相等性!底层缓存优化属于解释器实现细节,不能作为业务逻辑的判断依据。只要比较的是数值或内容,必须始终使用 ==。
is 的正确使用场景:与单例对象比较
在 Python 中,is 最经典、最标准的用途是用于判断变量是否为单例对象,特别是 None:
# 推荐的标准写法(PEP 8 推荐)
if result is None:
    pass

if flag is not None:
    pass

# 不要写成 if result == None:
# 因为某些自定义类可能重写了 __eq__ 方法,导致 == None 产生意外的计算开销或返回伪结果。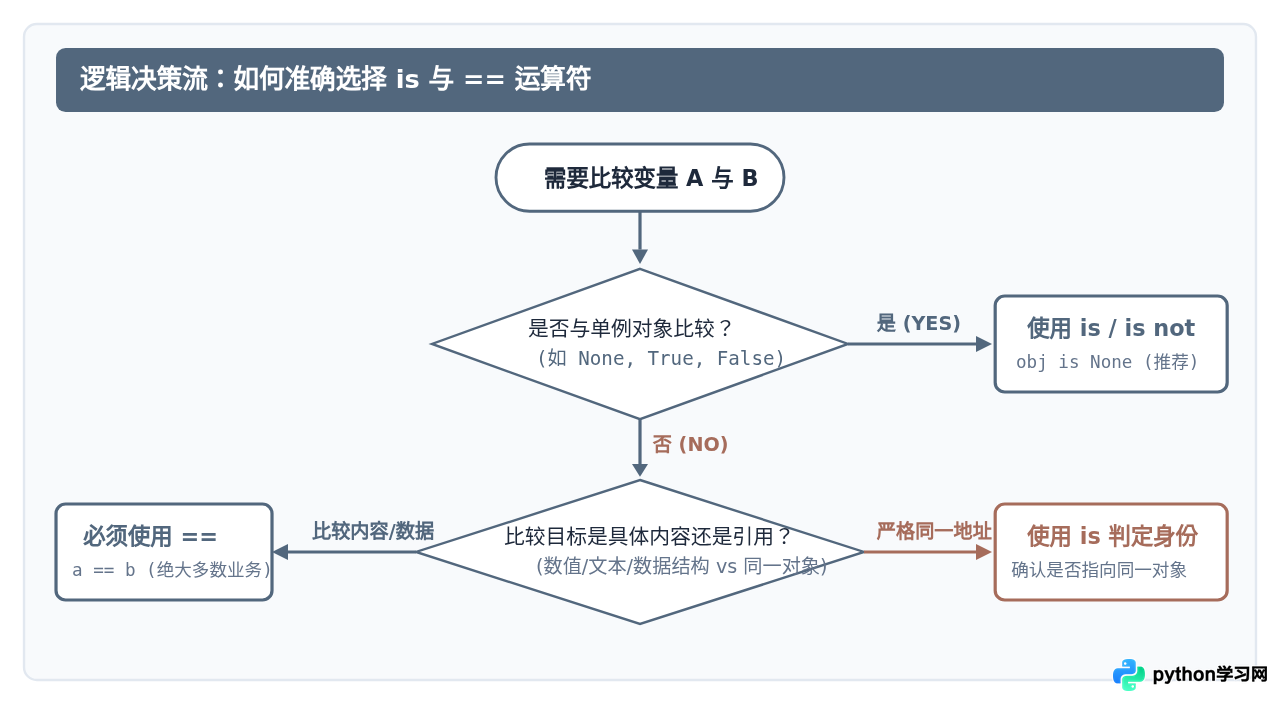
二、/ 与 // 的关键区别:真除法 vs 地板除(向下取整)
在 Python 3 中,除法运算符彻底解决了 Python 2 中整型相除截断的遗留历史问题,明确划分了 / 与 // 的职责:
/(真除法 / 浮点除法):不论操作数是整型还是浮点型,返回值永远是 float 类型。即使能够整除(例如 4 / 2),计算结果也必定是 2.0 而不是整数 2。
//(地板除 / 整除):其底层执行的是数学上的取整运算(Floor Division),即向数轴负无穷方向取最接近的整数。如果参与运算的操作数全为整数,返回 int;如果有任意一个操作数是浮点数,返回的是浮点格式的整数值(如 3.0)。
# 正数除法示例
print(7 / 2)    # 输出: 3.5  (float)
print(4 / 2)    # 输出: 2.0  (float,保留浮点类型)
print(7 // 2)   # 输出: 3    (int,向下取整)
print(7.0 // 2) # 输出: 3.0  (float,保留浮点表示)
最容易踩坑的盲区:负数除法运算
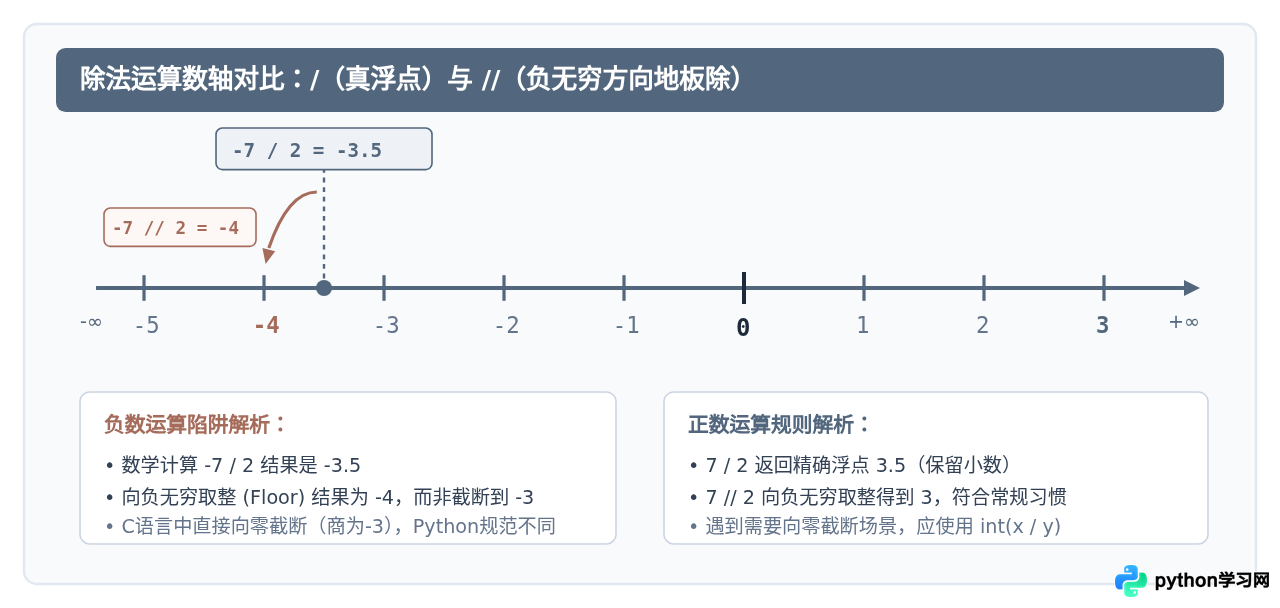
许多开发者习惯将 // 理解为“直接抹掉小数点(向零截断)”,这在正数运算时恰好吻合,但一旦遇到负数就会出现严重计算逻辑错误:
# 负数运算对比
print(-7 / 2)   # 输出: -3.5 (标准浮点运算)
print(-7 // 2)  # 输出: -4   (注意:不是 -3,而是 -4!)
这是因为:数学上 -7 / 2 = -3.5。在数轴上,-3.5 的左侧(朝负无穷大方向)最接近的整数是 -4,右侧才是 -3。由于 // 采用 floor() 规则,因此结果严格向下舍入为 -4。
Python 之所以采用这一设计,是为了始终维持取模运算符 % 与除法运算符之间的代数一致性公理:a = (a // b) * b + (a % b)。
三、四种运算符全面对比与速查矩阵
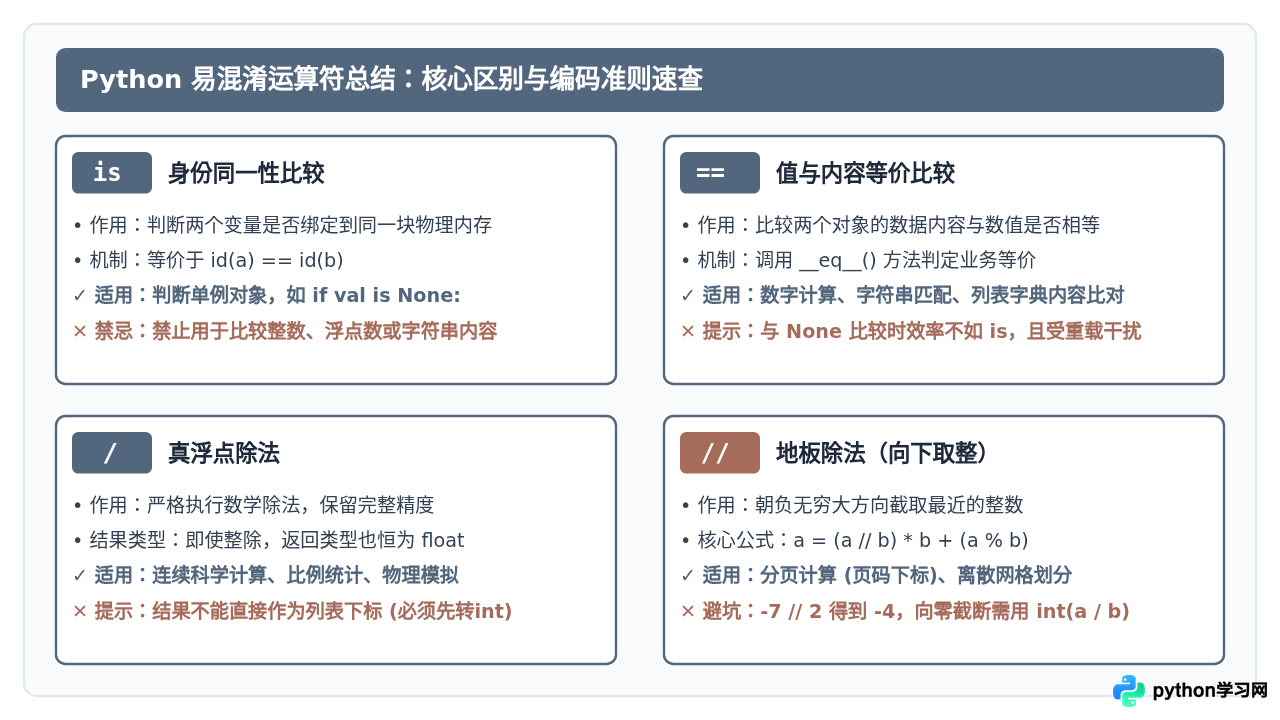
为了帮助读者在编写条件判断与数值计算逻辑时快速决策,以下将 is、==、/、// 四种运算符的核心特性进行系统横向对比:
| 运算符 | 运算本质 | 底层协议方法 | 返回值类型 | 常见混淆与潜在隐患 |
|---|---|---|---|---|
is |
物理内存对象同一性 | 比较 id(a) == id(b) |
bool |
误用于数字或字符串值比较;受小整数池干扰产生偶然一致假象 |
== |
数据内容与值等价性 | 调用 __eq__() |
bool |
与单例 None 比较时效率较低且可能被自定义类的 __eq__ 污染 |
/ |
真浮点除法 | 调用 __truediv__() |
固定返回 float |
即使是能整除的操作(如 4/2)也返回浮点数 2.0,不能直接作整数下标 |
// |
地板除(向负无穷取整) | 调用 __floordiv__() |
操作数全为 int 则返回 int,否则返回 float |
负数除法向下舍入为更小负数(如 -7//2 为 -4 而不是 -3) |
四、工程实践中的典型代码模式
在实际生产工程中,遵循规范的代码书写习惯能有效规避上述所有混淆陷阱:
1. 空值与状态检验
# 正确范式
if response is None:
    return "无响应"

# 错误或低效范式
if response == None:   # 易引发自定义 __eq__ 误判
    return "无响应"
2. 分页总页数计算
total_count = 105
page_size = 20

# 推荐:使用地板除配合向上取整逻辑
total_pages = (total_count + page_size - 1) // page_size
print(f"总页数: {total_pages}")  # 输出: 6 (结果为整数 int)

# 避免写成:
# total_pages = total_count / page_size  # 输出 5.25,无法直接用于循环分页
3. 需要截断取整而非地板整除的场景
# 若业务上需要“直接截掉小数部分”(例如处理金融或绝对偏差值)
value = -3.7

# 使用 int() 执行向零截断
print(int(value))      # 输出: -3

# 使用 // 是地板舍入
print(int(value // 1)) # 输出: -4 (请明确业务需求选择)
通过掌握“is 查内存、== 比内容”、“/ 保浮点、// 向负无穷取整”这两组底层铁律,就能在日常 Python 编程与算法实现中保持清晰精确的逻辑表达。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









