

DeepSeek与Llama 3、Qwen对比:中文理解与代码能力评测

在开源大模型快速迭代的当下,选择一款适合自身业务场景的基础模型成为许多开发者和企业的首要任务。DeepSeek、Llama 3与Qwen作为当前关注度极高的代表,各自拥有鲜明的技术路线与优势领域。Llama 3凭借Meta强大的生态基础占据通用英语场景的主导地位,Qwen依托阿里体系在中文商业应用上深耕已久,而DeepSeek则以极致的推理能力和代码专长异军突起。本文将从中文理解、代码能力及推理速度三个核心维度,对这三款模型进行直观的横向对比,梳理它们在实际应用中的竞争力边界。
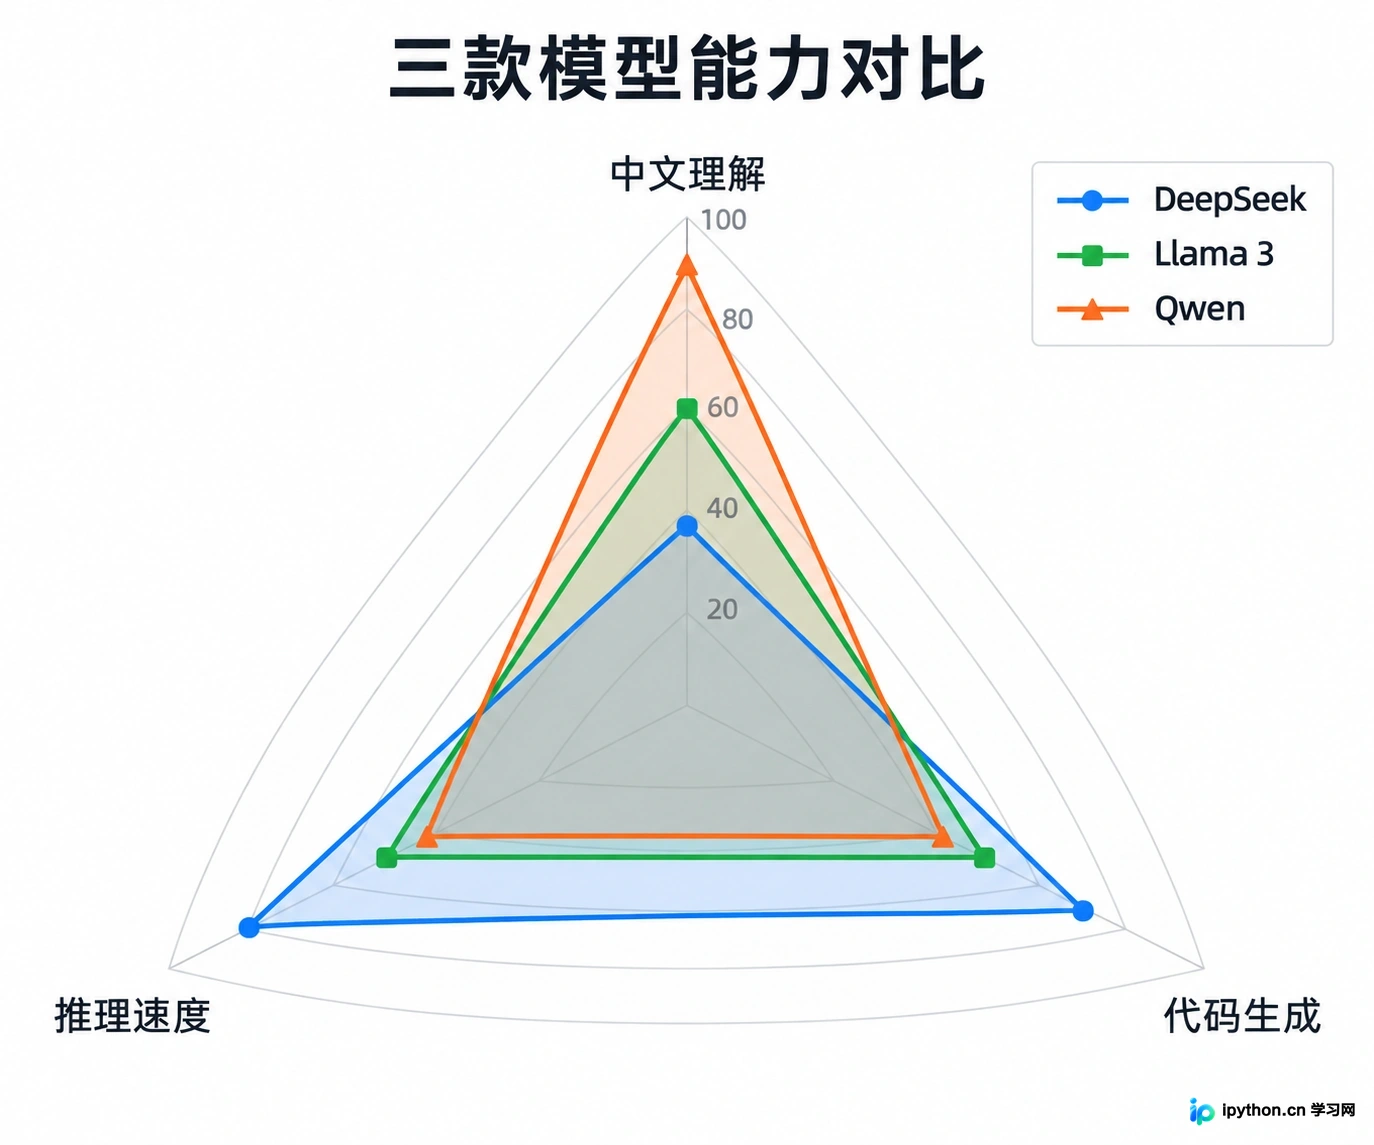
三款模型在中文理解、代码能力、推理速度维度的能力雷达对比
关于中文语境的理解与适配
中文不仅是语言符号的组合,更包含复杂的语义歧义、文化隐喻及长文本逻辑。在这一维度上,原生训练数据的分布决定了模型的“语感”。
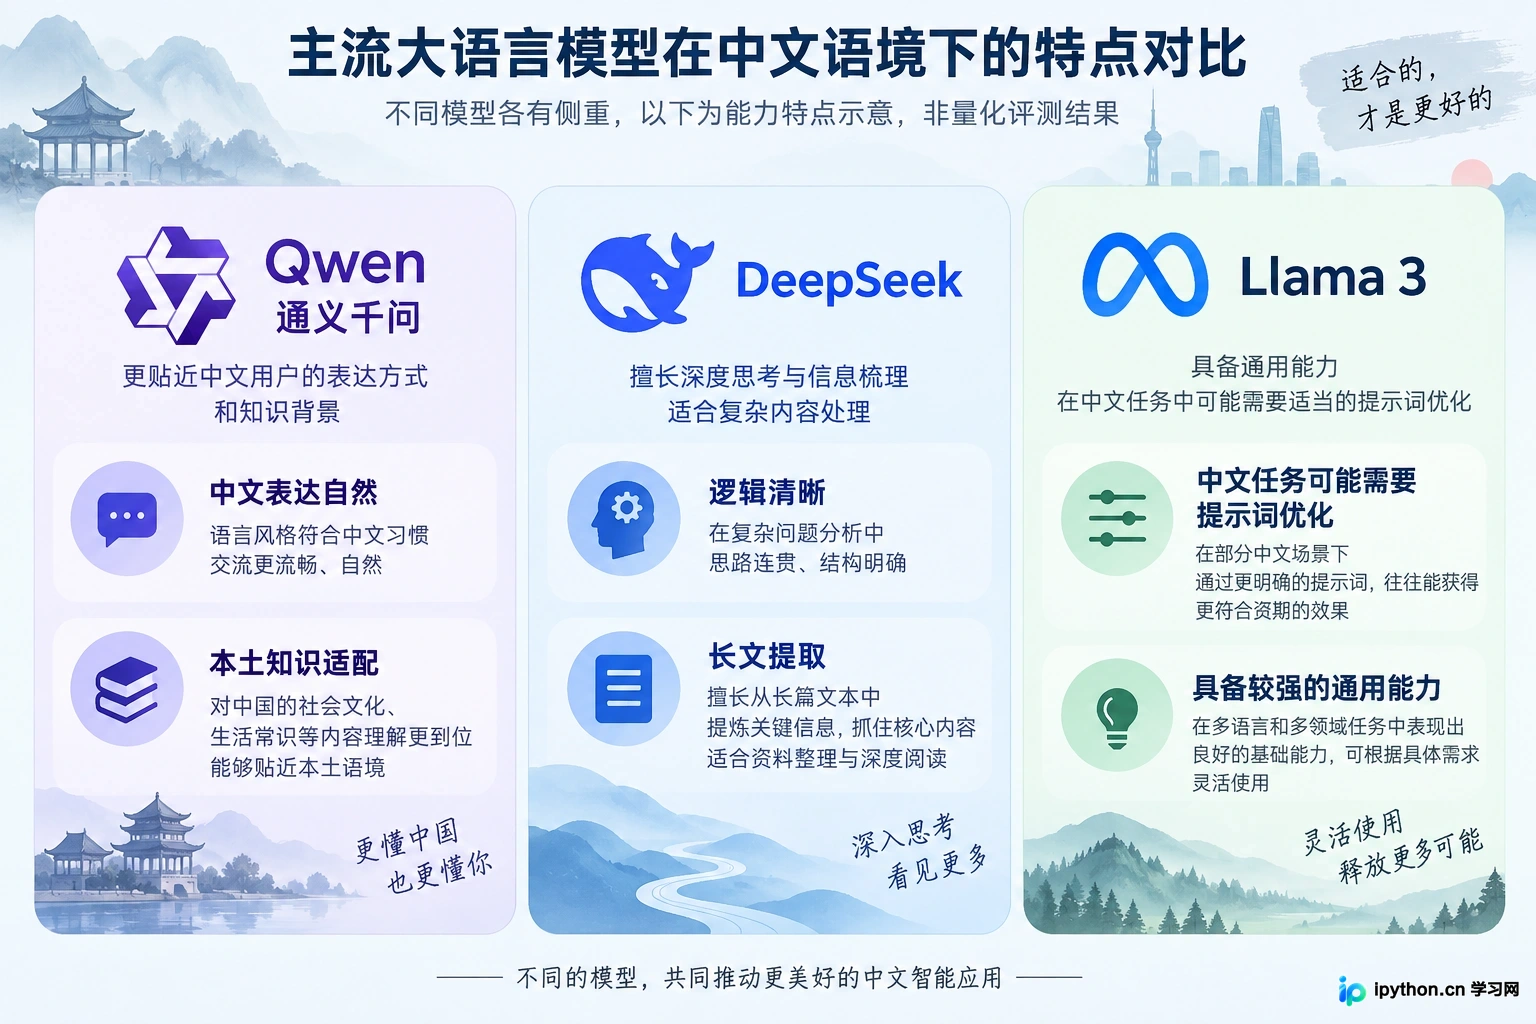
Qwen(通义千问)在中文处理上表现出极高的成熟度。得益于阿里海量的高质量中文语料,Qwen在处理成语典故、公文写作风格以及本土化常识问答时,准确率通常高于其他两款模型。它在面对具有中国特色的社会热点或行业术语时,极少出现“翻译腔”或理解偏差,能够直接输出符合中文阅读习惯的流畅文本。
DeepSeek在中文理解上同样表现出色,尤其在逻辑性较强的中文文本中优势明显。它不仅能准确识别字面意思,还能在长文档摘要、复杂指令遵循中保持较高的信息保真度。与Qwen相比,DeepSeek的风格更偏向理性与结构化,适合需要精确提取信息的场景,但在极具文学色彩或模糊语义的表达上,偶尔显得略微严肃。
Llama 3虽然经过多语言优化,但其核心优势仍集中在英语世界。在处理纯中文任务时,它往往需要经过额外的指令微调或提示词工程才能发挥最佳效果。对于简单的日常对话,Llama 3可以胜任,但在涉及深层文化背景或高精度中文语义辨析时,其表现通常不如Qwen和DeepSeek稳定,容易出现逻辑跳跃或事实性幻觉。
关于中文语境的理解与适配
关于代码生成与逻辑推理
代码能力是衡量大模型工程落地价值的关键指标,这不仅关乎语法正确性,更涉及架构设计与调试能力。
DeepSeek在此领域建立了显著的护城河。其专门针对代码任务进行了大规模强化训练,特别是在DeepSeek-Coder系列中,对多种编程语言的语法细节、库函数调用以及复杂算法实现有着深刻的理解。在生成Python、C++或Java代码时,DeepSeek往往能一次性提供可运行且注释清晰的代码片段,并且在处理Bug修复和代码解释任务时,展现出极强的逻辑链条推导能力。
Qwen的代码能力同样不容小觑,尤其在Web全栈开发和阿里云生态相关的工具链集成上表现优异。它能够很好地理解前后端交互逻辑,生成的代码结构规范,符合企业级开发标准。对于国内开发者常用的框架和技术栈,Qwen的响应速度和准确度都非常高,是一个稳健的生产力助手。
Llama 3在代码生成上保持了Meta一贯的高水准,尤其在Python和常见脚本语言上表现稳定。然而,在面对较为冷门的技术栈或需要深度上下文理解的复杂系统重构任务时,Llama 3有时会倾向于给出通用解法而非最优解。此外,由于训练数据中英文技术文档占主导,它在处理中文注释或非英文变量名的代码项目时,一致性略逊于专为多语言优化的DeepSeek和Qwen。
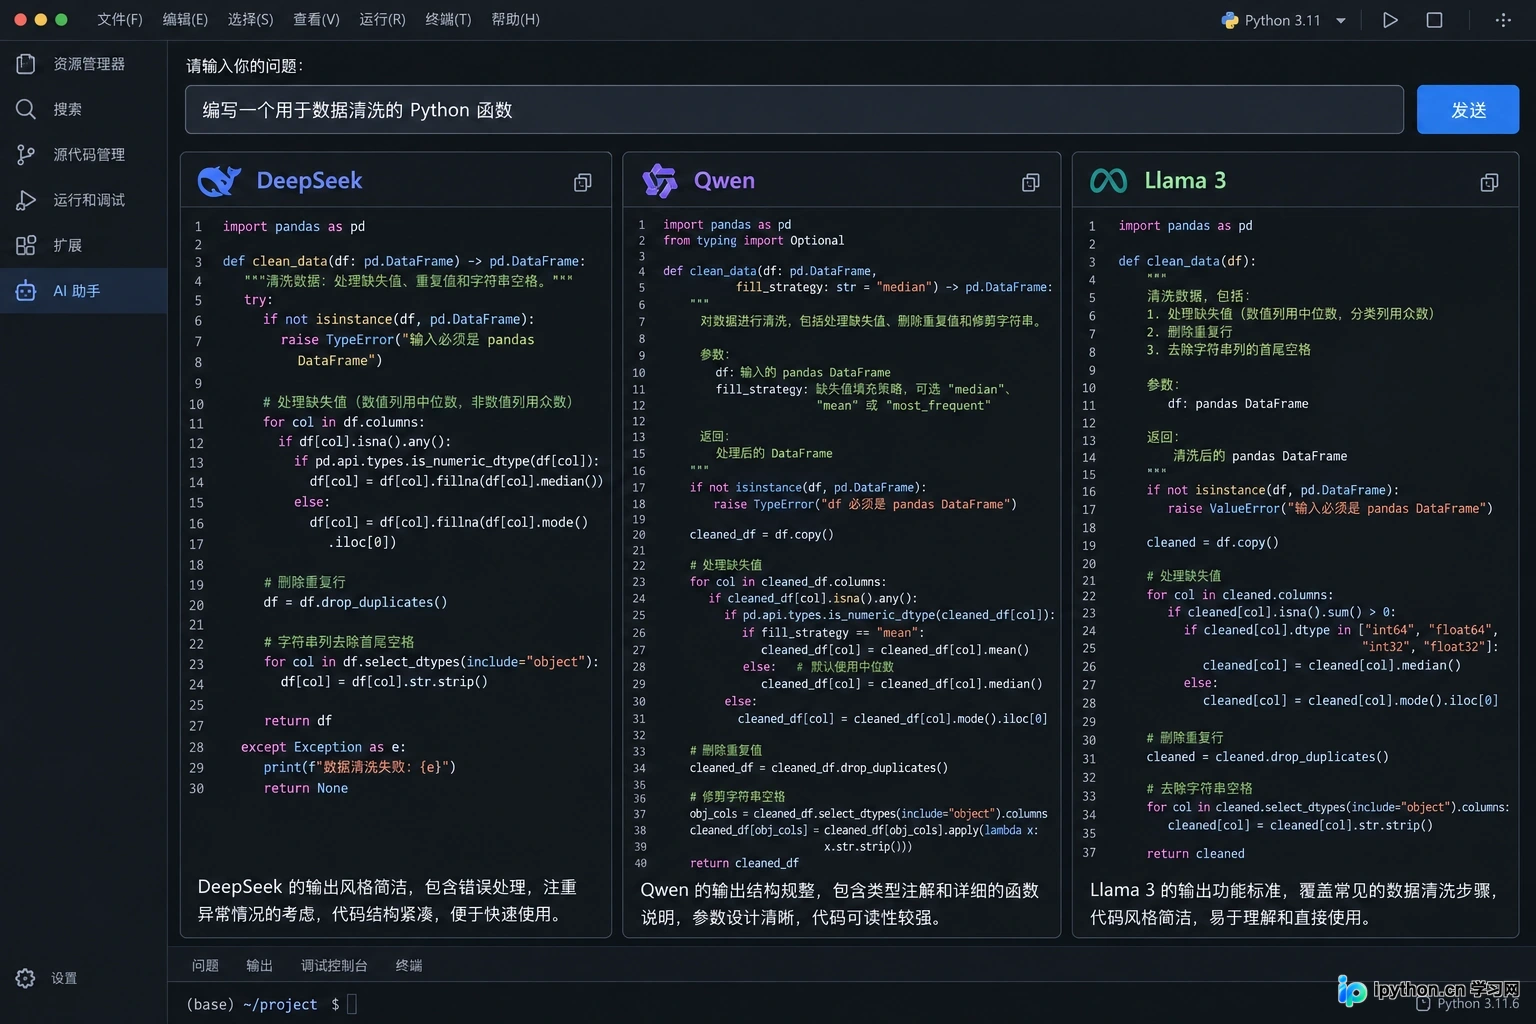
IDE中不同模型生成代码的对比示意
关于推理速度与部署效率
在实际生产环境中,模型的推理延迟和资源占用直接影响用户体验和运营成本。
DeepSeek采用了高效的混合注意力机制和稀疏激活技术,这使得其在同等参数量下,推理速度显著快于传统稠密模型。在部署方面,DeepSeek对显存的优化做得极为出色,允许用户在消费级显卡上运行较大参数的版本,或者在服务器端以更高的并发量提供服务。这种“高性价比”的推理效率,使其成为私有化部署的热门选择。
Qwen提供了丰富的模型尺寸选择,从端侧小模型到云端超大参数模型全覆盖。其推理引擎经过深度优化,在高并发场景下依然能保持稳定的低延迟。特别是Qwen2.5系列,在量化后的性能损失控制上做得非常好,适合对响应速度敏感的商业应用场景。
Llama 3的生态系统最为庞大,拥有最多的第三方推理加速工具和支持平台。虽然原生模型的推理效率中规中矩,但借助vLLM、TensorRT-LLM等成熟社区工具,可以轻松实现极高的吞吐量。不过,要达到与DeepSeek相当的极致效率,通常需要更多的工程调优工作。
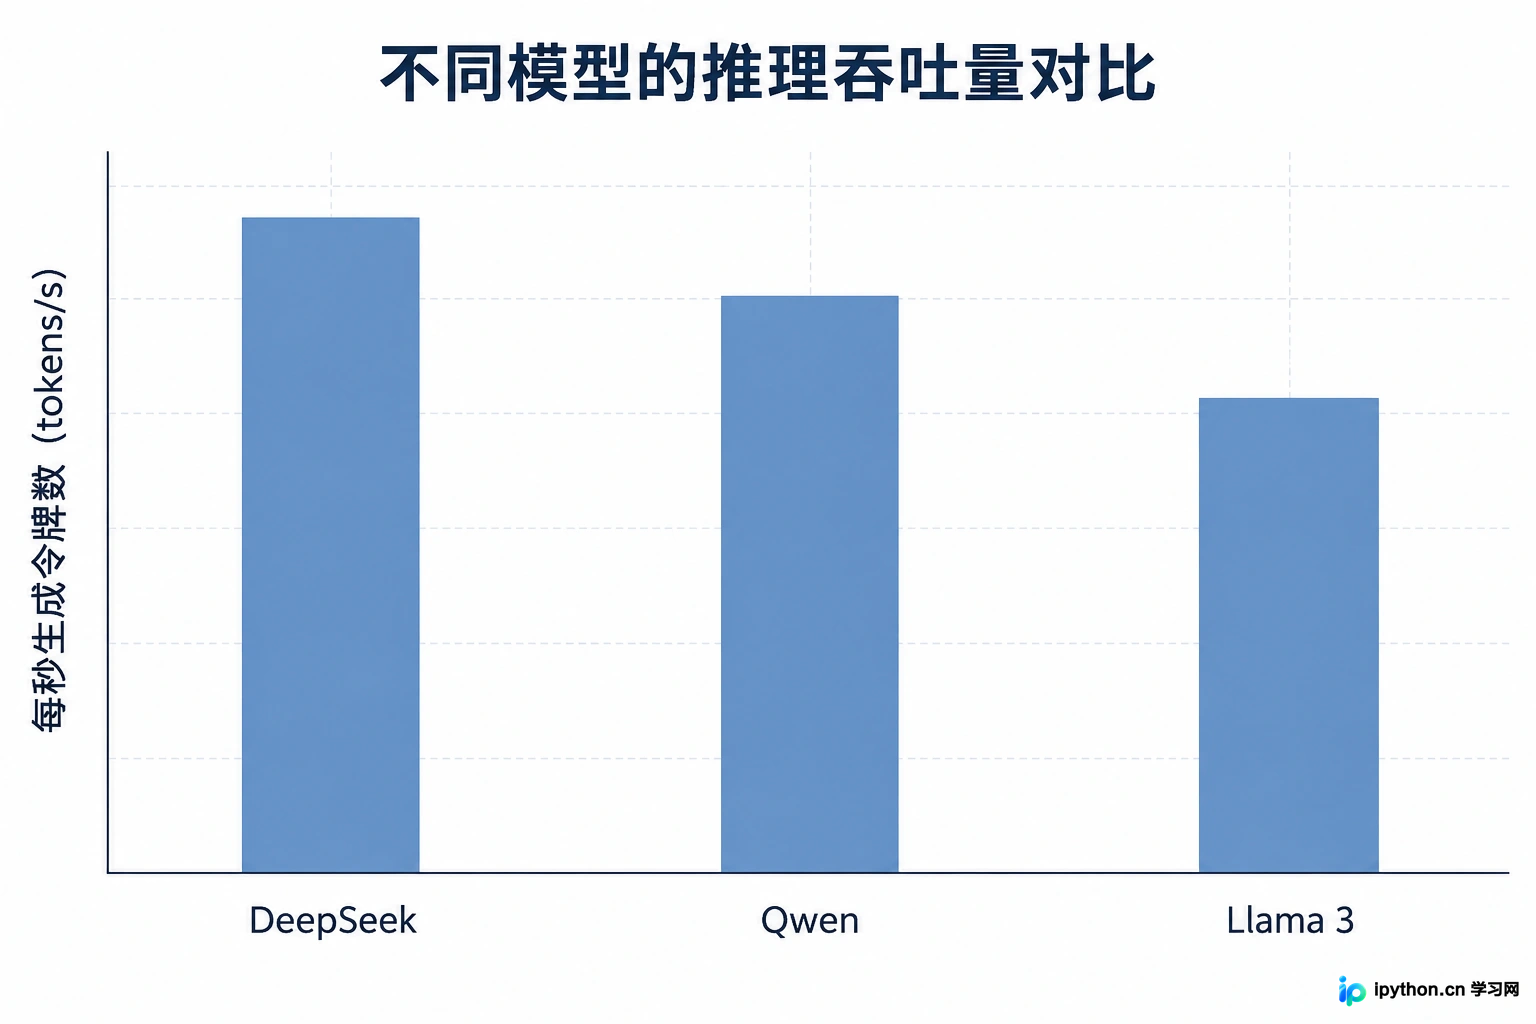
不同模型在相同硬件下的推理吞吐量对比
综合选型建议
没有绝对完美的模型,只有最适合场景的工具。如果业务核心面向中文用户,且涉及大量本土化内容创作或客服交互,Qwen是稳妥且高效的选择;若应用场景重度依赖代码生成、数学推理或逻辑分析,且对部署成本敏感,DeepSeek凭借其卓越的推理效率和代码专长脱颖而出;而对于主要面向全球市场、以英语为主要交互语言,且希望利用最广泛社区资源的团队,Llama 3依然是不可忽视的基准选项。在实际落地中,结合具体任务类型进行小规模测试,往往比单纯参考榜单更能找到答案。
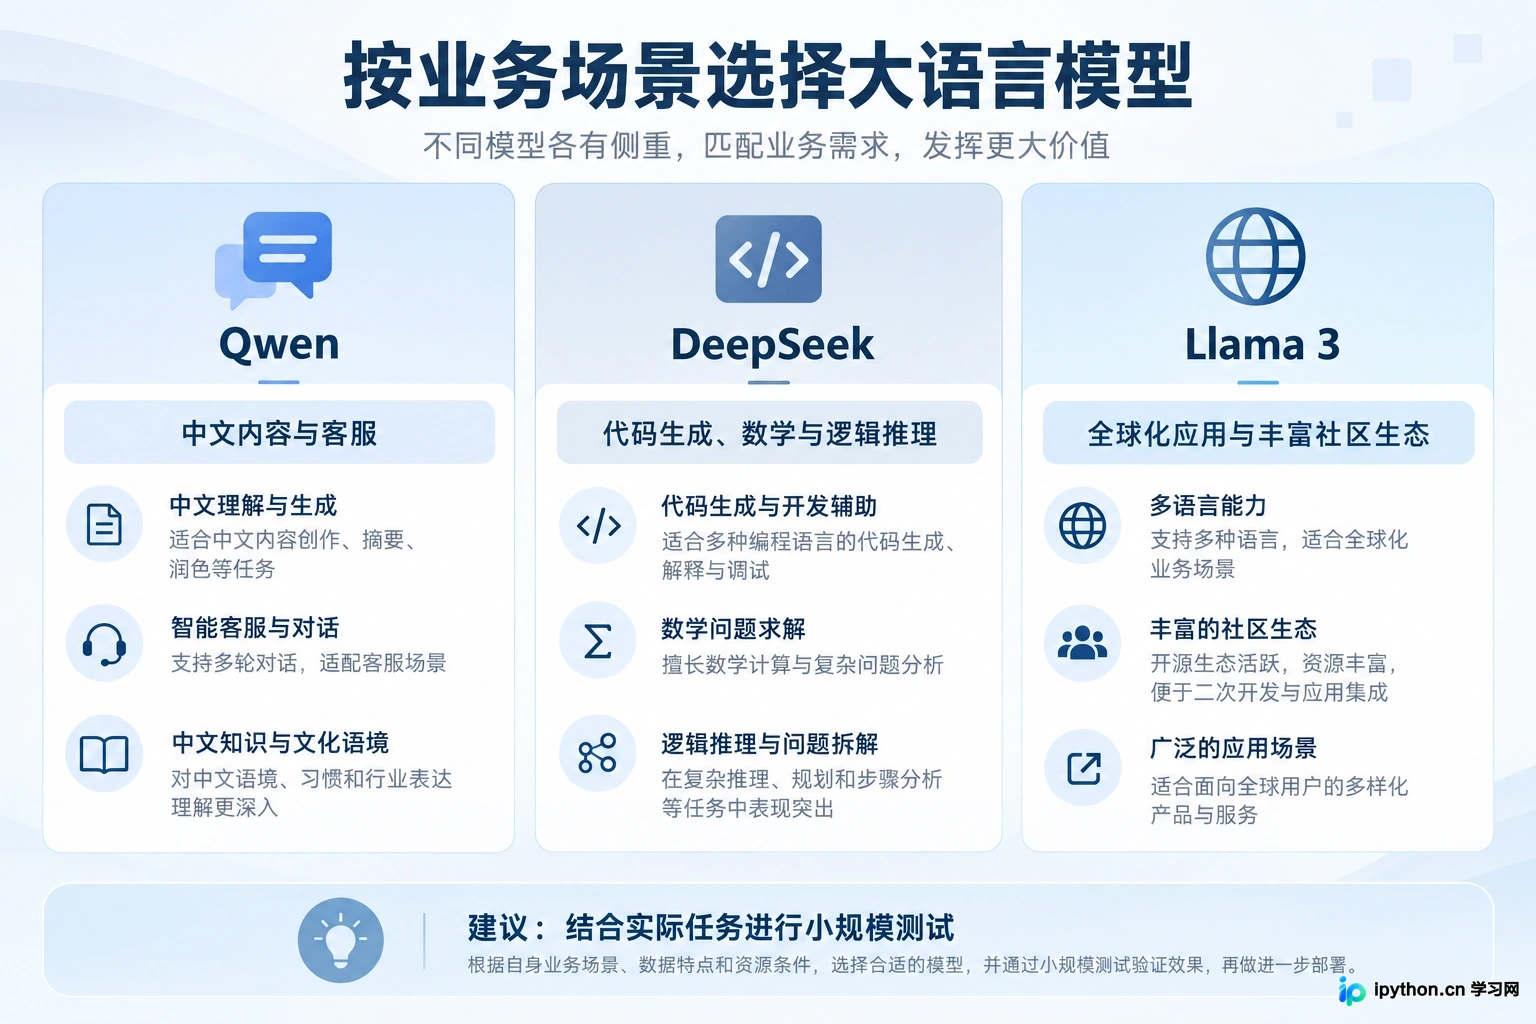
综合选型建议
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









