

Python NumPy广播机制在矩阵计算中的应用技巧

np.tile 浪费物理内存,便可直接完成矢量化运算。本文系统解析广播维度的匹配准则、内存步长机制,并结合矩阵中心化、成对距离矩阵、批量加权等实战技巧,提供一套严谨的矩阵计算与防错实践方案。
一、广播机制的核心对齐规则与运作原理
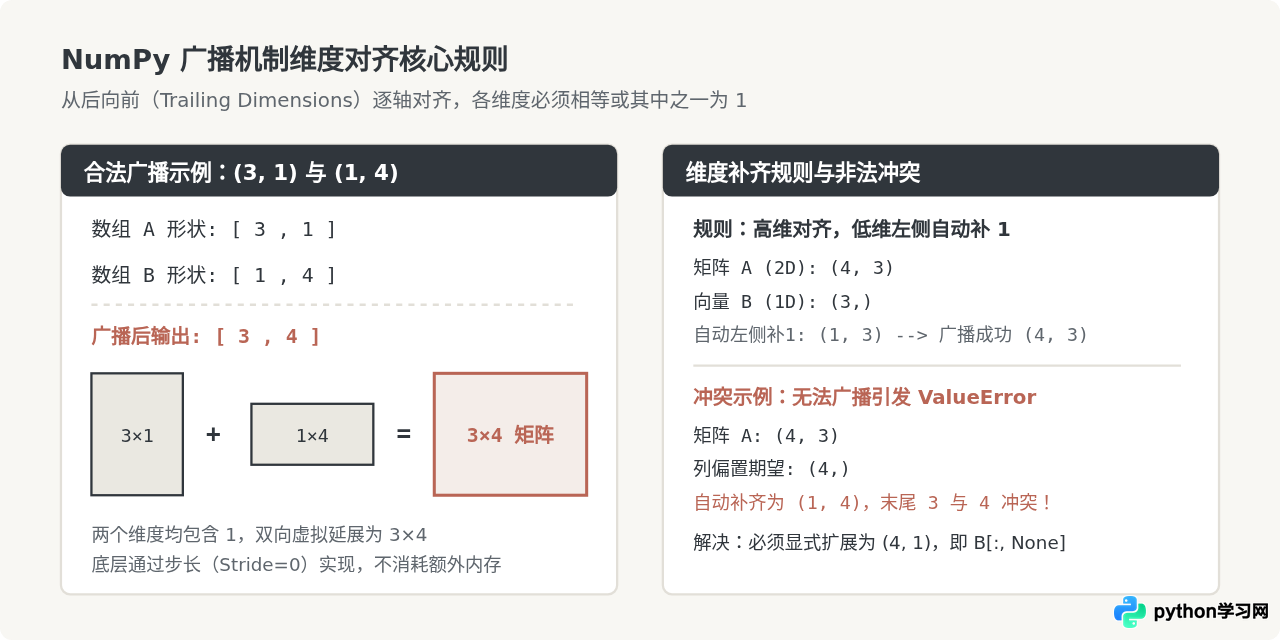
NumPy 判定两个数组是否兼容广播的逻辑十分确定:从两个形状元组的最末尾维度(即尾轴 Trailing Dimension)开始向前依次对比各轴长度。对于每一对被对比的轴,必须满足以下两个条件之一,计算才被允许执行:
- 该轴长度相等:两个数组在该维度上的元素数目完全一致。
- 其中一个数组该轴长度为 1:长度为 1 的数组将沿该轴虚拟拉伸,以匹配另一数组的长度。
如果两个数组的维度总数(ndim)不一致,NumPy 会自动在维度较少的数组形状左侧填充长度为 1 的轴,直到两者的维度数对齐,然后再执行逐轴检查。只要存在任何一个轴既不相等且均不为 1,解释器就会抛出 ValueError: operands could not be broadcast together 错误。
二、基础技巧:使用 np.newaxis 与 None 显式调整对齐轴
在实际编码中,很多初学者容易被 Python 的一维数组(形状为 (N,))所误导。一维数组既不是行向量也不是列向量。当它与一个二维矩阵 (N, M) 共同计算时,NumPy 总是向左侧补 1,将其视为 (1, N)。如果矩阵的列数 M 恰好等于 N,代码能运行但语义可能完全颠倒;如果 M ≠ N,则直接抛出异常。
为了精准控制广播的匹配方向,必须熟练使用 np.newaxis(在 NumPy 中等价于 Python 的 None)来显式增加长度为 1 的轴:
import numpy as np

# 假设有 4 个样本,每个样本 3 个特征
X = np.array([[10, 20, 30],
              [40, 50, 60],
              [70, 80, 90],
              [15, 25, 35]])  # shape: (4, 3)

# 需求 1:给每个特征(每列)加上对应权重 weights_col (长度为 3)
w_col = np.array([1, 2, 3])    # shape: (3,) -> 自动扩展为 (1, 3),可直接广播
res_col = X + w_col

# 需求 2:给每个样本(每行)加上样本偏置 bias_row (长度为 4)
b_row = np.array([0.1, 0.2, 0.3, 0.4])  # shape: (4,)

# 直接 X + b_row 会报错:(4, 3) 与 (1, 4) 末尾不匹配
# 正确技巧:显式在列方向插入轴,将其转为 (4, 1) 的严格列向量
res_row = X + b_row[:, np.newaxis]      # 或 b_row[:, None]
print("每行累加偏置后的形状:", res_row.shape)  # 输出: (4, 3)
养成使用 [:, None] 或 [None, :] 的习惯,不仅能让维度的语义在代码中完全透明,还能彻底避免由默认左补齐规则带来的隐蔽逻辑漏洞。
三、实战技巧一:矩阵标准化与 keepdims 的黄金组合
在特征工程中,按行或按列去均值(Zero-Centering)和归一化是最高频的操作。许多开发者习惯直接写 mu = X.mean(axis=1),结果发现随后执行 X - mu 时报错或维度混乱。原因在于聚合函数默认会将计算轴压缩消失,返回一维数组。
通过指定 keepdims=True,聚合结果会保留被压缩轴并将其长度置为 1。这为后续的广播操作提供了天然对齐的形状:
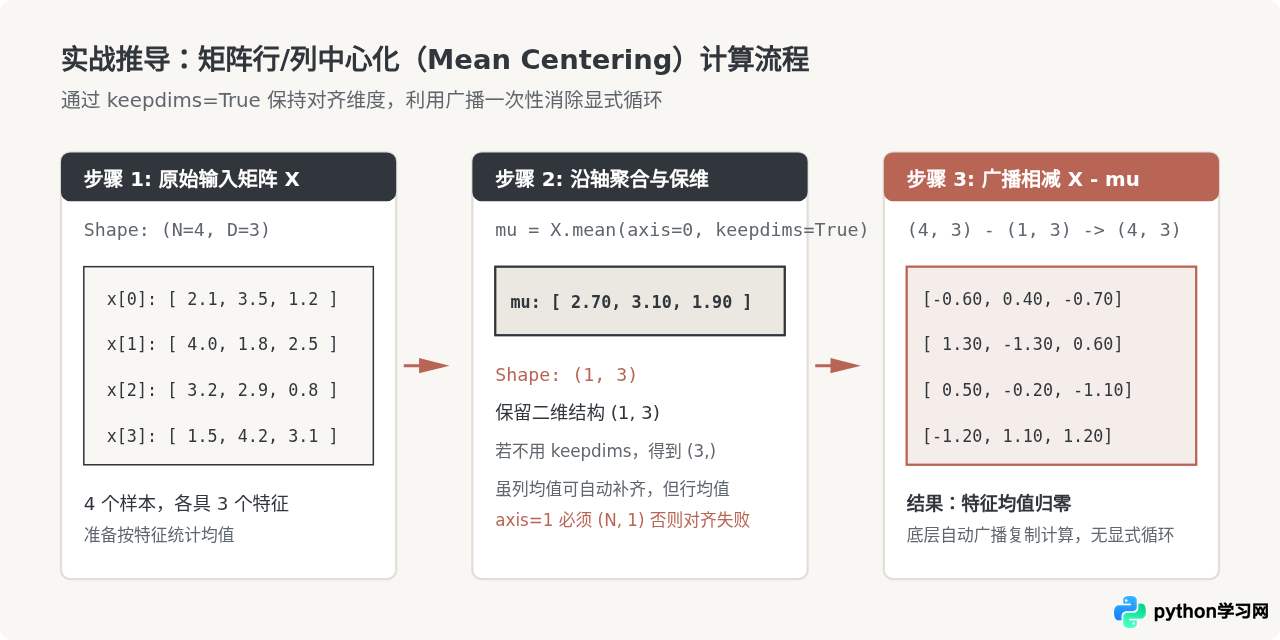
下面是基于 keepdims=True 实现完整的矩阵按行/按列 Z-score 标准化的标准范式:
# 按样本行进行标准化:每个样本自身均值为 0,方差为 1
mean_row = X.mean(axis=1, keepdims=True)  # shape: (4, 1)
std_row  = X.std(axis=1, keepdims=True)   # shape: (4, 1)
X_norm_row = (X - mean_row) / (std_row + 1e-8)  # 广播自动沿列向扩展

# 按特征列进行标准化:每个特征均值为 0,方差为 1
mean_col = X.mean(axis=0, keepdims=True)  # shape: (1, 3)
std_col  = X.std(axis=0, keepdims=True)   # shape: (1, 3)
X_norm_col = (X - mean_col) / (std_col + 1e-8)  # 广播自动沿行向扩展
四、实战技巧二:无显式循环的高维广播与成对距离矩阵
在聚类(K-Means)、KNN 分类或注意力机制(Attention)中,经常需要计算点集 $A$($N$ 个点,$D$ 维特征)与点集 $B$($M$ 个点,$D$ 维特征)之间所有点对的欧几里得距离,最终得到一个形状为 (N, M) 的距离矩阵。
传统写法使用两重 for 循环计算 $N \times M$ 次,在点数达到数万时极其缓慢。利用广播机制,我们可以通过“交叉升维”在三维空间中一步完成:
# 设定两组点集
A = np.random.randn(500, 64)  # 500 个 64 维样本
B = np.random.randn(300, 64)  # 300 个 64 维样本

# 核心升维技巧:
# A 变形为 (500, 1, 64)
# B 变形为 (1, 300, 64)
A_exp = A[:, np.newaxis, :]  # shape: (500, 1, 64)
B_exp = B[np.newaxis, :, :]  # shape: (1, 300, 64)

# 广播相减:中间结果直接得到所有点对在每个特征维度的差值!
diff = A_exp - B_exp         # shape: (500, 300, 64)

# 沿特征轴(axis=-1)求平方和并开方,直接得到欧氏距离矩阵
dist_matrix = np.sqrt(np.sum(diff ** 2, axis=-1))  # shape: (500, 300)
print("计算完成,距离矩阵形状:", dist_matrix.shape)
这一手法的本质是将二维矩阵升格为三维张量,让第一轴服务于 $A$ 的索引,第二轴服务于 $B$ 的索引,第三轴保留特征运算。同样的模式适用于任意两个张量之间的外积、余弦相似度或相关系数计算。
五、底层机制剖析:零拷贝视图与内存步长(Strides)
为什么广播机制比调用 np.tile(x, (M, 1)) 明显更快且更节省内存?答案隐藏在 NumPy 数组底层的 strides(步长)设计中。
NumPy 的数组对象 ndarray 由两部分构成:一块连续存放实际数据的底层内存缓冲区(Data Buffer),以及描述维度的元数据(Metadata,包含 shape、dtype 与 strides)。步长定义了在内存中移动到该维度下一个元素所需要跨越的物理字节数。
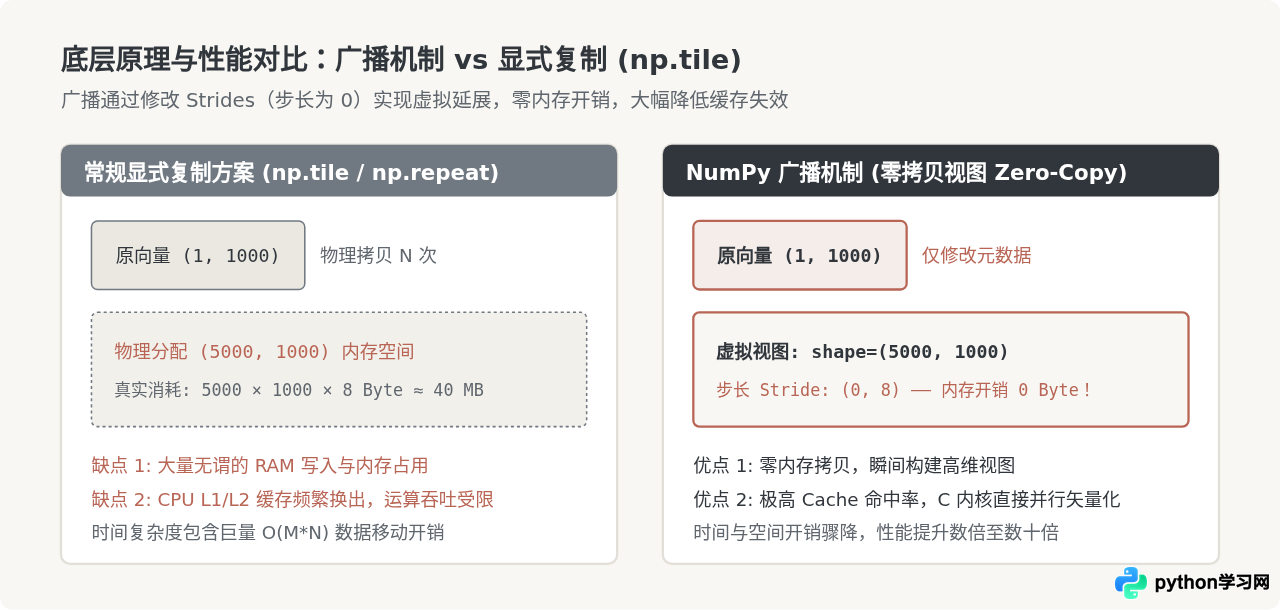
我们可以使用 np.lib.stride_tricks.as_strided 或查看数组的 .strides 属性直接验证这一原理:
import numpy as np

arr = np.array([10, 20, 30], dtype=np.int64)  # 64 位整数,每元素占用 8 字节
print("原始步长:", arr.strides)  # 输出: (8,)

# 通过 broadcast_to 观察广播后的元数据
b_view = np.broadcast_to(arr, (4, 3))
print("广播后形状:", b_view.shape)    # 输出: (4, 3)
print("广播后步长:", b_view.strides)  # 输出: (0, 8)
可以看到,新增加的行维度的步长被直接赋予了 0。这意味着指针在遍历不同行时,内存偏移量始终为 0,程序反复访问同一物理地址上的数据。这不仅节省了内存,更极大提升了 CPU L1/L2 缓存的命中率。
六、常见隐患排查与防御性编码技巧
虽然广播机制极为高效,但由于其隐式自动触发的特性,在工程实践中也极易带来隐蔽 Bug。以下是必须重点防范的两大典型陷阱:
1. 意外的外积式内存暴涨
最经典的事故场景莫过于:开发者原本打算让一个长度为 $N$ 的列向量与一个长度为 $N$ 的行向量逐元素相加,结果由于未统一形态,一个写成了 (N, 1),另一个写成了一维数组 (N,):
# 事故示范:
col = np.ones((50000, 1))
row = np.ones((50000,))

# 开发者本意是 element-wise 相加,期望得到 (50000, 1)
# 实际结果:(50000, 1) + (1, 50000) 自动广播生成 (50000, 50000) 矩阵!
# 瞬间申请了 50000*50000*8 字节 ≈ 18.6 GB 内存,直接导致进程 OOM 崩溃!
# res = col + row  <-- 极其危险
2. 原地修改(In-place Operation)受限
广播生成的维度是虚拟视图,由于其步长为 0,多个逻辑位置映射到同一物理地址。因此,NumPy 严格禁止对广播维进行歧义性的原地写入。例如 b_view += 1 会直接抛出错误。必须将结果赋予新变量或使用显式输出参数。
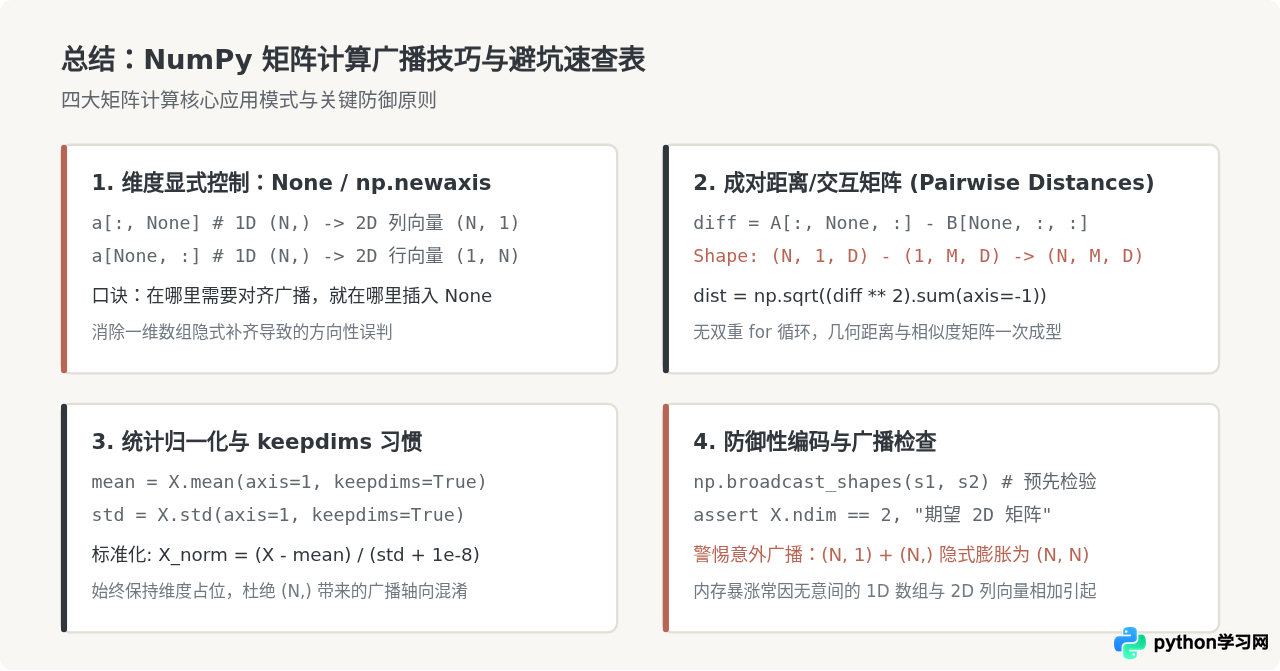
防御方案:预先校验与形状断言
在库或生产代码中,可以使用 np.broadcast_shapes() 函数预先验证形状兼容性,并在核心计算前加入断言保护:
def safe_matrix_add(mat_a, vec_b):
    """确保矩阵与向量安全按行或按列相加,防止意外外积膨胀"""
    assert mat_a.ndim == 2, f"mat_a 必须为二维矩阵,当前为 {mat_a.ndim}维"
    assert vec_b.ndim in (1, 2), "vec_b 必须为一维或二维向量"

    # 显式规范 vec_b 形状,若为 1D 且长度与行数一致,必须主动重塑为 (N, 1)
    if vec_b.ndim == 1 and vec_b.shape[0] == mat_a.shape[0]:
        vec_b = vec_b[:, None]

    # 预检形状是否合法(不合法直接抛出 ValueError,不会产生计算)
    target_shape = np.broadcast_shapes(mat_a.shape, vec_b.shape)
    assert target_shape == mat_a.shape, f"广播目标形状 {target_shape} 不符合预期 {mat_a.shape}"

    return mat_a + vec_b
结语
掌握 NumPy 的广播机制,关键在于建立起“尾轴向左逐级对齐”的几何空间直觉。通过告别显式的 Python 循环与 np.tile 复制,善用 np.newaxis 显式指定延展方向,并结合 keepdims=True 维护张量骨架,开发者不仅能写出执行速度逼近原生 C 语言的高性能矩阵代码,更能从容驾驭高维张量变换与现代数值计算任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









