

Python就业饱和了吗?互联网与传统行业的差异化机会挖掘

Python岗位的“就业饱和”本质上是一种结构性过剩:互联网行业中门槛较低的基础Web后端与初级爬虫岗位因供需失衡而严重内卷,但在传统行业的数字化落地中,懂得业务规则并能用Python进行数据加工、流程自动化和工业分析的复合型人才仍存在持续缺口。
一、认清“饱和”的本质:互联网行业的结构性过剩
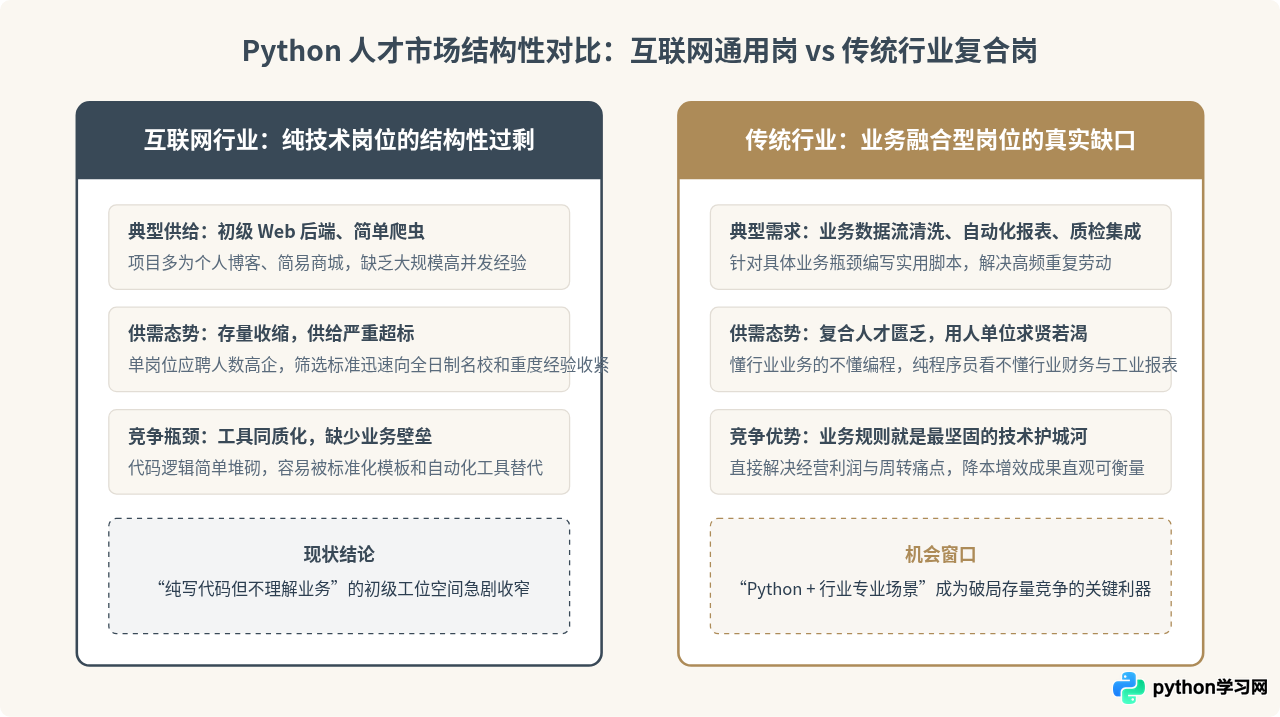
很多求职者在招聘软件上投递数十份简历却鲜有回音,因而得出“Python已经彻底饱和”的结论。要准确理解这一现象,首先需要拆解岗位的具体分类。
过去数年中,大量初学者通过短期课程掌握了基础语法、Django/Flask轻量框架或简单的Requests抓取脚本。在互联网行业高速扩张时期,初创团队和中小型项目确实需要这类基础技术人员快速搭建原型。然而,随着互联网行业进入存量优化阶段,企业对后端系统的并发性能、高可用架构、微服务治理提出了极高要求,传统以Java、Go为主导的技术栈牢牢占据了主流核心系统。
这就造成了“纯代码、纯技术”岗位的两极分化:企业要么需要拥有5年以上经验、精通分布式系统底层的高级工程师,要么倾向于精简初级岗位。同质化严重的“基础语法+单体CRUD项目”求职者大量堆积在互联网求职通道中,形成了肉眼可见的“饱和表象”。
二、传统行业数字化中的真实痛点
与互联网企业追求高并发分布式架构不同,传统企业(如高端制造、外贸供应链、零售连锁、金融审计等)在信息化进程中面临的是完全不同的现实矛盾:
- 遗留系统割裂:ERP、WMS(仓储管理系统)、CRM以及各类硬件传感器的数据格式互不兼容,数据孤岛严重。
- 人工处理成本高昂:业务骨干每日花费数小时在几十张异构 Excel 表格之间手动复制、VLOOKUP 匹配与公式校对,极易出错且延迟严重。
- IT 部门响应周期长:企业定制大型软件周期往往以月或年计,而市场变化要求业务规则每周微调,传统 IT 架构无法满足轻量、灵活的迭代诉求。
在这些场景下,Python 凭借其极高的开发效率、极其完备的数据处理库生态(Pandas、OpenPyXL、Requests 等),成为了连接业务部门与底层数据系统的“胶水语言”。
三、传统行业中的四大差异化就业场景
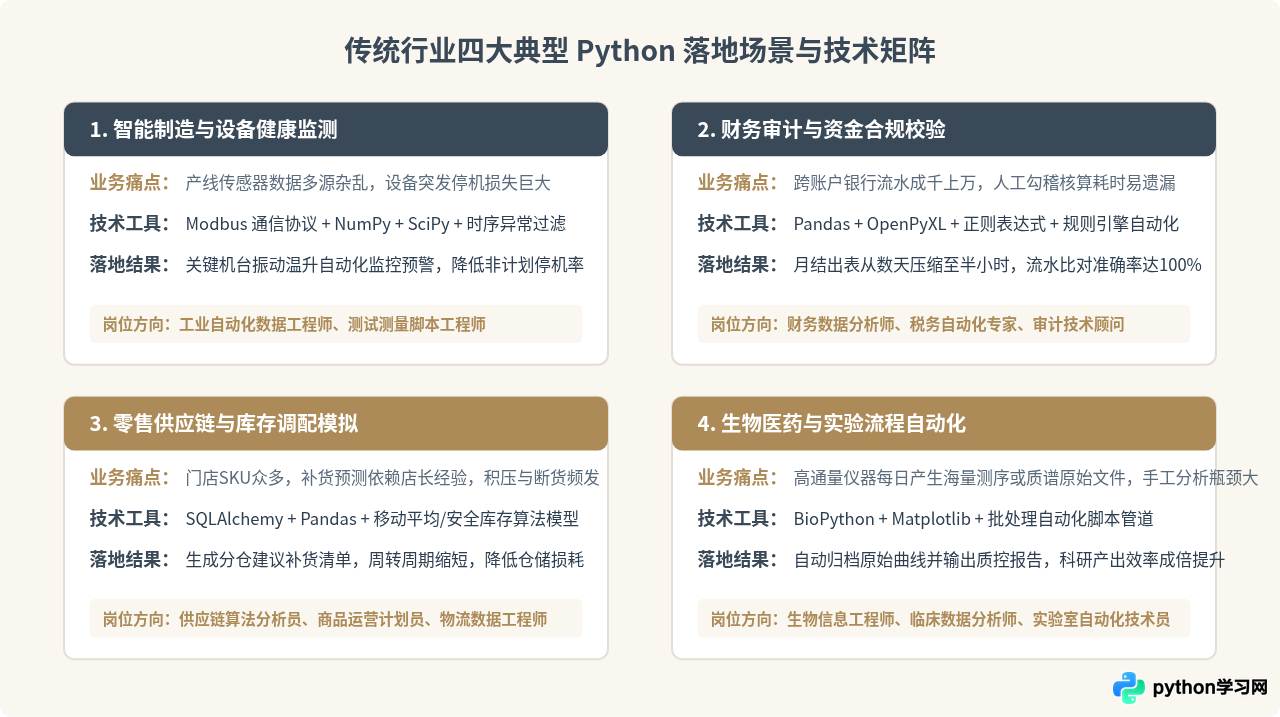
为了让求职与转型路径具备具体的操作抓手,以下梳理四个具备明确用人需求与业务壁垒的传统行业细分领域:
1. 智能制造与设备健康运维
现代制造业车间配置了大量的 PLC(可编程逻辑控制器)、数控机床与温振传感器。过去,老师傅凭听觉和经验判断磨损,设备故障往往引发整条产线停摆。通过 Python 的串口通信库(如 pyserial)或工业网络协议库(如 pymodbus),工程师可以低成本搭建实时采集通道,运用 numpy 计算振动能量均方根值(RMS),及时捕捉异常抖动。
2. 财务审计与业财一体化勾稽
大型企业或会计师事务所的审计人员,在面对成百上千个账户的网银流水、发票清单与 ERP 记账凭证时,手工核验往往耗时数周。编写 Python 自动化审计脚本,能够在秒级内完成字段模糊匹配、金额双向抵消和异常大额交易筛查,直接生成格式统一的底稿。
3. 零售供应链与动态安全库存测算
面对数十个区域仓储和成千上万个商品条目,人工调整订货点极易导致旺季缺货或淡季爆仓。利用 Python 建立轻量级时序分析,结合历史出库速率与在途交货周期,每天清晨自动向采购主管推送补货建议表,这类工作带来的经济价值直接反映在财报的存货周转指标中。
4. 生物医药与实验流程自动化
在化学分析与制药研发实验室,色谱仪、质谱仪等分析设备每日生成成千上万份原始文本数据。编写自动化脚本批量提取特定吸收峰位、计算半衰期并将标准曲线绘制成矢量图保存,可直接解放高学历科研人员的低价值重复劳动。
四、转型与能力构建的四步落地法
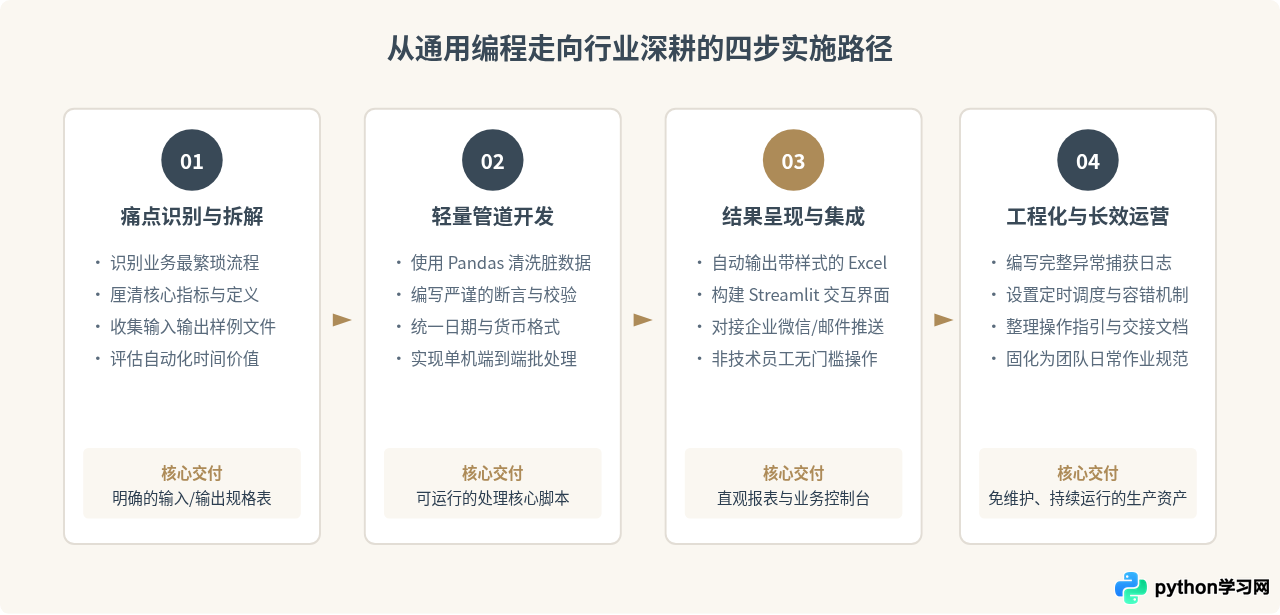
对于希望从“纯程序员”转向“行业问题解决者”的开发者,切忌闭门只刷算法题。应当遵循以下四个步骤逐步构建自身壁垒:
代码实战示例:多来源账目自动化对账与差异报告
以下展示一个用于传统商贸企业月结核对的完整 Python 示例脚本。该脚本读取业务订单明细与网银流水清单,自动完成金额四舍五入对齐、交易单号归一化及差异标识,并输出格式化的审计底稿:
import pandas as pd
import numpy as np

def reconcile_accounts(erp_file_path: str, bank_file_path: str, output_path: str) -> dict:
    """
    核对 ERP 业务出库单与网银回执流水
    环境要求: Python 3.9+, pandas 1.5.0+, openpyxl
    """
    # 1. 载入原始数据
    df_erp = pd.read_excel(erp_file_path)
    df_bank = pd.read_excel(bank_file_path)

    # 2. 字段清洗与格式统一
    df_erp['order_id'] = df_erp['订单编号'].astype(str).str.strip().str.upper()
    df_erp['erp_amount'] = np.round(df_erp['开票金额'].astype(float), 2)

    df_bank['order_id'] = df_bank['附言订单号'].astype(str).str.strip().str.upper()
    df_bank['bank_amount'] = np.round(df_bank['实收金额'].astype(float), 2)

    # 3. 按订单维度进行全外连接比对
    merged = pd.merge(
        df_erp[['order_id', '客户名称', 'erp_amount']],
        df_bank[['order_id', '付款账户', 'bank_amount']],
        on='order_id',
        how='outer'
    )

    # 4. 判定核对状态
    merged['erp_amount'] = merged['erp_amount'].fillna(0.0)
    merged['bank_amount'] = merged['bank_amount'].fillna(0.0)
    merged['diff'] = np.round(merged['erp_amount'] - merged['bank_amount'], 2)

    conditions = [
        (merged['erp_amount'] > 0) & (merged['bank_amount'] == 0),
        (merged['erp_amount'] == 0) & (merged['bank_amount'] > 0),
        (merged['diff'] == 0.0),
        (merged['diff'] != 0.0)
    ]
    choices = ['ERP已开票未回款', '银行已收款无订单', '完全匹配', '金额存在差异']
    merged['status'] = np.select(conditions, choices, default='待人工复核')

    # 5. 导出结构化报表
    with pd.ExcelWriter(output_path, engine='openpyxl') as writer:
        merged.to_excel(writer, sheet_name='对账总表', index=False)
        summary = merged['status'].value_counts().reset_index()
        summary.columns = ['核对结论', '笔数']
        summary.to_excel(writer, sheet_name='审计汇总', index=False)

    return {
        "total_records": len(merged),
        "unmatched_count": int((merged['status'] != '完全匹配').sum()),
        "output_file": output_path
    }

# 示例调用
if __name__ == '__main__':
    result = reconcile_accounts("erp_records.xlsx", "bank_flow.xlsx", "monthly_audit_result.xlsx")
    print(f"对账处理完成,共核对 {result['total_records']} 笔,异常待查项: {result['unmatched_count']} 笔")
注意与避坑事项
在向传统业务部门交付脚本时,切忌要求业务人员打开命令行安装 Python 环境或配置环境变量。推荐使用 PyInstaller 将脚本打包为单个 .exe 运行文件,或者通过 Streamlit 搭建局域网网页,业务人员只需在浏览器中拖入两个 Excel 即可下载结果。交付形式越友好,技术成果越容易被管理层认可。
五、从“代码工人”到“业务解决者”的思维重塑
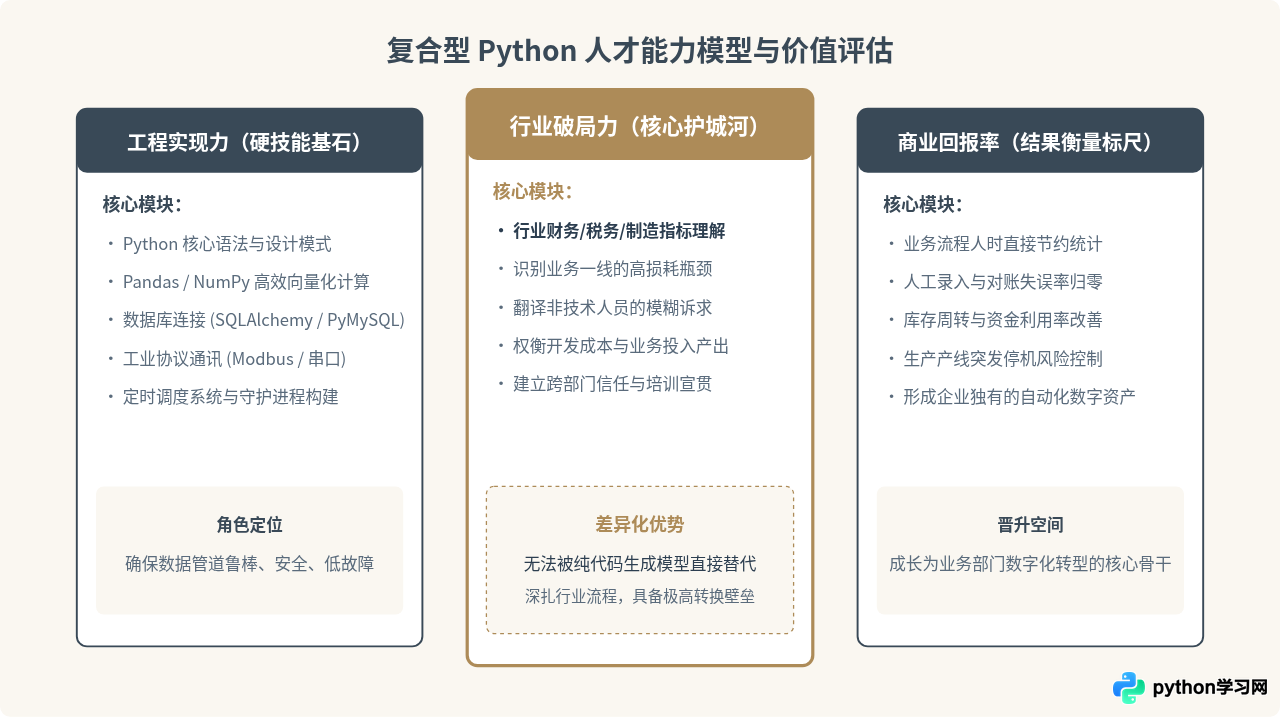
求职者若想在传统产业中赢得溢价,关键不在于能背诵多少 LeetCode 动态规划模板,而在于能否在具体业务场景中完成“技术价值的闭环落地”。
六、求职与简历优化的差异化策略
如果打算瞄准传统产业和实体经济的数字化机会,简历撰写与面试展示必须摆脱“互联网范式”:
| 维度 | 互联网通用求职模式(已高度内卷) | 传统行业差异化破局模式(推荐) |
|---|---|---|
| 项目名称 | 电商网站商城后端、在线图书管理系统 | 制造产线能耗监测工具、多渠道账务对账引擎 |
| 技术描述 | 熟练使用 Django/Flask,实现 JWT 鉴权和 CRUD 接口 | 使用 Pandas/OpenPyXL 自动解析异构 ERP 与网银对账单 |
| 成果衡量 | 接口响应时间 50ms,系统吞吐量 100 QPS | 每月节省业务核算工时 40 个小时,将账目异常核查率提升至 100% |
| 求职部门 | 纯技术部、基础架构研发组 | 供应链运营部、财务共享中心、智能制造工程组、精益生产部 |
七、总结
Python 语言本身并没有陷入死局,真正处于退潮期的是缺乏业务场景支撑的单一编程岗位。对于求职者而言,停止在互联网初级后端的红海中重复卷技术名词,主动走向离利润、成本和实体生产更近的传统实体经济,将 Python 锻造为解决行业具体业务难题的高效工具,正是挖掘未来五年结构性就业红利的核心路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









