

Python pandas数据合并详解:concat与append用法指南

本文详细介绍Python中pandas库的数据合并功能,重点讲解concat函数的axis参数、join模式及ignore_index用法,以及append方法的使用场景。通过具体代码示例展示如何对相同字段表进行首尾连接、多表分组合并及不同列名表的行对齐操作,帮助开发者掌握高效的数据处理技巧。
一、concat
concat函数是pandas库中用于数据融合的核心方法,能够依据指定的轴对数据进行基础整合。
pd.concat(objs, axis=0, join='outer', join_axes=None, ignore_index=False,
       keys=None, levels=None, names=None, verify_integrity=False)
该函数主要涉及两个关键参数:axis用于指定合并的轴方向,0代表行方向,1代表列方向;join参数决定连接方式,可选inner(交集)或outer(并集)。
二、相同字段的表首尾相接
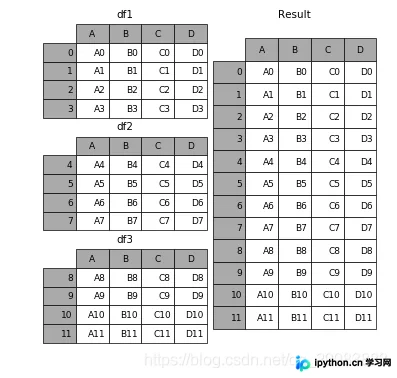
#现将表构成list,然后在作为concat的输入
In [4]: frames = [df1, df2, df3]

In [5]: result = pd.concat(frames)
在对具有相同字段的表格进行首尾连接时,可以通过增加key参数来构建一个层级的键,从而清晰标识数据来源自哪张原始表。
In [6]: result = pd.concat(frames, keys=['x', 'y', 'z'])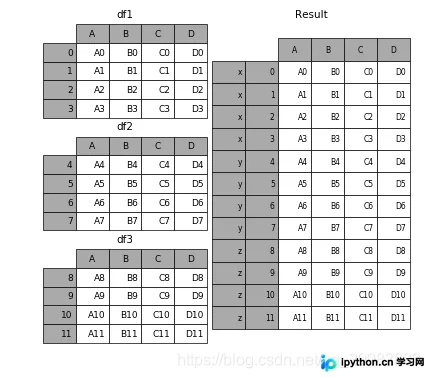
此外,还可以直接传入字典结构来增加分组键,实现更灵活的数据分组与合并。
pieces = {'x': df1, 'y': df2, 'z': df3}

result = pd.concat(pieces)
三、axis
当设置axis为1时,concat操作将执行行对齐,并将不同列名的两张表进行合并,此时连接主要依据索引号进行匹配。
result = pd.concat([df1, df4], axis=1)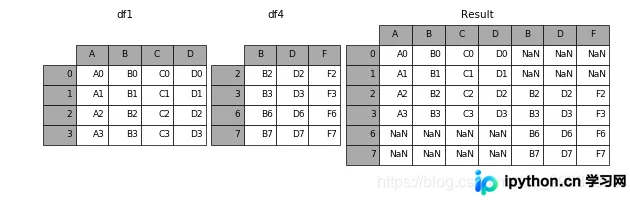
3.1 join
通过添加join参数属性,可以控制结果集的范围:若设置为'inner',则仅保留两表的交集部分;若设置为'outer',则保留两表的并集。
result = pd.concat([df1, df4], axis=1, join='inner')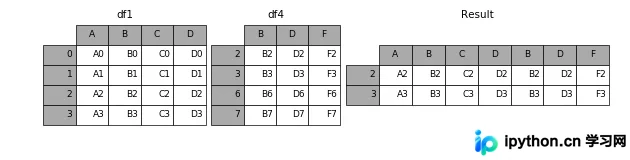
3.2 join_axes
若传入join_axes参数,则可指定依据特定轴的索引来对齐数据。例如,指定根据df1表的索引对齐,结果将保留df1指定的轴,并将df4表的数据拼接其上。
result = pd.concat([df1, df4], axis=1, join_axes=[df1.index])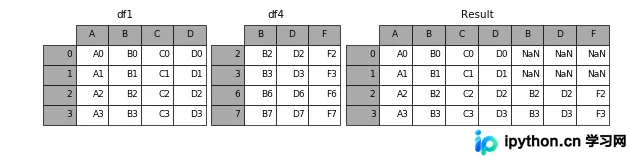
四、append
append是Series和DataFrame对象的方法,默认沿列方向进行拼接(即axis=0,列对齐),常用于将新数据追加到现有数据集中。
result = df1.append(df2)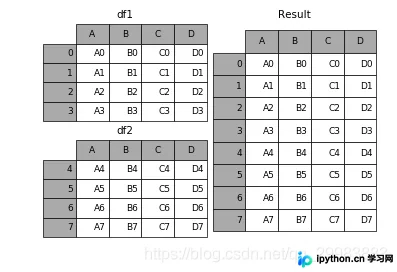
五、无视index的concat
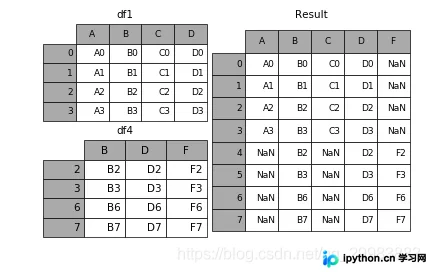
如果两个表的索引(index)不具备实际业务含义,可以使用ignore_index参数并设置为true。此时,合并操作将忽略原有索引,仅根据列字段进行对齐合并,并在最后生成一个新的连续索引。
到此这篇关于Python基础之pandas数据合并的文章就介绍到这了,更多相关Python pandas数据合并内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









