


Python 做多任务时,很多人的第一反应是“开线程”或者“上异步”,但真正决定方案的,往往不是语法喜好,而是任务类型、并发规模和代码维护成本。下面按实际开发里最常见的几种做法逐项梳理,并把适用边界、典型写法和容易踩坑的地方放到一起,方便你判断什么时候该用线程,什么时候该换进程或 asyncio。
先判断:你面对的是 I/O 密集还是 CPU 密集
Python 的多任务方案看起来很多,但选型时可以先抓住一个核心判断:任务究竟是在“等待”,还是在“计算”。
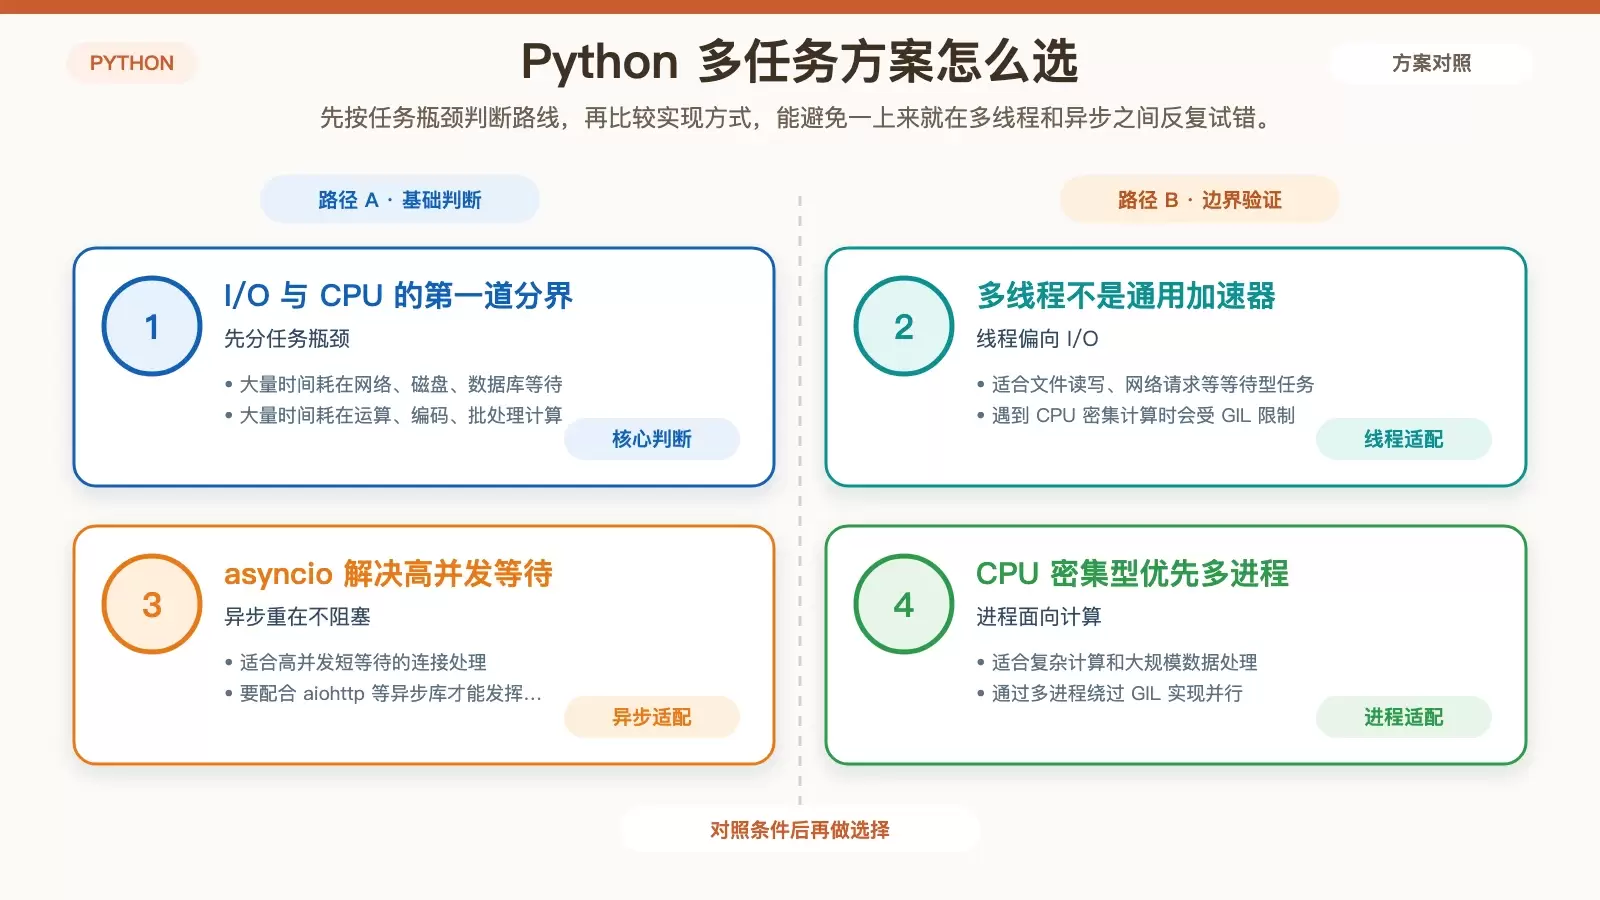
- I/O 密集型:比如文件读写、网络请求、数据库访问。程序大量时间花在等待外部资源返回,这类场景通常适合多线程或异步编程。
- CPU 密集型:比如复杂计算、批量数据处理、图像编码。程序主要时间耗在计算本身,这类场景更适合多进程。
之所以不能混着选,一个关键原因是 Python 的全局解释器锁(GIL)。它会限制多线程在 CPU 密集型任务上的并行能力,因此“线程很多”并不等于“算得更快”。
多线程:适合 I/O 密集任务,写法直接
threading 模块是最容易上手的多任务方式之一。它适合网络请求、日志处理、文件操作这类等待时间明显的任务,因为线程可以在一个任务阻塞时切换到另一个任务。
基础写法
import threading
import time
def worker(name, delay):
    print(f"线程 {name} 开始")
    time.sleep(delay)
    print(f"线程 {name} 结束")
# 创建多个线程
thread1 = threading.Thread(target=worker, args=("A", 2))
thread2 = threading.Thread(target=worker, args=("B", 3))
# 启动线程
thread1.start()
thread2.start()
# 等待所有线程完成
thread1.join()
thread2.join()
print("所有线程已完成")
这里的关键点有两个:一是用 start() 启动线程,二是用 join() 等待线程结束。对于少量并发任务,这种写法已经足够直观。
更常见的做法:线程池
如果需要批量提交任务,手动创建和回收线程会比较麻烦,这时通常更推荐 concurrent.futures.ThreadPoolExecutor。
from concurrent.futures import ThreadPoolExecutor
import time
def worker(name, delay):
    print(f"线程 {name} 开始")
    time.sleep(delay)
    print(f"线程 {name} 结束")
    return f"结果 {name}"
with ThreadPoolExecutor(max_workers=2) as executor:
    future1 = executor.submit(worker, "A", 2)
    future2 = executor.submit(worker, "B", 3)
    print(future1.result())
    print(future2.result())
print("所有线程已完成")
线程池的优势在于管理成本更低,也更适合服务端、爬虫、批量下载这类重复提交 I/O 任务的场景。
但要注意,多线程并不能有效解决 CPU 密集型计算问题。原因不是线程 API 不够强,而是 GIL 会让这类任务难以真正并行。
多进程:CPU 密集任务的主要选择
当瓶颈在计算而不是等待时,多进程通常比多线程更合适。multiprocessing 通过启动多个独立进程,绕过 GIL 的限制,让多个 CPU 核心真正参与计算。
基础写法
from multiprocessing import Process
import time
def worker(name, delay):
    print(f"进程 {name} 开始")
    time.sleep(delay)
    print(f"进程 {name} 结束")
if __name__ == "__main__":
    process1 = Process(target=worker, args=("A", 2))
    process2 = Process(target=worker, args=("B", 3))
    process1.start()
    process2.start()
    process1.join()
    process2.join()
    print("所有进程已完成")
和线程相比,进程之间的隔离更强,但创建和切换成本也更高,因此更适合“算得重”的任务,而不是“等得多”的任务。
进程池更适合批量计算
如果要反复执行多个计算任务,通常会直接上 ProcessPoolExecutor,避免频繁创建和销毁进程。
from concurrent.futures import ProcessPoolExecutor
import time
def worker(name, delay):
    print(f"进程 {name} 开始")
    time.sleep(delay)
    print(f"进程 {name} 结束")
    return f"结果 {name}"
if __name__ == "__main__":
    with ProcessPoolExecutor(max_workers=2) as executor:
        future1 = executor.submit(worker, "A", 2)
        future2 = executor.submit(worker, "B", 3)
        print(future1.result())
        print(future2.result())
    print("所有进程已完成")
如果你的任务是大规模数据处理、批量数值运算或其他明显吃 CPU 的工作,这一类写法通常比线程更对路。
asyncio:高并发 I/O 的另一条路
除了线程,Python 还提供了异步编程模型。asyncio 的核心不是“同时跑很多代码”,而是“遇到等待时先让出执行权”,因此特别适合高并发、短连接、等待时间密集的 I/O 场景。
基础写法
import asyncio
async def worker(name, delay):
    print(f"任务 {name} 开始")
    await asyncio.sleep(delay)
    print(f"任务 {name} 结束")
    return f"结果 {name}"
async def main():
    tasks = [
        asyncio.create_task(worker("A", 2)),
        asyncio.create_task(worker("B", 3))
    ]
    results = await asyncio.gather(*tasks)
    for result in results:
        print(result)
# 运行异步主函数
asyncio.run(main())
这里的关键语法是 async / await。协程由事件循环调度,等待时不会像阻塞调用那样卡住整个程序。
配合异步库才有实际价值
asyncio 真正发挥作用,通常要搭配异步 I/O 库使用,比如 aiohttp、aiomysql。如果底层依然是阻塞库,异步优势就会被抵消。
import asyncio
import aiohttp
async def fetch(session, url):
    async with session.get(url) as response:
        return await response.text()
async def main():
    urls = [
        "http://example.com",
        "http://python.org",
        "http://github.com"
    ]
    async with aiohttp.ClientSession() as session:
        tasks = [fetch(session, url) for url in urls]
        pages_content = await asyncio.gather(*tasks)
        for content in pages_content:
            print(f"下载了 {len(content)} 字节")
asyncio.run(main())
如果是高并发抓取、接口聚合、长连接服务这类场景,asyncio 往往会比传统线程方案更节省资源;但如果团队对异步栈不熟,维护成本也需要一并算进去。
concurrent.futures:统一管理线程池和进程池
如果你不想直接操作底层线程或进程,concurrent.futures 是更容易落地的一层封装。它把提交任务、等待结果、处理异常的方式统一起来,代码结构会更整齐。
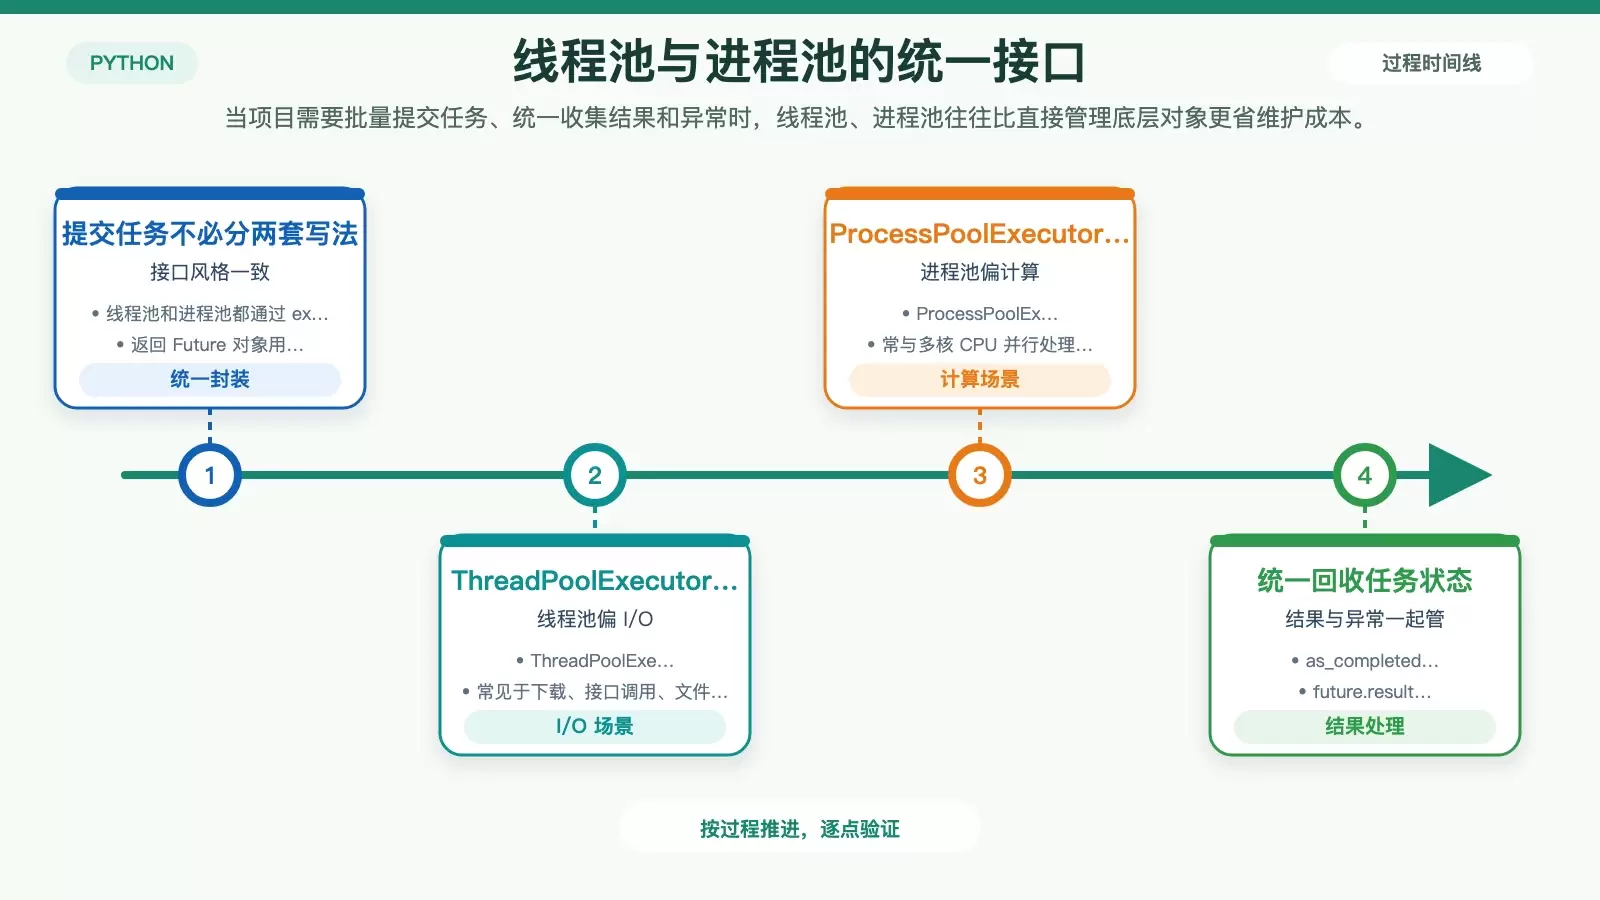
ThreadPoolExecutor:偏 I/O 的默认选择
from concurrent.futures import ThreadPoolExecutor, as_completed
import time
def worker(name, delay):
    print(f"线程 {name} 开始")
    time.sleep(delay)
    print(f"线程 {name} 结束")
    return f"结果 {name}"
with ThreadPoolExecutor(max_workers=3) as executor:
    futures = [executor.submit(worker, f"任务-{i}", i) for i in range(1, 4)]
    for future in as_completed(futures):
        print(future.result())
print("所有线程已完成")
ProcessPoolExecutor:偏计算的常用封装
from concurrent.futures import ProcessPoolExecutor, as_completed
import time
def compute(n):
    print(f"计算 {n} 开始")
    time.sleep(2)
    result = n * n
    print(f"计算 {n} 结束")
    return result
with ProcessPoolExecutor(max_workers=2) as executor:
    futures = [executor.submit(compute, i) for i in range(1, 5)]
    for future in as_completed(futures):
        print(f"结果: {future.result()}")
print("所有计算已完成")
如果只是需要一套统一的并发接口,而不是深入控制线程或进程生命周期,这个模块通常已经够用。
第三方协程库:比如 gevent、eventlet
除了标准库里的 asyncio,还有一类第三方协程库,例如 gevent、eventlet。它们的特点是更偏“自动化”,常通过打补丁的方式,把标准库中的阻塞操作改成可协作调度的非阻塞行为。
import gevent
from gevent import monkey
import time
# 打补丁,使标准库中的阻塞操作变为非阻塞
monkey.patch_all()
def worker(name, delay):
    print(f"协程 {name} 开始")
    gevent.sleep(delay)
    print(f"协程 {name} 结束")
def main():
    tasks = [
        gevent.spawn(worker, "A", 2),
        gevent.spawn(worker, "B", 3),
        gevent.spawn(worker, "C", 1)
    ]
    gevent.joinall(tasks)
    print("所有协程已完成")
if __name__ == "__main__":
    main()
这类方案在一些历史项目或特定框架生态中仍然常见,但新项目是否采用,通常要看现有技术栈和团队经验,而不是只看“写起来省不省事”。
实际开发里最容易踩的 5 个坑
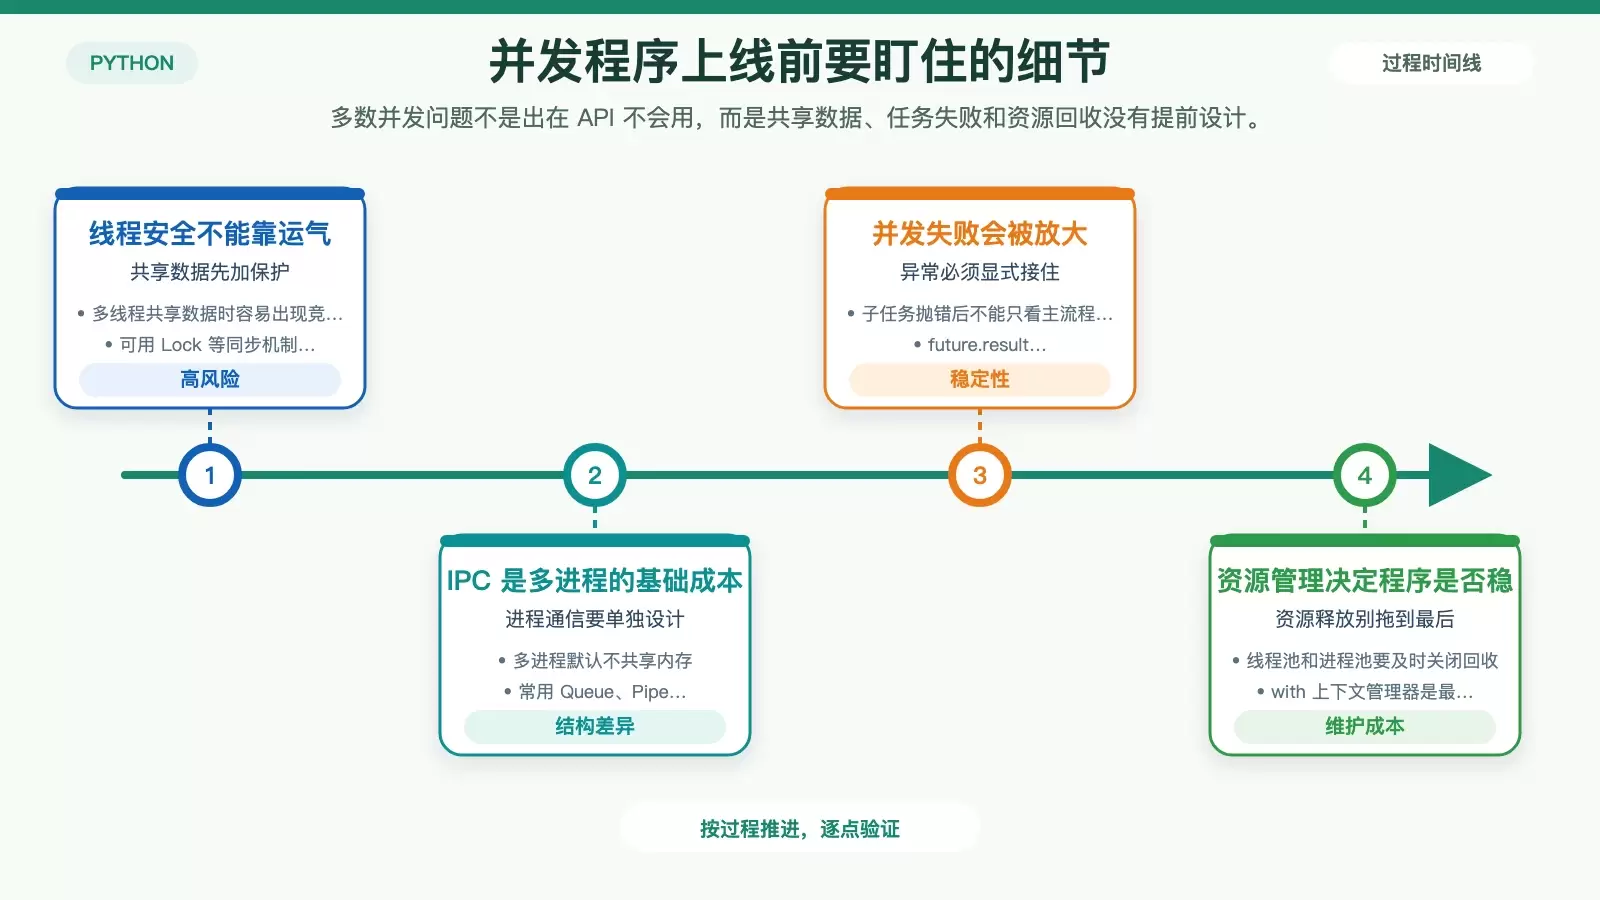
选型只是第一步,真正上线时,稳定性问题往往出在细节上。下面这几个点最值得提前处理。
1. 线程安全
多线程共享数据时,最容易出现竞争条件。常见做法是用 Lock 等同步机制保护临界区。
import threading
lock = threading.Lock()
shared_resource = 0
def increment():
    global shared_resource
    with lock:
        shared_resource += 1
        print(f"共享资源: {shared_resource}")
threads = [threading.Thread(target=increment) for _ in range(10)]
for t in threads:
    t.start()
for t in threads:
    t.join()
2. 进程间通信(IPC)
多进程默认不共享内存,数据传递通常要依赖 Queue、Pipe 等机制。
from multiprocessing import Process, Queue
def worker(q, n):
    q.put(n * n)
if __name__ == "__main__":
    q = Queue()
    processes = [Process(target=worker, args=(q, i)) for i in range(5)]
    for p in processes:
        p.start()
    for p in processes:
        p.join()
    results = []
    while not q.empty():
        results.append(q.get())
    print("结果:", results)
3. 异常处理
并发任务里只要有一个子任务失败,就可能影响整体流程,因此不能只提交任务、不处理结果。
from concurrent.futures import ThreadPoolExecutor
def worker(n):
    if n == 3:
        raise ValueError("错误发生")
    return n * n
with ThreadPoolExecutor(max_workers=2) as executor:
    futures = [executor.submit(worker, i) for i in range(5)]
    for future in futures:
        try:
            result = future.result()
            print(f"结果: {result}")
        except Exception as e:
            print(f"任务出错: {e}")
4. 资源管理
线程池、进程池如果不及时关闭,容易留下资源占用问题。使用 with 上下文管理器,是最稳妥也最省事的写法。
5. 先按任务类型选,再谈风格偏好
经验上,一个足够实用的判断原则是:
- I/O 密集型:优先考虑多线程或异步编程。
- CPU 密集型:优先考虑多进程。
在这个前提下,再去比较代码复杂度、部署环境和团队维护成本,选型通常就不会跑偏。
总结:别先问“线程还是异步”,先看任务瓶颈
Python 提供了多线程、多进程、asyncio、concurrent.futures 以及 gevent 这类第三方协程库,工具并不少,真正难的是用对场景。简单理解就是:等待多,用线程或异步;计算重,用多进程;想统一管理任务,优先看 concurrent.futures。把这个判断顺序建立起来,后面再看性能和代码复杂度,决策会清晰很多。









