

Python爬虫进阶:requests-html库入门与实战

本文详细介绍Python爬虫库requests-html的安装与核心用法。该库封装了Requests、PyQuery等工具,支持JavaScript渲染。通过获取链接、抓取博客新闻标题及下载壁纸等实例,展示其简化爬虫开发的强大能力,适合Python初学者快速上手。
requests-html库简介与安装
在使用Python进行开发的场景中,开发者通常对Requests库非常熟悉。这是一个用于发送HTTP请求的轻量级且功能强大的库,常被选作基于HTTP协议的接口测试首选工具。鉴于其简洁性和高效性,知名开发者Kenneth Reitz进一步推出了requests-html库,专门用于优化爬虫开发体验。
自今年3月发布以来,该项目在GitHub上已获得超过7K的Star,显示出极高的社区关注度。
GitHub项目地址:
https://github.com/kennethreitz/requests-html
requests-html并非从零构建,而是基于PyQuery、Requests、lxml以及beautifulsoup4等现有成熟框架进行的二次封装。作者成功地将Requests库中简单且强大的设计理念融入其中,使得爬虫代码更加简洁易读。
安装过程十分简便,只需执行以下命令:
pip install requests-html
基础用法:抓取静态网页链接
以下是具体的教程与使用示例:
首先,我们尝试使用GET请求访问 https://python.org 网站。
为了理解其基本用法,我们先回顾一下requests的基础操作。
from requests_html import HTMLSession
session = HTMLSession()

r = session.get('https://python.org/')

# 获取页面上的所有链接。
all_links = r.html.links
print(all_links)

# 获取页面上的所有链接,以绝对路径的方式。
all_absolute_links = r.html.absolute_links
print(all_absolute_links)
实战案例:抓取博客新闻与下载壁纸
对于IT技术人员而言,关注科技圈动态是日常工作的一部分。我们可以尝试从博客园新闻频道抓取最新的推荐新闻列表。
from requests_html import HTMLSession
session = HTMLSession()
r = session.get("https://news.cnblogs.com/n/recommend")
# 通过CSS找到新闻标签
news = r.html.find('h2.news_entry > a')
for new in news:
  print(new.text) # 获得新闻标题
  print(new.absolute_links) # 获得新闻链接
执行上述代码后的结果如下:
雷军:小米硬件综合净利率永远不超5%! {'https://news.cnblogs.com/n/595156/'} 苦大仇深的“中国芯”,不妨学一学有趣的树莓派 {'https://news.cnblogs.com/n/595143/'} 我的快递,凭什么不能给我送到家! {'https://news.cnblogs.com/n/595087/'} 倪光南回应方舟CPU失败论:企业失败不等于技术失败 {'https://news.cnblogs.com/n/595102/'} 清华大学突破纪录:首次实现25个量子接口间量子纠缠 {'https://news.cnblogs.com/n/595103/'} 定向免流量套餐用着爽,但背后的“坑”你可能不知道 {'https://news.cnblogs.com/n/595061/'} 你在微信群侃大山,有人却用微信群发大财 {'https://news.cnblogs.com/n/595059/'} 马云的三观 {'https://news.cnblogs.com/n/595047/'} 美国科技强大的全部秘密 {'https://news.cnblogs.com/n/595043/'} 盖茨看着听证会上的扎克伯格:满眼都是20年前的自己 {'https://news.cnblogs.com/n/595025/'} 史上最清晰癌细胞转移3D影像来袭 {'https://news.cnblogs.com/n/595019/'} 中兴员工:华为仅部分芯片自己设计 谁被美制裁都得死 {'https://news.cnblogs.com/n/594967/'} 作为曾经的华为员工,我想替中兴公司说两句公道话 {'https://news.cnblogs.com/n/594962/'} 匿名网友回评梁宁:方舟bug无数 贴钱给别人都未必用 {'https://news.cnblogs.com/n/594932/'} 一段关于国产芯片和操作系统的往事 {'https://news.cnblogs.com/n/594900/'} 芯片股总市值低于美国巨头 有公司靠政府补助盈利 {'https://news.cnblogs.com/n/594902/'} 被自家律师送上“枪口”的“二流”中兴 {'https://news.cnblogs.com/n/594859/'} Google正在失去DeepMind? {'https://news.cnblogs.com/n/594853/'}
扩展应用:我们可以进一步对抓取到的数据进行持久化处理,从而构建出个性化的“新闻头条”聚合页面。
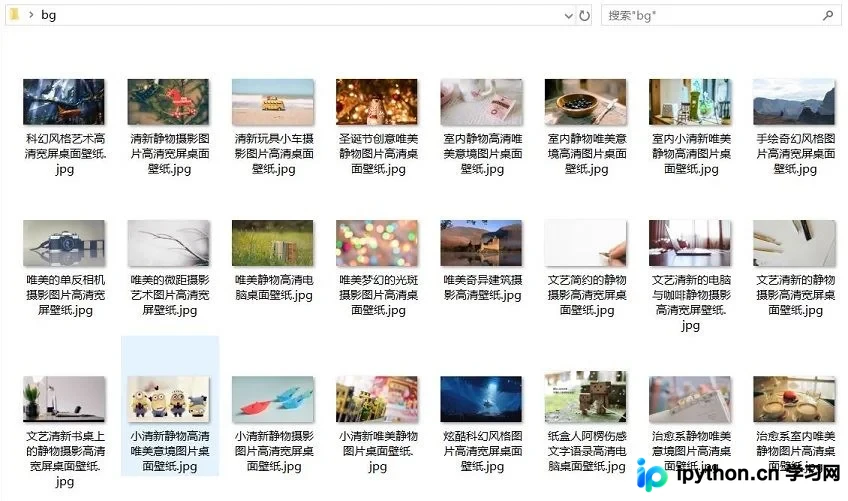
接下来,我们尝试从网站上下载壁纸,以美桌网(www.win4000.com)为例进行演示。
from requests_html import HTMLSession
import requests


# 保存图片到bg/目录
def save_image(url, title):
  img_response = requests.get(url)
  with open('./bg/'+title+'.jpg', 'wb') as file:
    file.write(img_response.content)

# 背景图片地址,这里选择1920*1080的背景图片
url = "http://www.win4000.com/wallpaper_2358_0_10_1.html"

session = HTMLSession()
r = session.get(url)

# 查找页面中背景图,找到链接,访问查看大图,并获取大图地址
items_img = r.html.find('ul.clearfix > li > a')
for img in items_img:
  img_url = img.attrs['href']
  if "/wallpaper_detail" in img_url:
    r = session.get(img_url)
    item_img = r.html.find('img.pic-large', first=True)
    url = item_img.attrs['src']
    title = item_img.attrs['title']
    print(url+title)
    save_image(url, title)
该网站上的图片资源相对容易获取,前文代码块中已添加详细注释,此处不再赘述具体逻辑。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









