

Python函数与参数进阶:性能优化、最佳实践与避坑要点

优化函数与参数设计:减少冗余与不必要计算
在函数设计中,合理的参数结构能显著降低冗余计算。避免在循环或高频调用中重复执行相同逻辑,应将不变的计算提取到函数外部或使用默认参数缓存。例如,处理数据过滤时,若正则表达式或配置字典在多次调用中不变,应将其作为默认参数或闭包变量传入,而非每次重新编译。使用 *args 和 **kwargs 可提升接口灵活性,但过度依赖会增加解析开销,建议明确核心参数。拆分函数时,避免将单一职责拆成过深嵌套的调用链,这会增加栈帧开销并降低可读性。通过参数前置校验与提前返回(Early Return),可跳过无效分支,直接提升执行路径效率。
掌握参数最佳实践:类型、默认值与参数传递
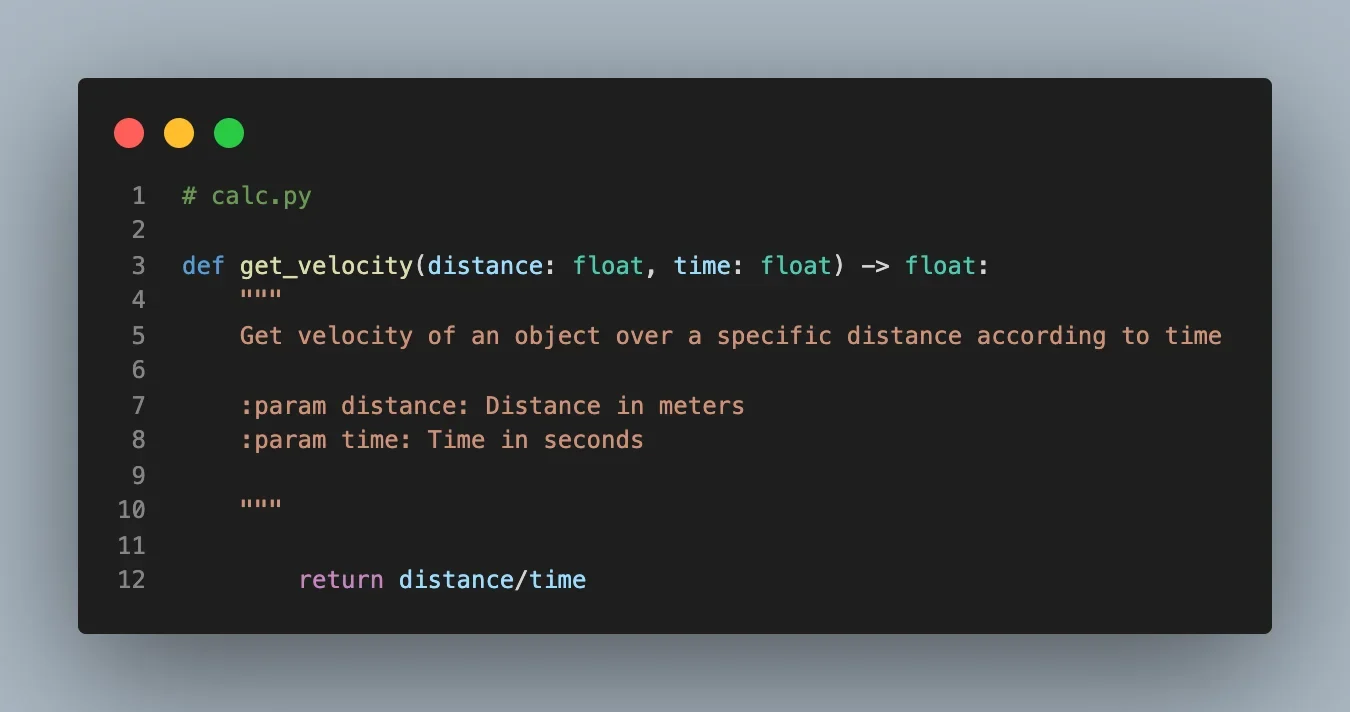
Python 3.8+ 引入了仅限位置参数(/)与仅限关键字参数(*),合理划分可防止调用方误传参数。例如 def process(data, /, *, verbose=False): 强制 data 必须按位置传入,verbose 必须显式命名,提升接口稳定性。结合类型提示(Type Hints)如 def calc(x: float, y: int) -> float:,配合 mypy 可在静态检查阶段拦截类型错误。默认值设计需严格遵循“不可变对象”原则,绝对避免使用 def add_item(item, lst=[]),因为列表在函数定义时仅创建一次,多次调用会共享同一对象。正确做法是 def add_item(item, lst=None): lst = lst or [],确保每次调用获得独立实例。
提升函数执行效率:缓存、生成器与调用开销
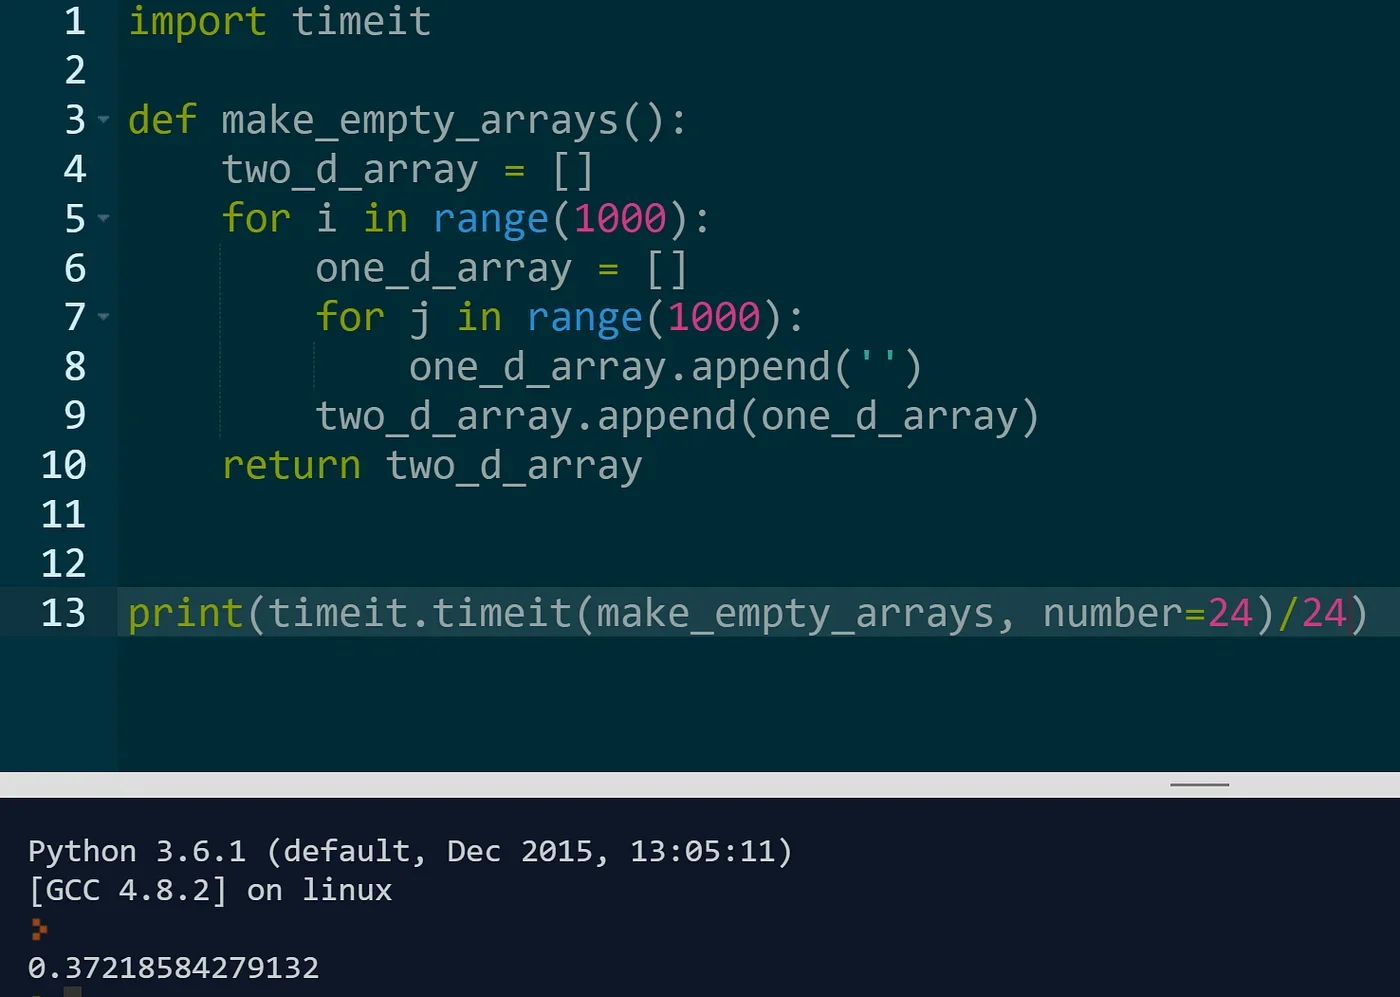
函数调用本身存在栈帧创建与参数解析开销,高频调用时应尽量减少不必要的函数层级。对于纯函数(相同输入必得相同输出),可使用 functools.lru_cache 装饰器实现结果缓存,避免重复计算。例如斐波那契数列递归加入 @lru_cache(maxsize=None) 后,时间复杂度从指数级降至线性。处理大规模数据时,优先使用生成器(yield)替代返回列表,生成器按需产出元素,大幅降低内存峰值与分配耗时。验证优化效果可借助内置 timeit 模块进行基准测试,例如 timeit.timeit('func()', setup='from __main__ import func', number=10000),通过对比优化前后的耗时数据,量化性能收益。
规避高频陷阱:作用域、可变对象与副作用
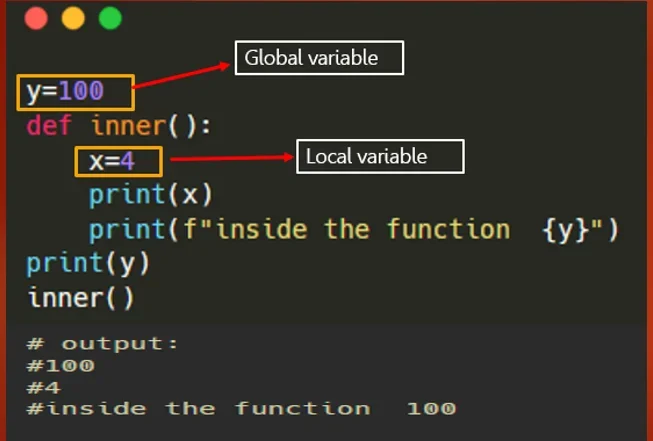
函数内部修改传入的可变对象(如列表、字典)会引发隐蔽的副作用,破坏调用方的数据状态。例如 def update_config(cfg): cfg['timeout'] = 10 会直接修改原字典,正确做法是使用 cfg.copy() 或 copy.deepcopy() 创建副本后再操作。作用域方面,Python 遵循 LEGB 规则,在函数内直接赋值同名变量会创建局部变量,若需修改全局变量必须使用 global 声明,但应尽量避免,推荐通过参数传入与返回值传出数据。递归函数若缺乏终止条件或深度过大,易触发 RecursionError,可改用迭代或手动转循环。始终遵循“无副作用”原则,确保函数行为可预测。
验证优化结果:测试、调试与可维护性检查
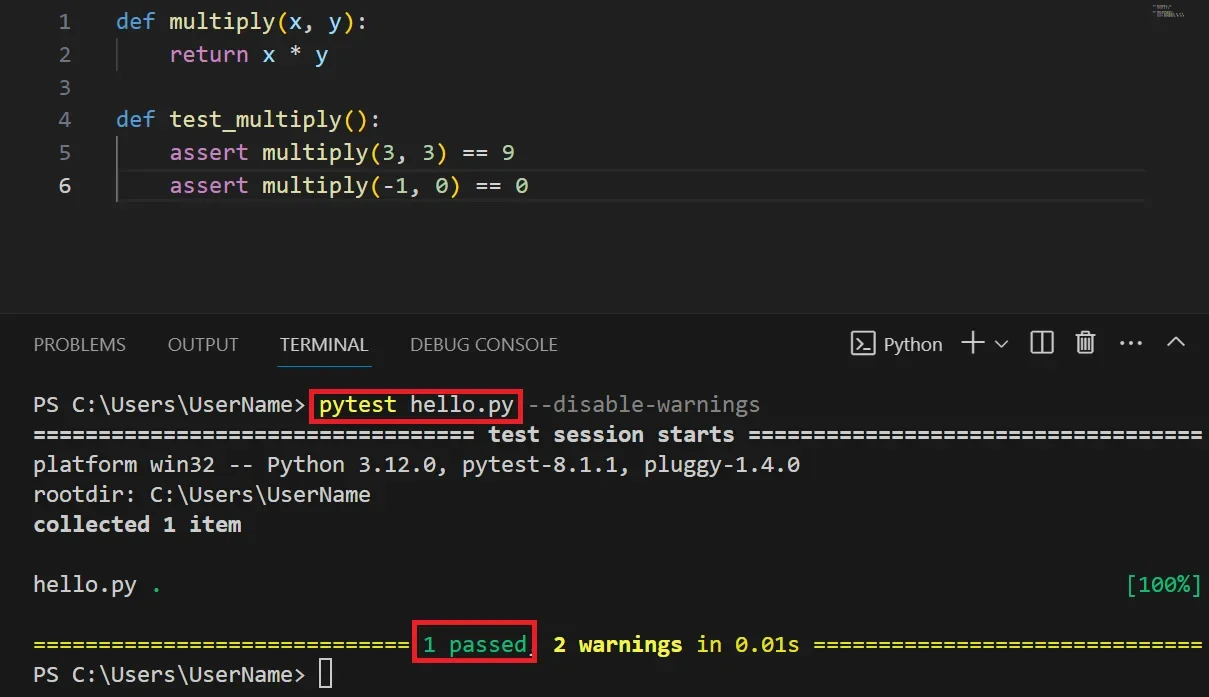
任何性能优化都必须通过严格的验证流程,确保未破坏原有逻辑。使用 pytest 编写单元测试,覆盖正常路径、边界条件(如空输入、极大值)及异常分支,利用 pytest.mark.parametrize 批量验证多组参数。性能验证可结合 cProfile 进行函数级剖析,定位热点代码,避免盲目优化。代码可维护性方面,优化不应牺牲可读性,复杂逻辑需补充文档字符串(Docstring)与类型注解。通过 flake8 检查代码规范,mypy 验证类型安全,确保重构后的函数符合团队标准。最终在 CI/CD 流水线中集成测试与基准检查,形成自动化质量门禁,保障函数在演进过程中保持高效与稳定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









