


在 Go 项目里遇到 import cycle not allowed,通常不是某一行导入写错这么简单,而是包之间已经形成了闭环。要把这个问题真正处理干净,关键不只是消除报错,还要判断依赖关系为什么会反向生长、应该在哪一层断开,以及用什么方式调整后续最不容易再犯。
这篇文章按“先定位、再拆解、最后预防”的顺序来整理:先看循环依赖为什么会被 Go 严格禁止,再用 go list 找到具体依赖链,接着对比几种常见改法各自适合的场景,最后给出包设计时更稳妥的判断标准。
为什么 Go 会直接拒绝循环依赖
所谓循环依赖,就是两个或多个包互相导入,最终形成闭环。最简单的情况是包 A 导入包 B,同时包 B 又导入包 A;更复杂一点,则可能是 A → B → C → A。
Go 编译器对这类结构的态度非常明确:直接报错,不允许继续编译。原因不只是语法限制,而是包初始化顺序无法确定。一旦依赖链成环,编译器无法判断应该先初始化哪个包,这会让构建过程失去确定性。
所以,import cycle not allowed 本质上是在暴露架构问题。它通常意味着:
- 包职责边界没有切清楚
- 高层和低层代码互相知道对方实现
- 共享模型、工具方法或接口被放错了位置
从维护角度看,这类问题比单纯的编译失败更值得重视。因为即便你用某种方式勉强绕过去,后续测试、替换实现和扩展模块时,耦合问题还会继续放大。
先定位:用 go list 找到依赖闭环
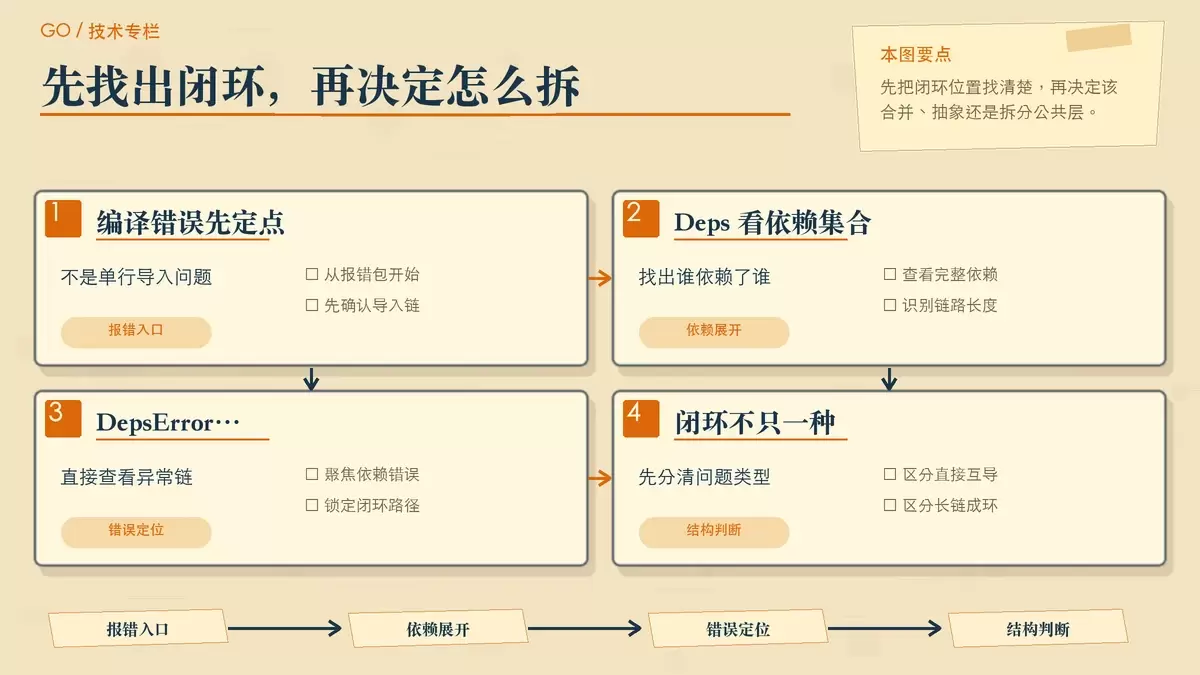
处理循环依赖之前,先把依赖链找出来。Go 自带的 go list 就足够实用,尤其适合在包数量开始变多时快速排查。
# 查看包的依赖关系
go list -f '{{join .Deps "n"}}' <包路径>

# 检查依赖错误
go list -f '{{join .DepsErrors "n"}}' <包路径>
第一条命令适合查看某个包展开后的依赖集合,第二条命令则更适合直接看依赖错误信息。实际排查时,可以从报错包开始,一层层确认它依赖了谁,再结合错误输出锁定闭环出现的位置。
这一步的目标不是把所有依赖都可视化,而是先回答三个问题:
- 是两个包直接互相导入,还是更长链路形成的环
- 闭环中的哪一个包承担了不该承担的职责
- 这个依赖是结构性依赖,还是只是某个函数、模型、回调临时借用造成的
只有先分清楚问题类型,后面的改法才不会用错力。比如明明只是共享结构体放错地方,却去上依赖注入框架,成本就明显偏高。
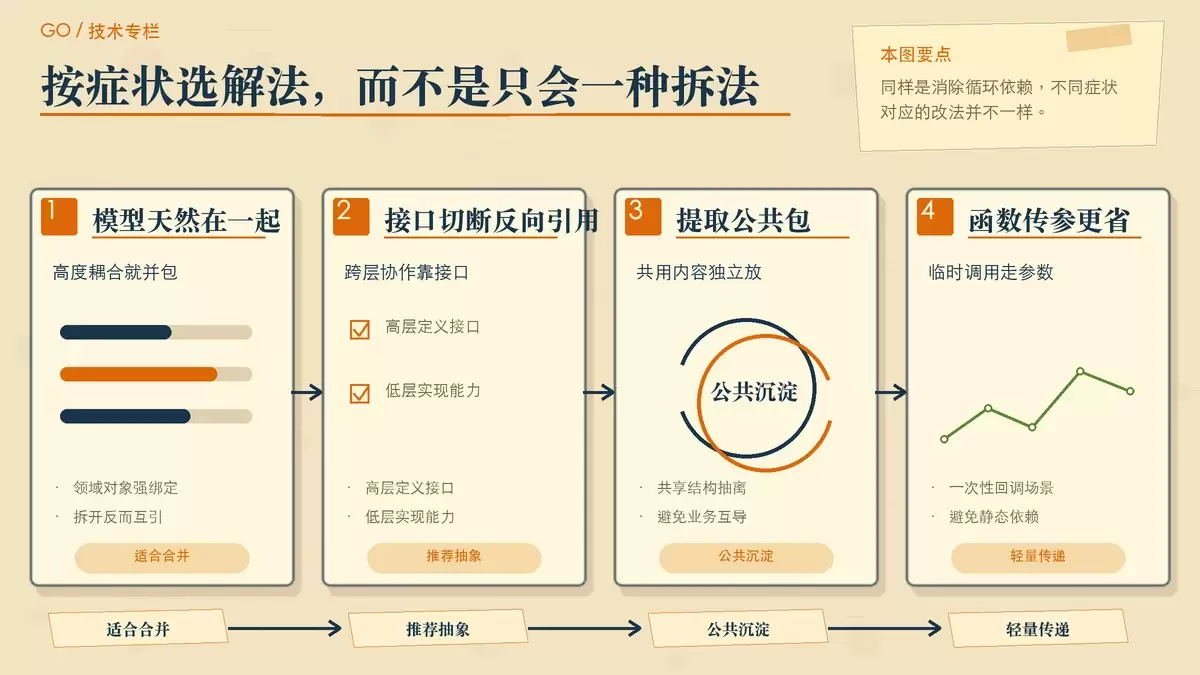
五种常见解法,分别适合什么场景
1. 高度耦合时,直接合并包
如果两个包的概念本来就分不开,最直接的办法往往不是继续拆,而是合并。很多循环依赖其实来自“为了分包而分包”,结果把天然属于同一领域模型的内容硬拆成两个目录。
一个典型例子是 person 和 team:Person 里要引用 Team,而 Team 又要维护 Person 列表。两边都在表达同一组领域对象关系时,把它们放进同一个 models 包往往更自然。
// models/models.go
package models

type Person struct {
    ID   int
    Name string
    Team *Team
}

type Team struct {
    ID     int
    Name   string
    People []*Person
}
这种方式的优点是简单、明确,没有额外抽象成本。前提是你确认两者确实属于同一职责边界,而不是暂时写在一起看起来方便。
2. 需要跨层协作时,用接口做解耦
如果问题不是模型天然绑定,而是高层业务和底层实现互相引用,那么更合适的做法通常是引入接口,让双方都依赖抽象,而不是依赖彼此的具体实现。这也是依赖倒置原则在 Go 项目中的常见落地方式。
常见做法有三步:
- 在高层包中定义自己需要的接口
- 由低层包去实现这个接口
- 通过依赖注入把实现传进来
// 定义接口的包
package notifier

type Notifier interface {
    Send(message string) error
}

// 业务包A
package service

import "your/project/notifier"

type MyService struct {
    notifier notifier.Notifier
}

// 业务包B实现接口
package handler

import "your/project/notifier"

type EmailHandler struct{}

func (e *EmailHandler) Send(message string) error {
    // 实现发送逻辑
    return nil
}这样一来,service 只关心“有人能发送消息”,不需要知道具体是邮件、短信还是别的实现;而 handler 也不必反向依赖业务层。对于需要测试替身、替换实现、逐步演进模块的项目,这种结构通常比直接互调稳定得多。
3. 共享模型和工具时,提取到独立公共包
很多循环依赖并不是业务互相调用,而是两个包都想复用同一个结构体、常量或工具函数,于是你 import 我、我 import 你,最后形成闭环。遇到这种情况,更合理的方向通常是把公共部分单独提出来。
适合提取的内容通常包括:
- 数据模型(Model)
- 工具函数(Utilities)
- 常量定义
- 接口定义
// 创建共享包
package common

type User struct {
    ID   int
    Name string
}

// 其他包导入common包,而不是相互导入
这样做的收益是依赖方向会更清晰:多个业务包共同依赖 common,而不是业务包之间横向穿插引用。不过这里也要控制抽象力度。如果为了消除一个小问题就把大量并不稳定的内容塞进公共包,后面很容易把 common 演变成新的“大杂烩”。
4. 复杂对象关系下,用依赖注入管理装配
当项目已经进入多模块协作阶段,对象创建链很长,靠手工在各层之间传递依赖开始变得繁琐时,可以考虑使用依赖注入(DI)统一管理装配关系。
这类方法的核心价值,在于把“谁依赖谁”的源码级直接引用,转成由外部装配流程来决定。文中提到的 Google Wire 就属于 Go 生态里较常见的 DI 工具。它的意义不在于替你消灭设计问题,而是在复杂结构下,把依赖组织得更可控。
这里有一个很重要的判断:DI 更适合解决“对象如何组装”的复杂度,而不是替代基本的包边界设计。如果两个包职责本身就纠缠不清,先修边界,再谈框架;否则只是把问题藏起来。
5. 只是临时调用时,用函数参数传递依赖
有些依赖其实非常轻,只是包 B 需要在某个时刻调用包 A 的一段逻辑。这种场景下,如果为了这一次调用建立包级导入关系,往往得不偿失。更轻量的办法,是把需要的能力通过函数参数或回调传进去。
// 包B定义函数接受回调
package b

type Callback func() string

func Execute(cb Callback) {
    result := cb()
    // 使用结果
}

// 包A传递函数实现
package a

func doWork() string {
    return "结果"
}

func Run() {
    b.Execute(doWork)  // 注入依赖
}
这种写法的好处是,不需要为了一个小型交互建立长期静态依赖,也不会把两个包硬绑在一起。它尤其适合简单流程编排、一次性回调、轻量扩展点等场景。
当然,如果传来传去的函数越来越多、回调签名越来越复杂,就说明需求已经超出这个方案的舒适区,应该回到接口或分层设计上重新整理。
比修错更重要的是:从包设计上预防循环依赖
真正稳定的做法,是在项目增长过程中尽量别把依赖画成环。相比报错后再拆,前期把边界和方向定清楚,成本低得多。
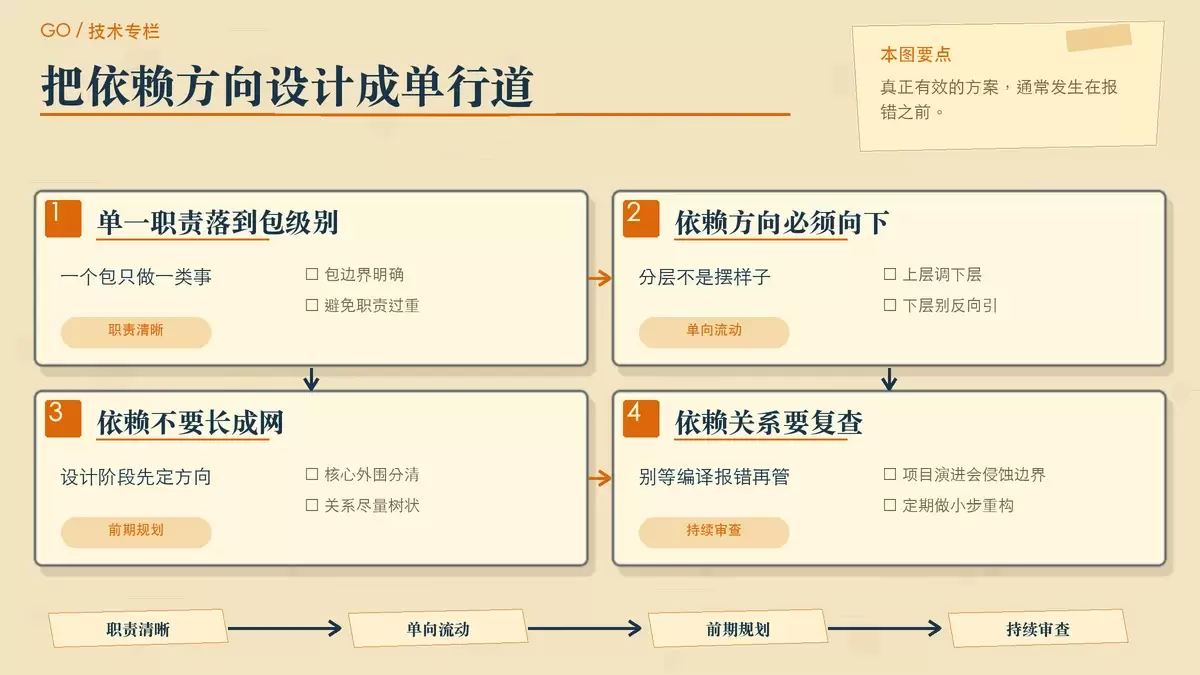
单一职责要落到包级别
每个包都应该有相对清晰、单一的职责。如果一个包既管业务规则、又管数据存储、还顺手放了对外接口和工具函数,它几乎一定会不断向外伸出依赖,最后也更容易吸回反向依赖。
分层后,依赖方向必须单向
采用表现层 → 业务层 → 数据层这样的分层结构时,关键不只是“看起来分了层”,而是依赖必须始终向下单向流动。上层可以调用下层,下层不要反向 import 上层。很多循环依赖,就是从某个下层模块“顺手”引用了上层类型或逻辑开始的。
在设计阶段就规划依赖方向
包之间的关系最好在项目初期就做出基本约束。你不一定需要画得非常正式,但至少要清楚哪些模块属于核心、哪些模块属于外围,哪些包可以被广泛依赖,哪些包只能单向使用。理想状态下,依赖关系应该更接近树状,而不是网状缠绕。
定期审查依赖关系,别等到报错再处理
项目演进后,原本清晰的边界很容易被新需求逐渐侵蚀。定期检查包依赖关系,及时做小步重构,比等到编译器直接抛出 import cycle not allowed 再集中治理更省成本。
换句话说,循环依赖不是单点 bug,而是包设计在提醒你:当前结构已经不适合继续自然扩展。把它当成一次架构体检,往往比只想着“怎么临时消掉错误”更有价值。
遇到循环依赖时,先问该拆哪里,而不是急着补技巧
Go 不允许循环依赖,表面上看是编译器限制,实际上是在逼着项目保持清晰的依赖方向。面对这个问题,先用 go list 找到闭环,再判断到底是包该合并、接口该下沉、公共内容该提取,还是只需要把一次性依赖改成参数传递。
最后的判断标准其实很朴素:谁应该知道谁,谁只该依赖抽象,谁根本不该形成静态引用。只要依赖关系始终保持单向,包结构就更容易维护,项目后续扩展也会轻松很多。









