


在 Go 项目里,import cycle not allowed 常被当成一次编译事故处理,但它更像一次架构告警:包之间已经互相牵住,职责边界开始变得模糊。下面从典型场景出发,拆开循环依赖为什么出现、几种常见解法分别适合什么情况,以及重构时该怎样判断,避免只是“把错误修掉”,却把复杂度留在系统里。
循环依赖为什么不只是编译错误
Go 对循环依赖的态度很直接,只要包之间形成闭环,编译就会终止:
import cycle not allowed
package your-project
    imports package-a
    imports package-b
    imports package-a
这个错误信息虽然简短,但指向的问题并不简单。两个模块互相引用,通常意味着它们已经无法独立表达自己的职责:一个包既想保留自己的业务逻辑,又想直接拿到另一个包的内部能力,最后导致边界重叠、依赖方向混乱。
从维护角度看,循环依赖带来的代价往往比编译失败更大:
- 包职责不再单一,读代码时很难判断谁才是业务入口;
- 测试变难,想单独替换一个模块时会被另一端牵制;
- 扩展成本上升,新功能很容易继续沿着旧耦合方向叠加。
所以在 Go 里处理循环依赖,重点不是“绕过去”,而是借这个错误重新审视依赖关系是否合理。
循环依赖通常怎么出现
最常见的情况,是两个业务模块都想顺手调用对方提供的信息。以电商系统里的用户和订单为例:
// user/service.go
package user

import "your-project/order"

type Service struct{}

func (s *Service) GetUserWithOrders(userID int) {
    orders := order.GetOrdersByUser(userID)  // 依赖order包
    // 处理逻辑
}
// order/service.go
package order
import "your-project/user"
type Service struct{}
func (s *Service) GetOrderWithUser(orderID int) {
user := user.GetUserByOrder(orderID) // 依赖user包
// 处理逻辑
}表面看,两个方法都只是“拿一下对方数据”,但放到包层级,问题就出现了:user 依赖 order,order 又依赖 user,闭环已经形成。
这类设计通常暴露出两种更深层的问题:
- 业务编排和领域能力混在一起,服务层既管自己的逻辑,又顺手负责跨模块聚合;
- 包划分过细或过早,概念上仍然紧密耦合的代码被硬拆成多个包。
因此,看到循环依赖时,先不要急着挪 import。更值得先问的是:当前这段调用,到底应该放在领域服务里,还是放到更上层的应用组装层?
五种常见解法,分别适合什么场景
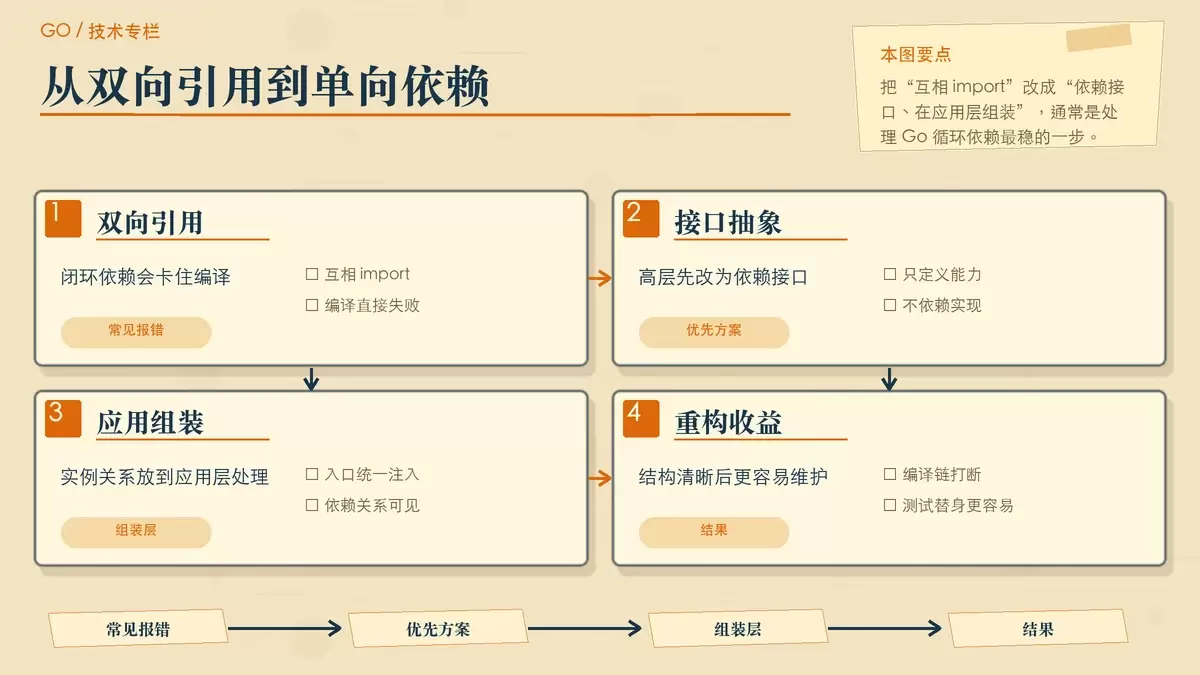
1. 接口抽象:最常用,也最稳妥
多数情况下,优先考虑接口抽象,也就是依赖倒置。核心思路是:高层模块不再直接依赖具体实现,而是只依赖能力定义。
先定义共享接口:
// common/interfaces.go
package common

type UserInfoProvider interface {
    GetUserByID(id int) (*User, error)
}

type OrderInfoProvider interface {
    GetOrdersByUser(userID int) ([]Order, error)
}
然后让高层模块依赖接口:
// order/service.go
package order

import "your-project/common"

type Service struct {
    userProvider common.UserInfoProvider
}

func NewService(up common.UserInfoProvider) *Service {
    return &Service{userProvider: up}
}

func (s *Service) GetOrderDetails(orderID int) {
    user, _ := s.userProvider.GetUserByID(orderID)
    // 使用user信息
}
具体实现则放在低层模块:
// user/service.go
package user

type Service struct{}

func (s *Service) GetUserByID(id int) (*User, error) {
    // 具体实现
    return &User{ID: id}, nil
}
最后在应用层统一组装:
// cmd/main.go
package main

func main() {
    userSvc := &user.Service{}
    orderSvc := order.NewService(userSvc)  // 依赖注入

    // 现在可以正常使用
}
这种方式的价值很明确:
- 编译依赖被彻底打断;
- 接口天然便于 mock,可测试性更好;
- 依赖方向变得清晰,符合 SOLID 中的依赖倒置原则。
它尤其适合“一个模块只需要另一个模块的部分能力”这类场景,而不是整个包的全部实现。
2. 提取公共包:适合共享类型和基础函数
如果循环依赖的根源不是业务互调,而是多个包都需要同一份基础类型、常量或简单工具函数,那么更直接的办法是提取公共包。
// types/user.go
package types

type User struct {
    ID       int
    Name     string
    Email    string
}

// types/order.go
package types

type Order struct {
    ID     int
    UserID int
    Amount float64
}
// utils/convert.go
package utils
func FormatUserInfo(u types.User) string {
return fmt.Sprintf("%s <%s>", u.Name, u.Email)
}不过公共包不是“万能中转站”。使用时要守住几个边界:
- 只放最基础、最稳定的类型和函数;
- 不要在公共包里反向依赖业务逻辑包;
- 尽量减少频繁修改,否则所有依赖它的模块都会被牵动。
换句话说,types、utils 这类包适合承载共性,不适合继续堆放业务编排。否则循环依赖虽然消失了,新的“上帝包”问题又会出现。
3. 依赖注入容器:适合依赖关系较复杂的应用
当项目中的服务很多、初始化顺序明确、依赖链也比较长时,可以把依赖关系集中交给容器或应用层管理,而不是散落在各包内部。
// container/container.go
package container

type Container struct {
    userService  *user.Service
    orderService *order.Service
}

func NewContainer() *Container {
    c := &Container{}

    // 按正确顺序初始化
    c.userService = user.NewService()
    c.orderService = order.NewService(
        WithUserAccessor(c.userService),
    )

    return c
}
// order/options.go
package order
type Option func(*Service)
func WithUserAccessor(accessor interface{}) Option {
return func(s *Service) {
// 设置用户访问器
}
}依赖注入容器本身不一定直接“消灭”循环依赖,但它会强迫你把初始化和业务逻辑拆开。这样做的收益是,模块对外暴露的依赖会变得可见,谁该被创建、谁该被注入、顺序如何安排,都集中在一个地方完成。
这类方法适合中大型应用,尤其是已经存在多个 service、repository、handler 的项目。若项目很小,为了一个简单互调上容器,反而可能把结构做重。
4. 事件驱动架构:适合需要彻底解耦的流程
如果两个模块之间并不是必须同步拿结果,而是一方做完动作后,只需要通知另一方“某件事发生了”,那事件驱动会比直接调用更自然。
// events/events.go
package events

type EventBus struct {
    subscribers map[string][]EventHandler
}

func (eb *EventBus) Publish(e Event) {
    for _, handler := range eb.subscribers[e.Type()] {
        go handler.Handle(e)  // 异步处理
    }
}
// user/event_handler.go
package user
func (s *Service) OnOrderCreated(e events.OrderCreated) {
// 响应订单创建事件
s.updateUserStats(e.UserID)
}// order/service.go
package order
func (s *Service) CreateOrder(params OrderParams) {
// 创建订单逻辑
// 发布事件,而不是直接调用user包
events.Publish(events.OrderCreated{
UserID: params.UserID,
OrderID: order.ID,
})
}这里的关键变化在于,order 不再关心 user 如何处理后续动作,只负责发布 OrderCreated。而 user 是否订阅、如何更新统计,都留在自己的上下文里解决。
这种方式特别适合:
- 订单创建后更新用户状态、积分、通知等后置流程;
- 不要求同步返回结果的跨模块协作;
- 未来可能增加更多订阅者的业务链路。
但也要看到代价:异步处理会增加追踪和调试复杂度,事件定义、失败补偿、幂等等问题都需要提前设计。
5. 合并相关包:有时拆开本身就是错的
并不是所有循环依赖都该通过抽象继续拆。有些时候,真正的问题是包拆分过度,原本属于同一领域的代码被硬切成多个互相缠绕的目录。
// 重构前:
// user/user.go
// order/order.go   (互相依赖)

// 重构后:
// commerce/
//   ├── customer.go    # 用户相关
//   ├── order.go      # 订单相关
//   └── payment.go     # 支付相关
如果两个包几乎总是一起出现,且它们代表的就是同一个领域里的强关联概念,那么继续强拆只会制造更多接口、更多中转层、更多理解成本。
判断是否该合并,可以看三点:
- 两个包是否总是同时被使用;
- 它们是否属于同一领域对象下的紧密概念;
- 为了“解耦”新增的抽象,是否已经比原本业务还复杂。
包的数量不是架构质量。真正重要的是边界是否自然,依赖是否顺着业务流向单向展开。
实战重构:把用户订单系统拆回清晰结构
如果你手上已经有一个出现循环依赖的项目,改造时最怕一次性大动。更可行的方法,是先把依赖点找清,再按结构一步步挪开。
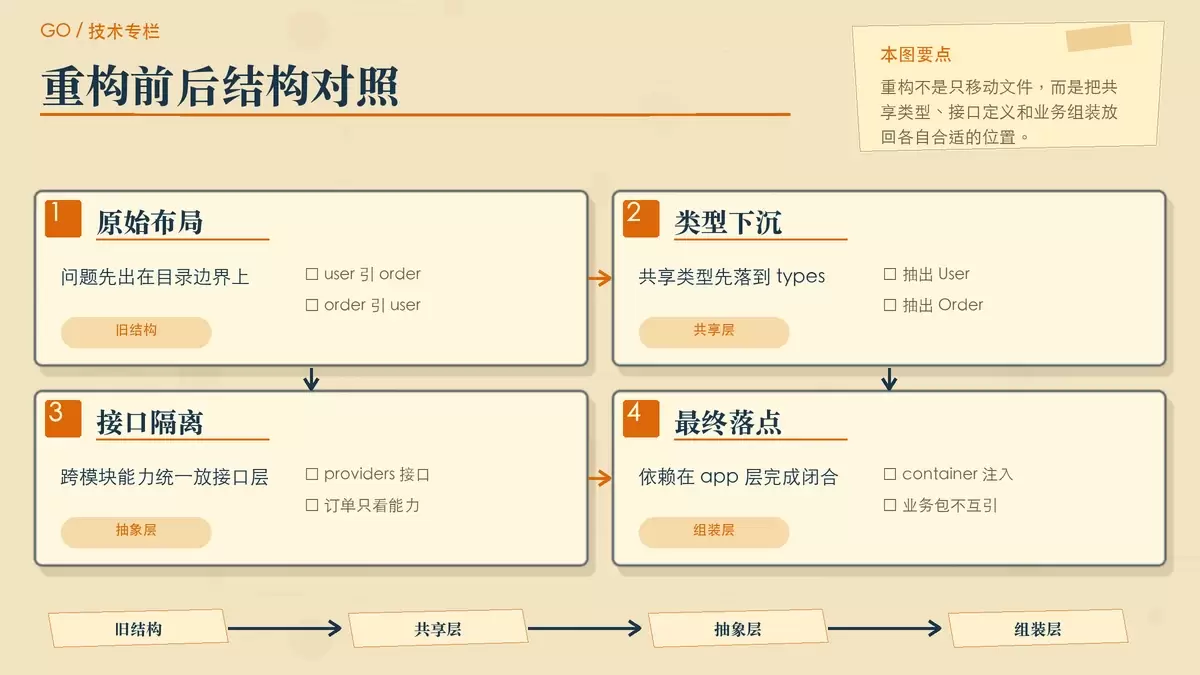
原始结构通常长这样:
pkg/
├── user/
│   ├── service.go     # import "order"
│   └── repository.go
└── order/
    ├── service.go     # import "user"
    └── repository.go
改造后的目标结构:
pkg/
├── types/            # 共享数据类型
│   ├── user.go
│   └── order.go
├── interfaces/       # 抽象接口
│   └── providers.go
├── user/            # 用户模块
│   ├── service.go
│   ├── repository.go
│   └── impl/        # 接口实现
│       └── user_provider.go
├── order/           # 订单模块
│   ├── service.go   # 只依赖interfaces
│   └── repository.go
└── app/             # 应用组装层
    └── container.go # 依赖注入
这套结构的重点,不是目录看起来更完整,而是依赖方向被重新整理过:
types只放共享数据;interfaces只定义能力抽象;order不再直接 importuser;- 真正的组装工作交给
app/container.go。
可以按下面五步推进:
- 先提取共享类型到
types包; - 把跨模块需要的能力定义到
interfaces包; - 修改
order服务,让它只依赖接口; - 在
user包里实现这些接口; - 最后在应用层完成实例组装和注入。
这样改的好处是,编译错误会尽早消失,但结构上的收益也能保留下来。后续无论加测试、换实现,还是继续拆分业务,都有明确着力点。
怎么预防下一次再出现循环依赖
修掉一次循环依赖不难,难的是避免它在下一个需求里重新长出来。比起事后救火,更有效的是在代码审查和架构设计阶段提前设限。
代码审查时重点看什么
- 新增的
import是否真的有必要; - 一个包是否开始承担多种职责;
- 是否已经出现双向 import 的苗头。
设计时尽量坚持这三个原则
- 单向依赖:依赖关系应该沿着清晰方向流动,避免回头;
- 稳定抽象:上层依赖接口,下层负责实现细节;
- 包内高内聚:同一领域的强相关逻辑尽量放在一起。
实践里还可以加一条经验:只要某个服务函数既处理本模块逻辑,又主动聚合另一个模块的详细数据,就要警惕它是不是越过了边界。很多循环依赖,都是从这种“顺手调用”开始的。
回到文章开头那个错误,循环依赖 从来不只是编译器的限制,它更像 Go 强行帮你做了一次架构体检。优先考虑接口抽象,必要时提取公共包、引入依赖注入或事件驱动;如果拆分本身不合理,就果断合并包。只要包边界清晰、依赖方向单向,Go 项目的可维护性通常就会稳很多。









