


很多人第一次看到 Go 泛型里的 ~int,都会把注意力放在那个波浪线上,却不太确定它到底改变了什么。真正需要理解的不是“一个新符号”,而是 Go 怎样在泛型里把“类型本身”和“底层类型相同的一组类型”区分开来。读完这篇文章,你可以判断什么时候该写 int,什么时候必须写 ~int,以及它在切片、组合约束里为什么并不会无限放宽匹配范围。
为什么会有 ~int
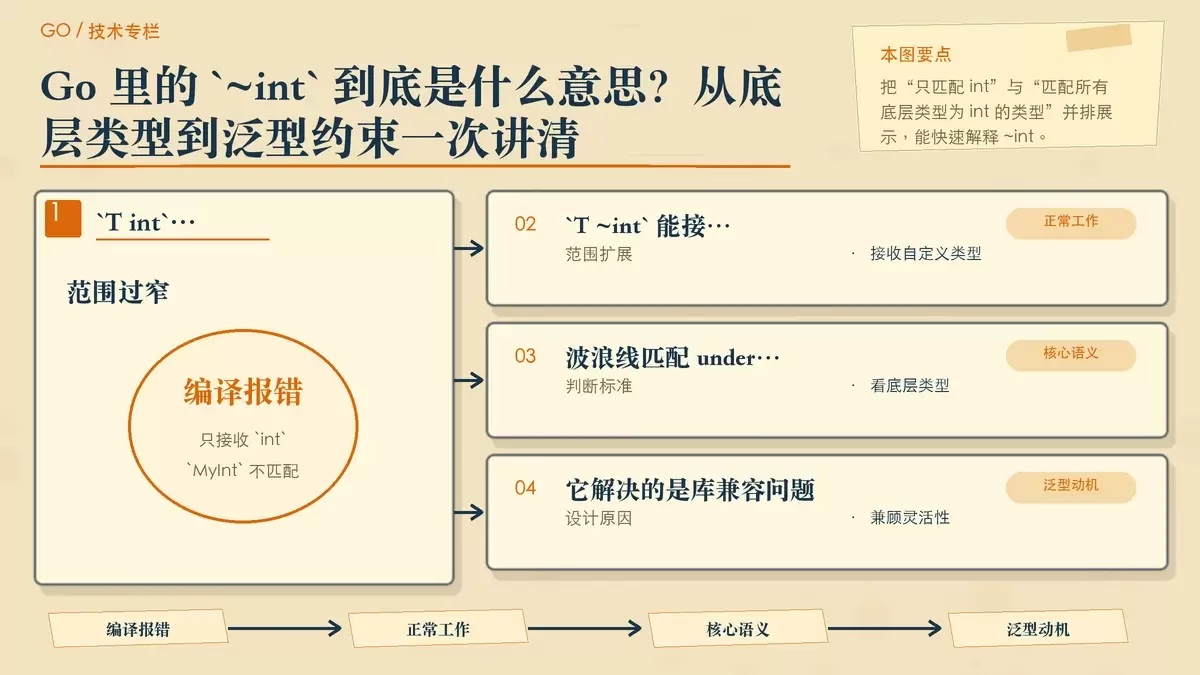
先看一个最常见的误区:约束写成 int 时,接受的只有 int 本身,而不是所有“看起来像 int 的类型”。
在 Go 1.18 之前,如果你定义了一个自定义整数类型,比如 type MyInt int,那么即便它的底层类型是 int,在类型系统里它依然是一个独立类型。这个规则在泛型里同样成立。
func PrintInt[T int](v T) {
    fmt.Println(v)
}

func main() {
  type MyInt int
  var x MyInt = 10
  // 传统泛型约束无法处理MyInt
  PrintInt(x) // 编译错误
}
问题就在这里:如果你的泛型函数本来想处理“所有以 int 为基础的整数类型”,只写 T int 就不够了,因为它把 MyInt 这样的自定义类型挡在了外面。
~int 的作用,就是把约束从“只有 int”扩展成“所有底层类型为 int 的类型”。
func PrintInt[T ~int](v T) {
    fmt.Println(v)
}
func main() {
    type MyInt int
    var x MyInt = 10
    // 使用~int约束可以处理MyInt
    PrintInt(x) // 正常工作,输出10
}所以,~T 的准确含义不是“差不多是 T”,而是“底层类型严格等于 T 的那一组类型”。这也是它在 Go 文档和讨论里常被称为“近似类型”约束的原因。
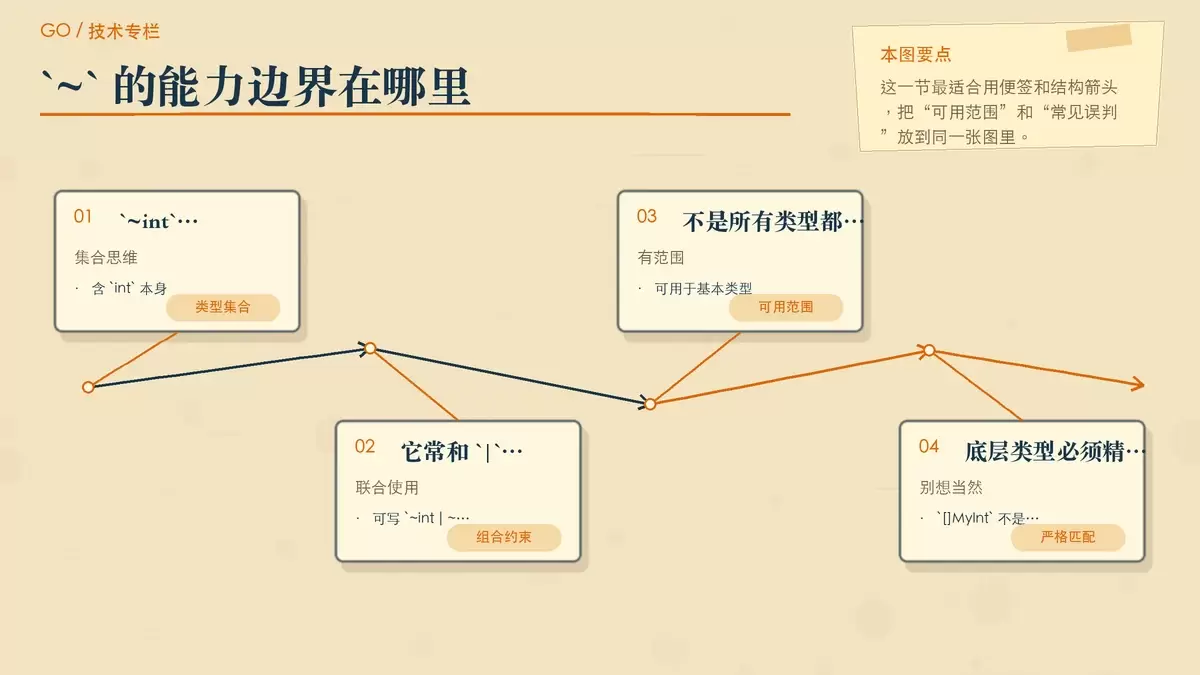
它本质上是在定义类型集合
理解 ~int,最有效的方式不是把它当语法糖,而是把它看成一个类型集合。
在 Go 泛型中,~int 表示的集合至少包括这些成员:
int本身- 所有底层类型为
int的自定义类型,例如type MyInt int - 继续基于这些类型定义、且最终底层类型仍然是
int的类型
这也是为什么它能在不牺牲类型安全的前提下,提高泛型的可用性。编译器并没有“忽略类型”,而是提前知道:只要某个类型的底层类型是 int,它就属于这个集合。
换句话说,T int 和 T ~int 的区别,不是前者严格、后者宽松这么简单,而是它们指向了两个不同的类型范围:
int:只匹配单一具体类型~int:匹配一个以int为底层类型的类型集合
这很符合 Go 的一贯思路:语法不多,但每个约束都要能在工程里解决真实问题。没有 ~,泛型在很多库设计场景下都会显得过于僵硬。
实际开发里会用在什么地方
支持自定义数值类型
这是最直接的使用场景。你的库可能并不想要求调用方必须使用标准库里的原生类型,而是允许他们定义业务语义更清晰的类型,比如 type UserID int、type Score int。这时如果约束写成 ~int,泛型函数就还能正常接收这些类型。
对于库作者来说,这个设计很关键,因为它决定了 API 是“只能处理裸类型”,还是“可以兼容带业务语义的封装类型”。
和其他约束组合使用
~ 也常出现在联合约束里,用来描述一组可接受的底层类型:
type Numeric interface {
    ~int | ~float64
}
这个约束表示:只要某个类型的底层类型是 int 或 float64,它就符合 Numeric。因此,除了原生的 int、float64,像 type Price float64、type Count int 这样的类型也都可以纳入约束范围。
这比直接使用 any 或 interface{} 更精确,因为你描述的是一组明确的可计算类型,而不是把检查留到运行时。
保持编译期类型安全
很多人看到 ~int 会误以为它类似“放宽限制”,但它和 any 的方向其实完全不同。any 是尽量接收更多类型,后续往往要靠类型断言或分支判断处理;~int 则是在编译期把可接受范围说清楚。
这意味着编译器仍然会替你做类型检查,只有满足约束的类型才能传入。灵活性增加了,但安全边界并没有后退到运行时。
边界和容易误解的地方
~ 很有用,但它并不是“泛型通配符”。真正容易出错的地方,恰恰在于开发者把它理解得过宽。
~ 不是所有类型上都能用
它只能用于基本类型或复合类型,例如 ~int、~string、~[]byte、~map[string]any、~func()、~struct{}。
但它不能用于接口类型或未定义底层类型的类型,因此像 ~interface{} 这样的写法是无效的。
匹配的是“确切底层类型”
另一个常见误解,是把 ~[]int 理解成“元素只要和 int 沾边就行”。实际上不是这样。~ 匹配的是整个类型的确切底层类型,而不是对内部元素继续递归放宽。
例如:
type MyInt int满足~int- 但
type MyIntSlice []MyInt不满足~[]int
原因是 MyIntSlice 的底层类型是 []MyInt,而不是 []int。对 ~[]int 来说,要求的是“底层类型严格等于 []int”。只要差了一层,约束就不成立。
这也是 Go 泛型和一些开发者熟悉的其他语言泛型差异很大的地方。它不会因为元素类型“向上兼容”就自动把整个容器也视作兼容类型。
真正需要建立的思维模型
如果要正确使用 ~,至少要同时理解三件事:
- 什么是底层类型(underlying type)
- 约束在泛型里其实表示类型集合(type set)
- 编译器做的是编译时匹配,而不是运行时推断
只要这三个点没混淆,大部分关于 ~int 的疑问都会自然消失。
怎么判断该不该用 ~int
如果你的目标就是限定“只能是 int 本身”,那直接写 int 即可;如果你希望泛型 API 同时支持 type MyInt int 这类自定义类型,那就应该考虑 ~int。
它解决的不是语法炫技问题,而是 Go 泛型在真实项目里是否足够实用的问题。没有 ~T,很多带业务语义的自定义类型都无法自然接入泛型函数;有了它,Go 才能在保持静态类型检查的同时,给库设计留下足够空间。
不过它的边界也很清楚:~ 匹配的是确切的底层类型,不会像某些语言中的泛型通配那样层层传递。理解这一点,才能既用好 ~int,也避免把它想象成一个“什么都能接”的万能开关。









