


在 Go 开发里,很多“该用什么数据结构”的问题,最后都落到操作模式上:你到底是更常随机访问,还是更常在中间插入、删除或移动元素。`container/list` 看起来很灵活,但它并不是切片的通用替代品,真正适合它的场景其实并不算多。
这篇文章把 `container/list` 和切片放在同一张问题清单里比较:先看两者在内存组织和复杂度上的根本差异,再对应到 LRU、双端队列、动态集合维护等常见场景。读完之后,你可以根据访问方式、修改位置和类型安全要求,判断该默认用切片,还是该明确切到链表。
链表和切片,差别先看“怎么存”
切片本质上是基于数组的动态序列,元素在内存中是连续存储的。这个特性带来两个直接结果:一是通过下标随机访问元素很快,时间复杂度通常是 O(1);二是如果你要在中间插入或删除元素,就得把后面的数据整体挪动,时间复杂度会变成 O(n)。
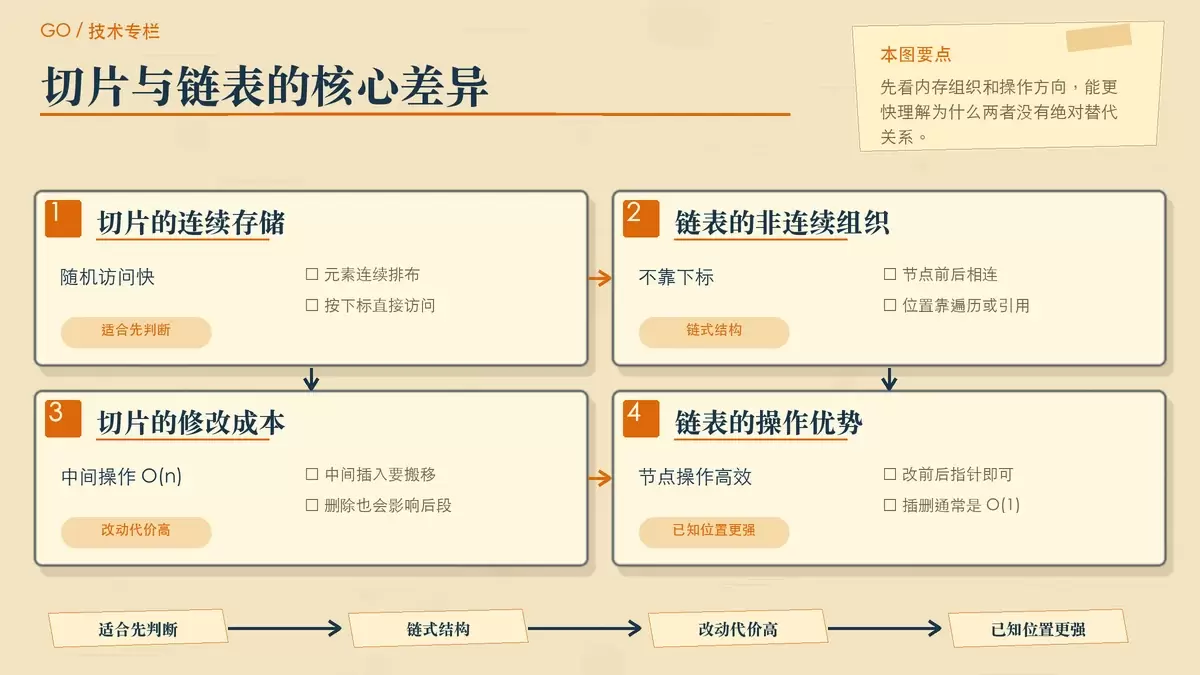
`container/list` 提供的是双向链表。链表节点在内存中不是连续排布的,而是靠前后指针串起来。它的优势是,一旦你已经拿到了某个节点的位置,插入、删除或移动节点都只需要修改相邻指针,复杂度可以做到 O(1);代价则是不能像切片那样按索引直接取值,随机访问往往只能从头或尾遍历过去,复杂度是 O(n)。
因此,两者的选择关键不在“谁更高级”,而在“你最常做什么操作”。如果你的代码以读取、遍历、按下标访问为主,切片通常更自然;如果你的代码经常围绕某个已定位节点做插入、删除、移动,链表才有发挥空间。
`container/list` 怎么用,先看最基本的操作
Go 标准库里的 `container/list` 已经把双向链表的常用能力封装好了,包括头尾插入、在指定节点前后插入,以及前后遍历。基本写法如下:
package main

import (
    "container/list"
    "fmt"
)

func main() {
    // 创建链表
    l := list.New()

    // 添加元素
    l.PushBack(1)       // 尾部添加
    l.PushFront(2)      // 头部添加

    // 在指定元素后插入
    element := l.PushBack(3)
    l.InsertAfter(4, element)

    // 遍历
    for e := l.Front(); e != nil; e = e.Next() {
        fmt.Println(e.Value)
    }
}
这里有一个很实际的使用前提:链表的高效操作往往建立在“你已经持有某个 `*list.Element`”之上。也就是说,链表的 O(1) 插入和删除,不是无条件成立,而是针对已知节点位置的情况。如果你还得先遍历一遍找到那个位置,那么查找本身仍然要付出 O(n) 的代价。
另外,`list.Element` 的值保存在 `Value` 字段里,类型是 `any`。这给了它很强的通用性,但同时也意味着你不像使用具体类型切片那样,能直接获得编译期的类型检查。
什么时候该用链表,而不是切片
频繁在中间插入、删除,且位置已经拿得到
这是链表最典型、也最容易说清楚的优势场景。如果你的程序需要反复在集合中间修改元素,而且这些修改是围绕已知节点进行的,那么链表通常比切片更合适。
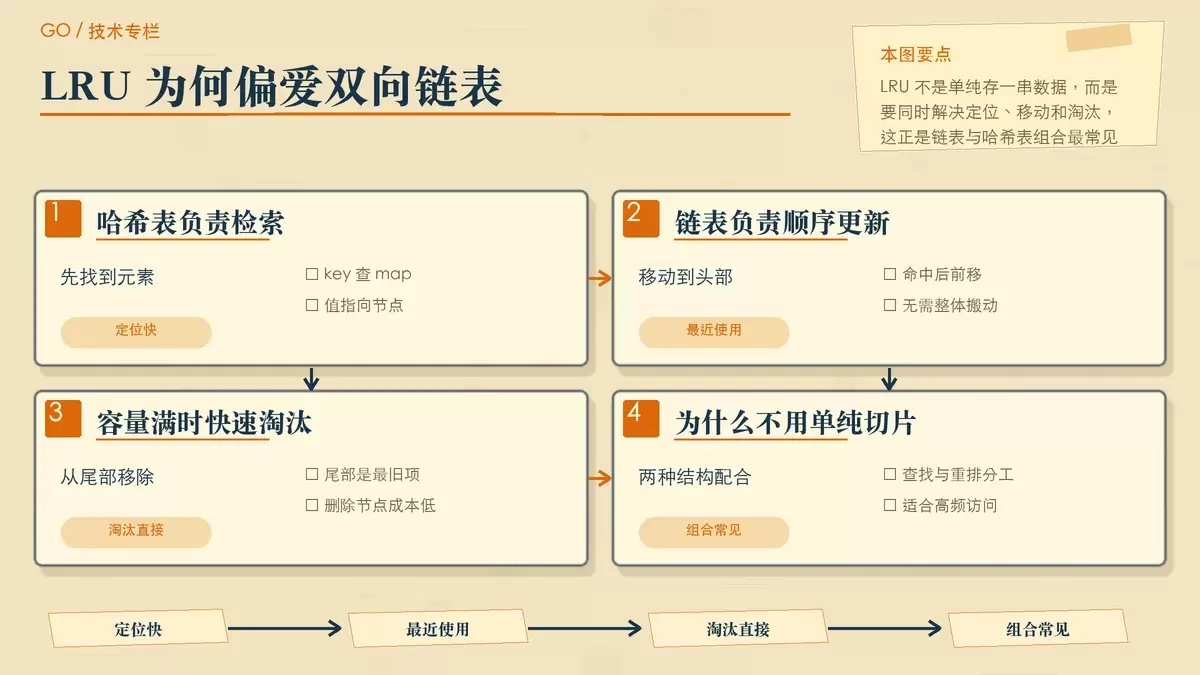
对链表来说,插入或删除节点只需要改前后指针,时间复杂度是 O(1)。对切片来说,中间位置一旦发生变化,后面的元素都要顺次移动,时间复杂度就是 O(n)。
这类情况常见于任务调度系统、实时数据流处理,或者某些维护“活动列表”的逻辑。前提仍然是:你不是每次都靠遍历去定位元素,否则链表的理论优势会被查找成本抵消掉。
实现 LRU 缓存这类“频繁移动节点”的结构
LRU(最近最少使用)缓存是 `container/list` 最经典的落点之一。原因不只是“要按顺序存数据”,而是它需要同时满足两件事:快速定位某个缓存项,以及在访问后把它迅速移动到队头,容量满时还能快速淘汰队尾。
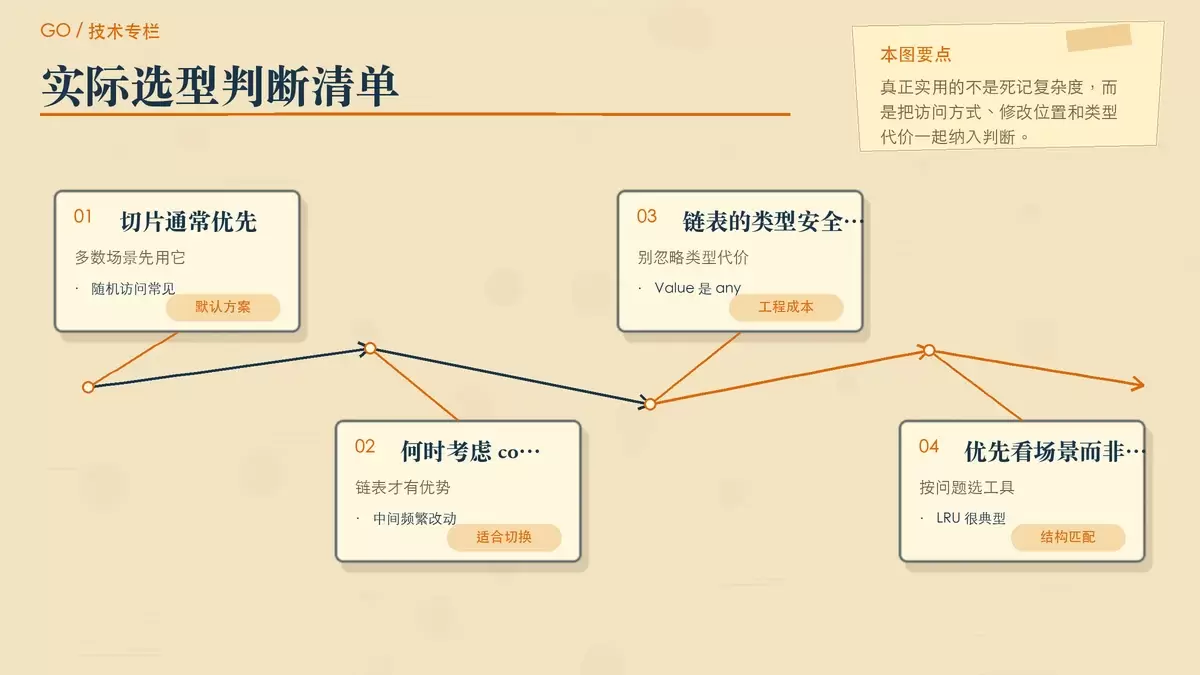
典型做法就是哈希表加双向链表:哈希表负责 O(1) 找到元素,链表负责 O(1) 移动和删除节点。
type LRUCache struct {
    capacity int
    cache    map[string]*list.Element
    list     *list.List
}

func (c *LRUCache) Get(key string) any {
    if elem, ok := c.cache[key]; ok {
        c.list.MoveToFront(elem)  // 移动到头部表示最近使用
        return elem.Value
    }
    return nil
}
在这种场景里,如果单用切片,你虽然也能维护顺序,但“命中后前移”和“尾部淘汰”会伴随频繁的数据移动,整体实现会更笨重。链表配合 `map[string]*list.Element`,更符合 LRU 的访问模型。
要做双端队列、栈,或者需要双向遍历
链表在头尾两端都能高效插入和删除,因此实现双端队列会比较顺手;如果只从一端进出,也可以拿来做栈。相比之下,切片做栈通常很自然,但如果你经常在头部操作,代价就会高不少。
// 双端队列实现
type Deque struct {
    l *list.List
}

func (d *Deque) AddFront(item int) {
    d.l.PushFront(item)
}

func (d *Deque) AddBack(item int) {
    d.l.PushBack(item)
}
另一个链表独有的便利是双向遍历。你既可以从头往后走,也可以从尾往前走:
// 反向遍历
for e := l.Back(); e != nil; e = e.Prev() {
    fmt.Println(e.Value)
}
如果你的算法天然需要前后回看,或者要维护一个可逆向扫描的序列,双向链表会比切片更贴近问题本身。
数据规模变化很剧烈时,可以把链表纳入备选
当集合大小频繁变化,而且插入删除分布比较分散时,链表确实可以避免切片在某些阶段触发扩容或大块搬移的成本。原文里提到,这类场景下链表的动态内存分配有时会表现更好,这个判断在特定工作负载下成立。
不过在工程里,这一点通常不能单独作为选型理由。因为链表节点本身也有额外指针开销,而且不连续内存对缓存局部性并不友好。更稳妥的做法是:只有当“频繁重排或中间修改”已经成立时,再把这条优势作为补充判断,而不是把“数据变化大”直接等同于“应该用链表”。
更多时候,切片仍然应该是默认选择
在 Go 项目里,切片依然是大多数线性数据场景的首选。原因并不复杂:它足够直接,访问快,类型清晰,而且和语言本身的用法高度一致。
- 需要频繁随机访问:通过索引访问元素,时间复杂度是 O(1)
- 大部分操作集中在尾部:尾部追加和删除通常都很高效
- 希望利用内存连续性:连续存储对 CPU 缓存更友好,遍历性能通常更好
- 类型安全很重要:切片的元素类型明确,编译期就能发现不少问题
尤其要注意,`container/list` 的元素值是 `any`。这意味着你在读取时往往需要做类型断言,既增加了运行时成本,也提高了误用风险。对于不少业务代码来说,这个代价往往比“理论上的 O(1) 插入删除”更真实。
复杂度对比与实际选型建议
如果只看经典复杂度,两者的差异可以概括为下面这张表:
| 操作 | 链表时间复杂度 | 切片时间复杂度 |
|---|---|---|
| 头部插入/删除 | O(1) | O(n) |
| 尾部插入/删除 | O(1) | O(1) |
| 中间插入/删除 | O(1) | O(n) |
| 随机访问 | O(n) | O(1) |
但实际写代码时,不能只背复杂度表,还要把“定位成本”和“工程代价”一起算进去。链表擅长的是已定位节点后的修改,不是任意情况下都更快;切片看起来在中间操作上吃亏,但它在遍历、索引访问、类型安全和缓存友好性上往往更占优势。
因此可以把经验法则总结成几条:
- 默认先用切片:多数业务场景里,切片更简单,也更符合 Go 的日常使用习惯。
- 看清操作模式:如果你的热点操作真的是中间插入、删除、移动,而且已经能直接拿到对应节点,再考虑 `container/list`。
- 遇到 LRU、双端队列这类典型结构时再上链表:这类问题和链表的能力天然匹配,收益最明确。
- 别忽略类型与内存成本:`interface{}`/`any` 带来的断言、节点额外指针空间,以及较差的缓存局部性,都应该纳入评估。
一句话收束:如果你需要的是按索引读写、顺序遍历和尾部追加,继续用切片;如果你需要的是围绕节点做高频重排,或者在实现 LRU 这类结构时需要 O(1) 的移动与淘汰,`container/list` 才是更合适的工具。









