

Python实现手写数字识别:基于K近邻算法的距离计算与实战

本文详解使用Python实现手写数字识别的过程,核心采用K近邻(KNN)算法。通过提取图像特征向量并计算欧氏距离,找出最相似的训练样本。文章包含完整的代码逻辑解析、距离计算公式及实际测试结果,展示如何从简单数据库出发优化识别准确率,并探讨加权排名提升精度的思路。
写在前面
图像识别部分涉及相对复杂的算法,相比之前的内容难度有所提升,因此我会尽量把原理讲透彻。
在编写过程中,我对前文的逻辑进行了优化和完善,因此本教程的内容以最新代码为准。如需直接查看完整代码,可访问我的GitHub仓库,本文主要侧重于算法原理与实现逻辑的讲解。
本次大纲
上一篇文章完成了数据库的构建,实现了将新训练图片实时存入CSV文件的功能。接下来,我们将进入核心环节:识别图片内容。
首先,我们需要从指定文件夹中提取待识别的图片(如test.png),并对其进行与训练图片相同的预处理,将其转换为1x10000维度的向量。由于待识别图片与训练图片存在细微差异,为了避免在原有源代码中增加过多逻辑复杂度,我单独编写了一个名为GetTestPicture的函数来获取待识别图片向量。该函数与获取训练图片的GetTrainPicture函数类似,但省略了“添加图片名称”这一步骤。
完成向量提取后,即可开始正式的图像识别流程。
核心逻辑是计算待识别图片与所有训练图片之间的距离。距离越近,说明两张图片越相似,它们代表相同数字的可能性就越大。基于此原理,我们找出距离待识别图像最近的几个训练样本,并输出它们对应的数字。例如,若前三个最近邻的数字分别为3、3、9,则判定该待识别图片最有可能是数字3。
此外,还可以为每个最近邻的位置设置权重,具体的加权算法将在后续章节详细讲解,本节内容至此已足够丰富。
(在第一篇文章中,我曾提及利用图片“洞数”进行检测的方法。经过尝试,我认为该方法存在不妥之处,具体原因将在本文末尾补充说明。)
MAIN代码
以下是主要代码的实现,整体逻辑清晰易懂。
import os
import OperatePicture as OP
import OperateDatabase as OD
import PictureAlgorithm as PA
import csv

##Essential vavriable 基础变量
#Standard size 标准大小
N = 100
#Gray threshold 灰度阈值
color = 200/255

n = 10

#读取原CSV文件
reader = list(csv.reader(open('Database.csv', encoding = 'utf-8')))
#清除读取后的第一个空行
del reader[0]
#读取num目录下的所有文件名
fileNames = os.listdir(r"./num/")
#对比fileNames与reader,得到新增的图片newFileNames
newFileNames = OD.NewFiles(fileNames, reader)
print('New pictures are: ', newFileNames)
#得到newFilesNames对应的矩阵
pic = OP.GetTrainPicture(newFileNames)
#将新增图片矩阵存入CSV中
OD.SaveToCSV(pic, newFileNames)
#将原数据库矩阵与新数据库矩阵合并
pic = OD.Combination(reader, pic)

#得到待识别图片
testFiles = os.listdir(r"./test/")
testPic = OP.GetTestPicture(testFiles)

#计算每一个待识别图片的可能分类
result = PA.CalculateResult(testPic, pic)
for item in result:
 for i in range(n):
  print('第'+str(i+1)+'个向量为'+str(item[i+n])+',距离为'+str(item[i]))
与上一篇文章相比,本文主要增加了以下代码段:获取待识别图片名称、生成待识别图片向量以及执行分类计算。
接下来,我们将重点解析CalculateResult函数的具体实现,即图像识别的核心算法。
算法内容
算法大致讲解
我们在大纲中已简要介绍过该原理,此处直接引用并补充更多细节。
假设在二维平面上有两个点A=(1,1)和B=(5,5),现在引入第三个点C=(2,2)。请问,C点距离哪一个点更近?
具备初中数学知识的人都知道,C点显然离A点更近。我们可以换一种表述:现有两个类别,A类包含点(1,1),B类包含点(5,5)。对于点(2,2),它更可能属于哪一类?
由于该点距离A类中的点更近,因此它很可能属于A类。这就是基本结论。同理,在三维空间中,若A类为点(1,1,1),B类为点(5,5,5),则点(2,2,2)同样属于A类。
由此可见,我们是以两点间的距离作为判断类别的标准。对于我们将图片拉伸成的1xn维向量,它在n维空间中投影为一个点。我们将训练向量分为10类,分别代表0到9这十个数字。被识别的数字若靠近某一类,则说明它属于该类。
具体而言,对于被识别向量,我们列出距离它最近的前十个向量及其所属类别,根据排名赋予权重并计算出一个综合值。该值代表了最可能的分类结果,即最终识别出的手写数字。
以上是第一篇文章中的基础内容,下面我将重点补充数学层面的细节。
考虑到部分平台输入数学公式不便,我将相关数学推导以图片形式展示。
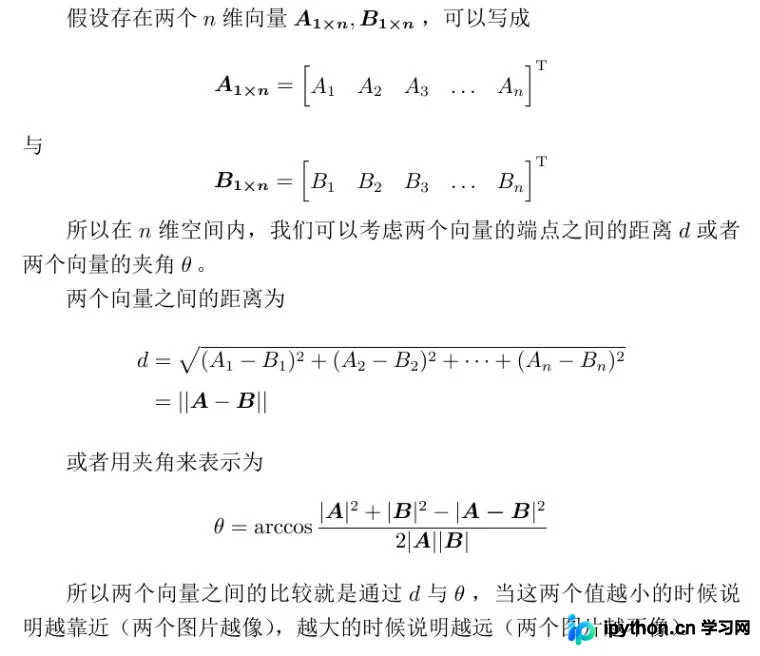
随后,我们直接提取距离被识别图片最近的几个向量对应的数字,这些数字即为识别结果。虽然这种方法较为直观,但略显简单,因此下一篇文章我将深入探讨加权机制,本节先聚焦于距离计算。
主代码
在下面的代码中,test文件夹用于存放待识别图片。通过GetTestPicture函数获取图片向量后,将其与训练图片pic一起传入CalculateResult函数,计算每个待识别向量与其他所有图片向量的距离。
#得到待识别图片
testFiles = os.listdir(r"./test/")
testPic = OP.GetTestPicture(testFiles)

#计算每一个待识别图片的可能分类
result = PA.CalculateResult(testPic, pic)
for item in result:
 for i in range(n):
  print('第'+str(i+1)+'个向量为'+str(item[i+n])+',距离为'+str(item[i]))
CalculateResult函数位于PictureAlgorithm.py文件中,该文件包含CalculateDistance和CalculateResult两个函数,分别代表图像识别所依赖的算法逻辑。
函数CalculateResult
该函数的逻辑相对简单,主要调用计算距离的CalculateDistance函数。
def CalculateResult(test, train):
 '''计算待识别图片test的可能分类'''
 #得到每个图片的前n相似图片
 testDis = CalculateDistance(test[:,0:N**2], train[:,0:N**2], train[:,N**2], n)
 #将testDis变成列表
 tt = testDis.tolist()
 #输出每一个待识别图片的所有前n个
 for i in tt:
  for j in i:
   print(j)
函数CalculateDistance
该函数接收四个参数:待识别向量test、训练向量train、与训练向量对应的数字标签num,以及希望输出的最近邻数量n。
def CalculateDistance(test, train, num, n):
 '''计算每个图片前n相似图片'''
 #前n个放距离,后n个放数字
 dis = np.zeros(2*n*len(test)).reshape(len(test), 2*n)
 for i, item in enumerate(test):
  #计算出每个训练图片与该待识别图片的距离
  itemDis = np.sqrt(np.sum((item-train)**2, axis=1))
  #对距离进行排序,找出前n个
  sortDis = np.sort(itemDis)
  dis[i, 0:n] = sortDis[0:n]
  for j in range(n):
   #找到前几个在原矩阵中的位置
   maxPoint = list(itemDis).index(sortDis[j])
   #找到num对应位置的数字,存入dis中
   dis[i, j+n] = num[maxPoint]
 return dis
首先,构建一个矩阵,行数为待识别向量的数量,列数为2*n。矩阵的前n列用于存储距离,后n列用于存储对应的数字标签。接着,对每个待识别向量进行循环处理。
首先直接计算每个训练图片与该待识别图片的距离,这可以通过一行代码实现。
itemDis = np.sqrt(np.sum((item-train)**2, axis=1))
这行代码对应上述算法过程,虽然看似复杂,但可拆解理解。此处不再展开细讲,后续内容将演示如何排序并找出距离最近的前几个向量。
具体逻辑为:先对距离进行排序,找出最小的前n个值并存入矩阵。然后找到这前n个值在原矩阵中的索引位置,并获取对应位置上num的数字,存入dis的后n列。
至此,所有数据处理完成,返回dis矩阵即可。
实际测试
我亲手书写了一些数字,如图所示。目前数据库规模较小。
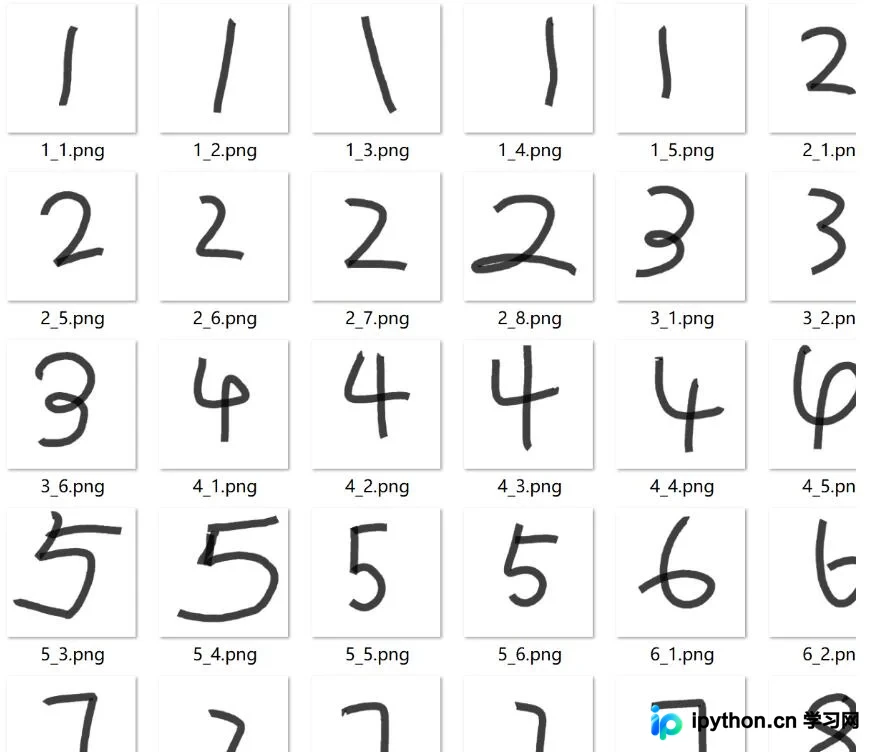
随后,我书写了一个新的数字作为待识别图像,程序运行后直接输出了前十个最相似的向量及其距离:
第1个向量为2.0,距离为33.62347223932534 第2个向量为2.0,距离为35.64182105224185 第3个向量为2.0,距离为38.69663119274146 第4个向量为2.0,距离为43.52904133387693 第5个向量为2.0,距离为43.69029199677604 第6个向量为1.0,距离为43.730883339256714 第7个向量为6.0,距离为44.94800943845918 第8个向量为2.0,距离为45.033283944455924 第9个向量为4.0,距离为45.43926712996951 第10个向量为7.0,距离为45.64893989116544
随后,我又依次测试了从1到9的数字,我自己手写的数字全部被正确识别,可以看出准确率相当高。至此,项目已完成度较高。
接着,我尝试使用网上下载的图片进行测试,结果几乎无一正确。这说明当前数据库规模过小,模型仅能识别我个人的书写字体。不过,基于此原理,也可以开发专门的字体识别程序。
若要提高准确率,扩大训练图库是必经之路。本次内容到此结束。
总结
所有源代码已上传至我的GitHub,有兴趣的读者可自行查阅。
至此,算法部分讲解完毕。实现相对简单,仅使用了类似K最近邻(KNN)的算法。
下一篇文章将介绍如何给前n个排名结果添加权重,以进一步提高识别准确度。
本次分享就到这里,感谢阅读。
如果觉得有帮助,欢迎点赞和关注,谢谢!~
本文已被收录到专题《python图片处理操作》,欢迎大家点击学习更多精彩内容。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









