


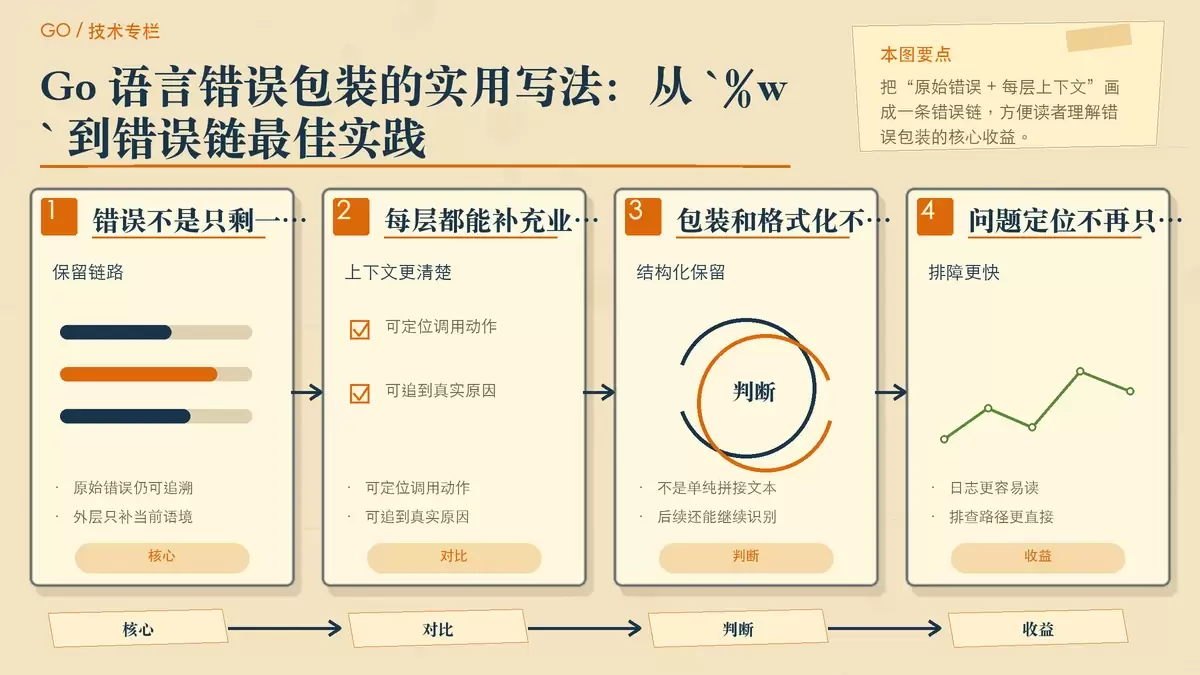
在 Go 项目里,错误处理往往不是“有没有报错”这么简单,真正麻烦的是线上只留下一句模糊提示,定位时却找不到触发路径。Go 1.13 之后的错误包装机制,核心价值就是把原始错误和业务上下文一起保留下来;看完这篇,你可以判断哪些场景该包装、该补什么上下文,以及调用方应该怎样稳定识别错误。
为什么错误包装值得用
很多服务报错时,日志里只会出现类似“数据库查询失败”“请求处理失败”这样的信息。问题在于,这类描述通常来自很多调用点:到底是哪张表、哪个查询条件、哪个业务动作、哪一层返回的错误,仅靠一句结果很难判断。
错误包装要解决的,就是保留错误链中的原始错误,同时在每一层补充新的上下文。这样一来,调用方既能看到完整的错误描述,也能继续追溯到最底层的真实原因,而不是被中间层覆盖掉。
这也是 Go 错误包装和传统字符串拼接的关键区别:它不是单纯把报错文本写得更长,而是让错误具备结构化的可追踪关系。
`%w` 怎么用,和 `%v` 差别在哪
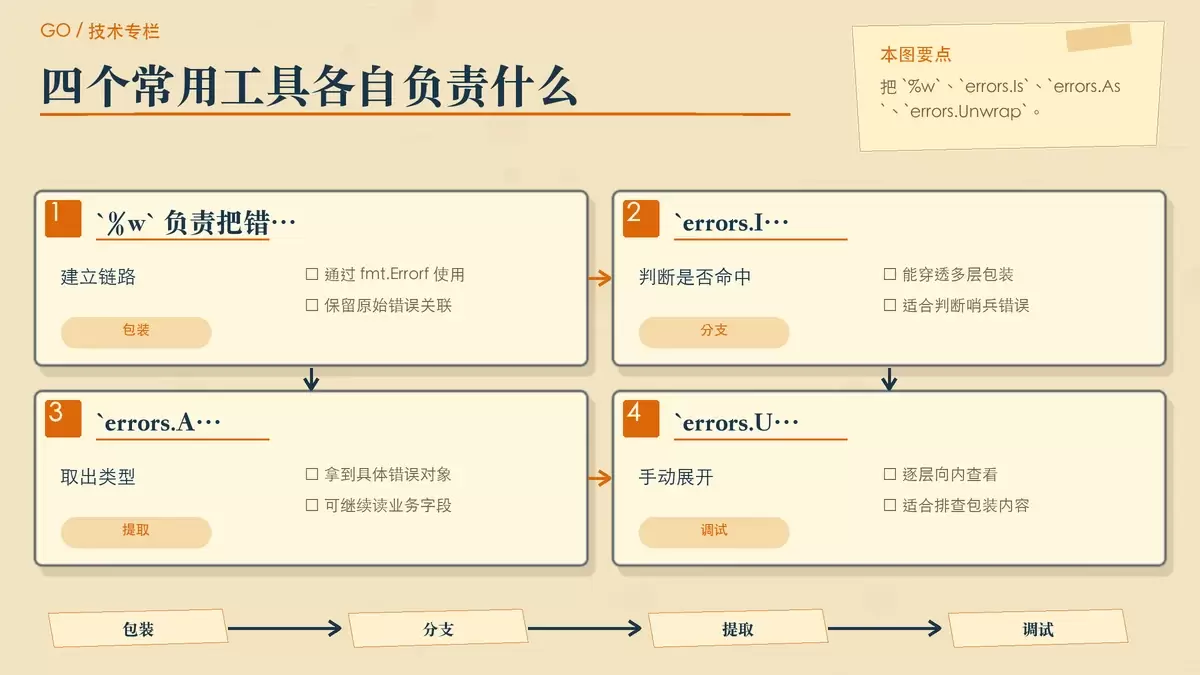
Go 通过 fmt.Errorf 配合 %w 来实现错误包装。最基础的写法如下:
func connectDB() error {
    return errors.New("连接超时")
}

func queryUser() error {
    err := connectDB()
    if err != nil {
        return fmt.Errorf("查询用户失败: %w", err)
    }
    return nil
}
当调用 queryUser() 时,最终错误信息会变成“查询用户失败: 连接超时”。表面上看,这和用 %v 拼接字符串很像,但语义完全不同。
如果这里使用的是 %w,外层错误会保留对原始错误的引用,后续还能继续用标准库 API 沿着错误链判断和提取;如果写成 %v,那就只是把原始错误格式化成一段文本,链路关系已经丢了,后面没法再精确识别。
因此可以把规则记得更直接一些:需要保留错误身份和链路时用 %w,只想展示文字时才考虑 %v。
错误链最常用的 3 个操作
errors.Is:判断链里有没有某个错误
当你关心“这是不是超时”“是不是权限不足”“是不是用户不存在”这类可预期结果时,最应该用的是 errors.Is。
var ErrTimeout = errors.New("连接超时")

func main() {
    err := queryUser()
    if errors.Is(err, ErrTimeout) {
        fmt.Println("检测到超时,正在重试...")
    }
}
errors.Is 会遍历整个错误链,而不是只比较最外层。所以即使 ErrTimeout 被包装了两层、三层,调用方仍然能识别出来。这比直接写 err == ErrTimeout 更适合真实项目,因为后者一旦经过包装,判断通常就失效了。
errors.As:提取特定错误类型
如果你不仅要知道“是不是这类错误”,还需要取出其中携带的字段信息,那么应该使用 errors.As。
type TimeoutError struct {
    Duration time.Duration
}

func main() {
    err := someOperation()
    var timeoutErr *TimeoutError
    if errors.As(err, &timeoutErr) {
        fmt.Printf("超时时长: %vn", timeoutErr.Duration)
    }
}
这类写法常见于自定义错误类型,例如网络超时、请求限流、参数校验失败等场景。调用方能先通过 errors.As 找到目标类型,再继续读取里面的业务字段。
原文还提到,在 Go1.26 中新增了 errors.AsType,用于将错误转换为指定类型。这种能力在处理自定义错误类型时也很有价值,尤其适合希望减少样板代码的场景。
errors.Unwrap:逐层查看错误链
有些时候你需要明确看到每一层包装都加了什么信息,这时可以直接手动解包:
for err != nil {
    fmt.Println(err)
    err = errors.Unwrap(err)
}
errors.Unwrap 更像一个底层工具。日常业务判断通常优先用 errors.Is 和 errors.As,因为它们更贴近“判断类型”和“提取对象”这两个常见目标;而 errors.Unwrap 更适合调试、排查,或你确实需要自定义遍历逻辑的时候使用。
几条更适合项目落地的实践
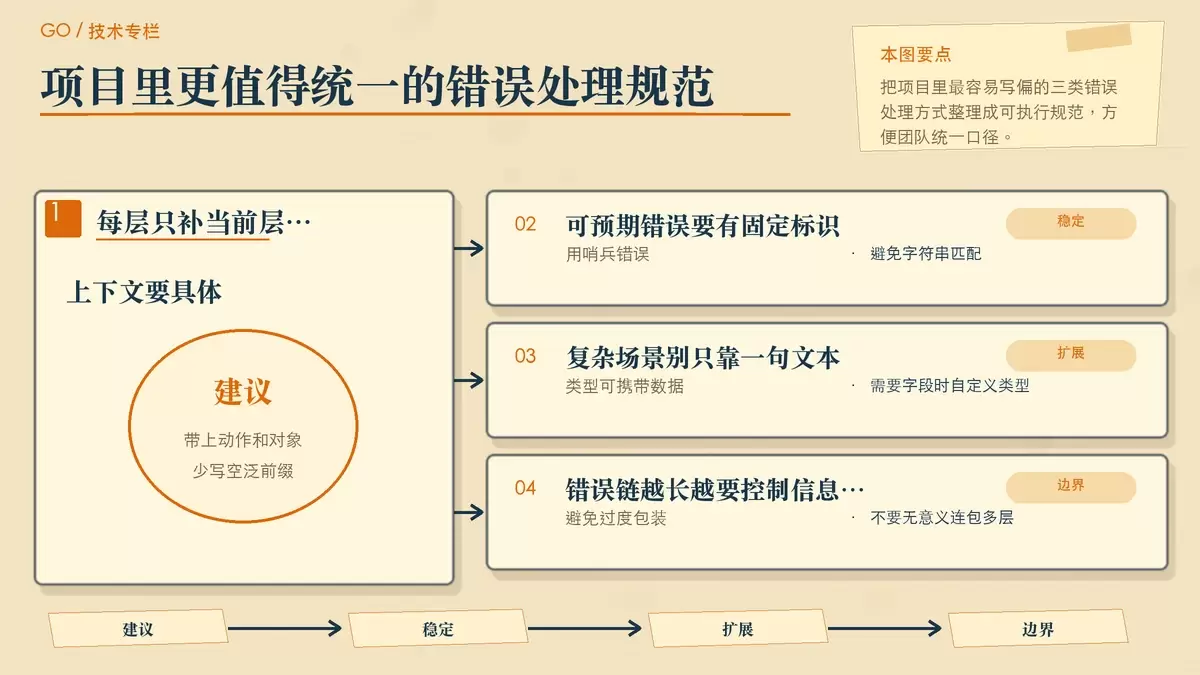
每一层都补有价值的上下文
错误包装最容易写坏的地方,就是把所有层都写成“操作失败”“发生错误”“请求异常”。这类前缀虽然看起来做了包装,但对排查没有帮助。
更有效的做法,是把当前层真正知道的信息补进去,例如资源 ID、业务动作、关键参数、调用目标,而不是重复一个空泛名词。
// 不好的做法
return fmt.Errorf("错误: %w", err)

// 好的做法
return fmt.Errorf("获取用户 %d 的订单列表失败: %w", userID, err)
这里的差别很直接。前者只说明“出错了”,后者则告诉你:出错的是“获取订单列表”这个动作,目标对象是哪个用户。线上日志越复杂,这种上下文价值越高。
用哨兵错误表示可预期分支
对于调用方需要稳定处理的错误,建议定义成哨兵错误,而不是依赖字符串匹配。这样可以把“展示给人看的描述”和“程序逻辑里的判断依据”分开。
var (
    ErrUserNotFound = errors.New("用户不存在")
    ErrPermission   = errors.New("权限不足")
)

func (s *Service) DeleteUser(id int) error {
    user, err := s.repo.Find(id)
    if err != nil {
        return fmt.Errorf("删除用户: %w", err)
    }
    if !s.hasPermission(user) {
        return fmt.Errorf("删除用户 %d: %w", id, ErrPermission)
    }
    return nil
}
调用方再通过 errors.Is 进行分支处理:
err := service.DeleteUser(123)
switch {
case errors.Is(err, ErrUserNotFound):
    // 处理用户不存在
case errors.Is(err, ErrPermission):
    // 处理权限不足
}
这种模式的好处在于,服务内部仍然可以不断补充上下文,但外部判断逻辑不会因为文案调整而失效。对于接口层、任务调度、重试机制、状态码映射来说,这一点很重要。
需要更多字段时,自定义错误类型并实现 Unwrap
如果一个错误除了“是什么”之外,还需要携带额外信息,例如 SQL 语句、请求目标、超时时长、响应码,那么仅靠哨兵错误往往不够。这时更适合自定义错误类型,并实现 Unwrap,让它继续接入标准错误链。
type QueryError struct {
    Query string
    Err   error
}

func (e *QueryError) Error() string {
    return fmt.Sprintf("查询错误: %s, 原因: %v", e.Query, e.Err)
}

func (e *QueryError) Unwrap() error {
    return e.Err
}
这样做有两个收益。第一,日志信息更完整,能直接看到关键字段;第二,外层代码仍然可以继续用 errors.Is 或 errors.As 处理里面包着的原始错误,不会因为换成自定义类型就断链。
写错误链时,重点不是“包几层”,而是“保留什么信息”
Go 的错误包装机制,本质上是把错误处理从简单的字符串传递,升级成结构化的错误链管理。真正值得掌握的核心就三件事:用 %w 保留原始错误,用 errors.Is 判断可预期错误,用 errors.As 提取特定类型。
落到团队实践里,可以把规则定得明确一些:每层只补当前层独有的上下文;对外需要稳定判断的情况用哨兵错误;需要更多字段时用自定义错误类型并实现 Unwrap;避免为了“显得完整”而做没有信息增量的重复包装。
这样写出来的错误,不只是更容易读,也更适合调试、重试、监控和接口分支处理。出了问题时,开发者看到的不会只是一句模糊报错,而是一条能顺着走回源头的错误链。









