


线上线程一旦卡死,gdb 往往只能告诉你“现在哪个调用栈没动了”,却解释不了多个线程是怎样逐步形成等待环的。要把死锁过程还原出来,重点不是多打几句“获取锁失败”,而是从日志设计、埋点位置到后处理分析一起补齐,让日志本身能支撑因果推断。
这类方案是否有效,可以看几个硬指标:有没有记录到线程 ID、锁地址、操作类型、时间戳和全局序号;日志写入会不会反过来引入锁竞争;condition_variable::wait() 这种隐式解锁再加锁场景有没有覆盖;以及最终是否能按序号还原出完整阻塞链。
为什么普通死锁日志几乎没用
很多项目遇到卡顿后,第一反应是打印类似“等待 mutex”或“获取锁失败”的信息。问题在于,这类日志缺少上下文,根本没法回答两个关键问题:到底是哪一个线程在等,等的是哪一把锁;这把锁在此前又被谁持有、持有线程是否还在等待别的锁。
因此,围绕 std::mutex::lock()、std::mutex::try_lock() 和 std::mutex::unlock() 的埋点必须尽量完整。至少要在前后记录这些字段:
- 线程 ID,例如
std::this_thread::get_id() - 锁对象地址,例如
&m - 操作类型
- 时间戳,建议用
std::chrono::steady_clock::now()
只有这样,后续分析时才能确认线程和锁之间的对应关系,而不是停留在“某处可能卡住了”的模糊判断。
另一个常见误区,是直接用 std::cout 或未同步的全局缓冲区输出日志。这样做的问题不只是性能差,更严重的是日志系统本身可能引入新的竞争,甚至掩盖、干扰原本的死锁现场。更稳妥的做法,是采用无锁队列,例如 moodycamel::ConcurrentQueue,或者使用静态 std::atomic_flag 保护的环形缓冲区,让日志写入不依赖任何可能被阻塞的锁。
日志字段怎么设计,才能支持因果回溯
死锁分析需要的不只是“谁在等”,而是“谁在等谁、此前发生过什么”。所以日志格式要能支撑回放和排序,不能只靠一句自然语言描述。
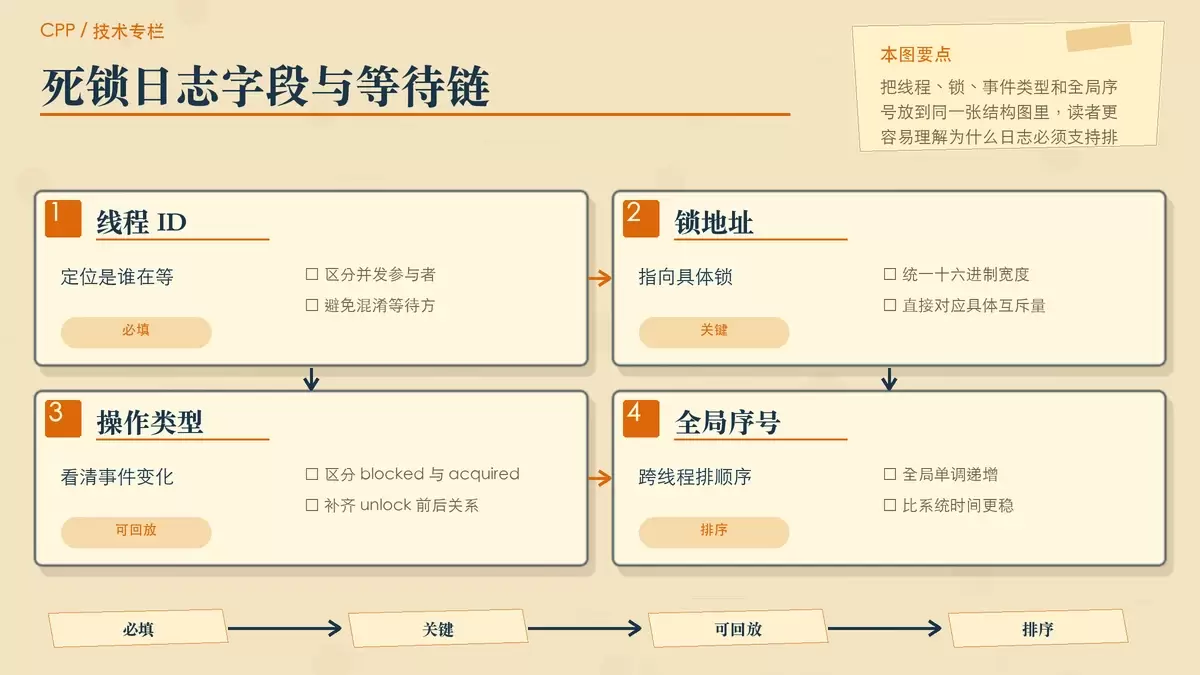
比较实用的一组字段包括:
tid:线程 ID,建议预先字符串化,避免std::thread::id直接流输出带来的额外开销op:操作类型,例如"lock_enter"、"lock_blocked"、"lock_acquired"、"unlock"mutex_addr:锁地址,建议使用统一宽度的十六进制格式,如0x00007fff12345678backtrace:可选字段,但价值很高。可在lock_blocked时抓取栈帧,例如配合backtrace()和dladdr()seq:全局单调递增序号,用于跨线程排序
其中,seq 特别关键。多线程场景下,仅靠系统时间排序并不可靠,一方面时间精度未必够,另一方面不同 CPU 核上的事件可能非常接近。全局单调递增序号能提供一条更稳定的事件顺序线索。
有了这些字段,死锁发生后就可以把所有 lock_blocked 日志筛出来,按 seq 排序,再结合 mutex_addr 和 tid 去追踪持有关系。这样往往能明确看出阻塞链,例如 A 等 B,B 等 C,C 又反过来等 A,等待环就会直接暴露出来。
埋点位置怎么选,分析链路怎么补全
C++ 标准库本身并不提供现成的死锁检测钩子,std::mutex 也不会把内部状态暴露给你。所以,指望运行时自动告诉你“这里形成了死锁”并不现实。即使在问题出现后用 gdb attach,再看 info threads 和 bt,你拿到的也只是当前卡住的截面,而不是导致死锁的过程。
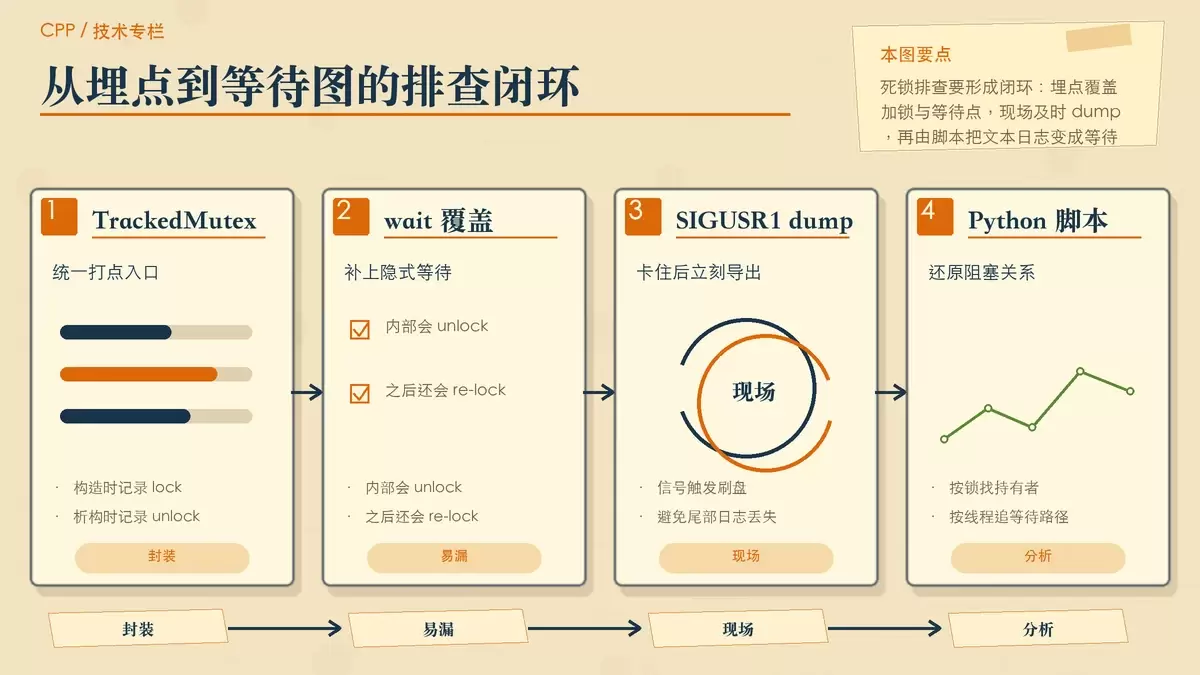
更可行的做法,是主动埋点,再借助外部分析脚本回放事件序列。落地时可以重点做这几件事。
用 RAII 包一层 TrackedMutex
可以封装一个 TrackedMutex,在加锁和解锁路径里统一写日志。这样做的好处是调用方改动相对可控,也更容易覆盖大部分互斥锁使用场景。配合 std::unique_lock<TrackedMutex>,很多已有代码可以自然迁移到可追踪版本。
别漏掉 condition_variable::wait()
std::condition_variable::wait() 是死锁排查里很容易遗漏的一环。它内部包含 unlock 和 re-lock 行为,看上去像“线程在等条件”,实际却可能成为重要的隐式等待点。如果这一层没有记录,线程切换和锁所有权变化就会出现断档,最终等待链会缺一段,分析结果不完整。
在现场触发 dump,再用脚本还原关系
如果日志先写入内存缓冲区,死锁发生后要尽快把现场刷出来,避免最后几条关键记录还没落盘。一个常见做法是收到信号后执行 dump,例如:
kill -SIGUSR1 <pid>随后再用 Python 脚本解析日志:先按 mutex_addr 分组定位锁的持有者,再按 tid 追踪各线程等待路径,最后生成等待图。这样得到的 waiting graph,通常比单看文本日志更容易发现环路和关键阻塞点。
生产环境怎么控量,避免日志把系统拖慢
死锁日志一旦设计得足够细,数据量也会迅速膨胀。尤其在高并发服务里,如果对每次锁操作都全量记录,I/O 和内存压力都不小,甚至会影响原本的运行时行为。因此,生产环境通常需要做分级采集,而不是默认全开。
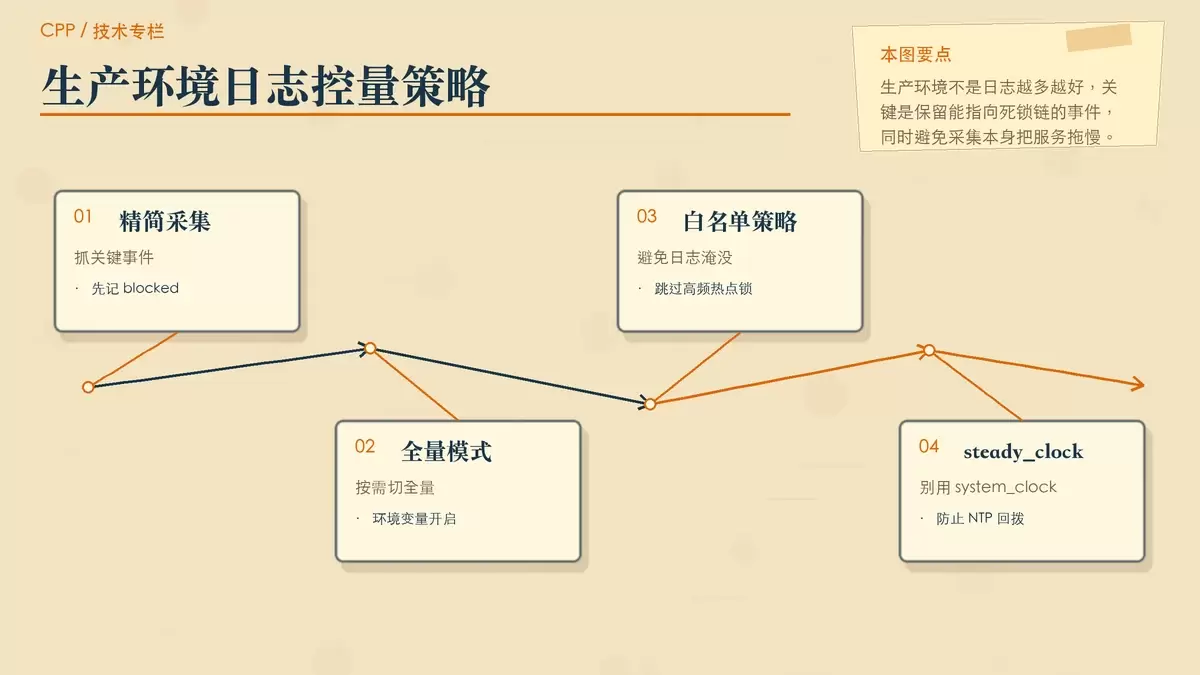
比较实际的策略包括:
- 默认只记录
lock_blocked和lock_acquired,优先覆盖最可能暴露问题的事件 - 通过环境变量开启全量模式,例如
LOG_LOCK_TRACE=1,只在复现阶段使用 - 给高频锁做白名单或过滤,避免像全局计数器锁这类热点把日志淹没
- 在日志行末附带
/* trace_id: xxx */,把锁链和具体业务请求关联起来
这里还有一个特别容易被忽视的细节:时间戳必须用 steady_clock,不要用 system_clock。原因很直接,system_clock 可能受 NTP 校时影响而跳变,时间一旦回拨,你看到的事件顺序就可能失真,进而误判“A 在 B 之后申请锁”。而 steady_clock 的目标就是提供稳定递增的时间基准,更适合做日志排序和时序分析。
一套可执行的最小落地清单
如果目标不是做通用调试平台,而是先把当前项目的死锁排查能力补起来,可以按最小闭环推进:
- 先在互斥锁封装层补齐
tid、op、mutex_addr、seq、steady_clock时间戳 - 日志写入改成无锁队列或原子保护的环形缓冲区
- 默认记录
lock_blocked、lock_acquired,保留全量模式开关 - 补上
condition_variable::wait()的封装埋点 - 准备一个收到
SIGUSR1后可立即 dump 的机制 - 用 Python 脚本根据
mutex_addr、tid、seq生成等待关系图
做到这一步,日志就不再只是“出事时留个痕迹”,而是能真正把死锁形成过程拆开来看。对排查线上偶发问题来说,这比单纯扩充运行时告警更有价值,因为它给出的不是症状,而是能复盘责任链的证据。









