


处理字符串里的分隔符,看起来像是一个很小的问题,但在 C++ 里其实有几条完全不同的路径:删单个字符、删多字符子串、或者根本不该删而是直接切分。选错方法,轻则代码啰嗦,重则在循环里跳过匹配、反复搬移内存,甚至把相邻分隔符处理错。
这篇文章把几种常见需求拆开讲清楚:C++20 可以直接用什么,旧项目该怎样封装,可变长分隔符为什么不能照搬字符删除方案,以及什么时候该改用 std::string_view。看完后,你可以根据分隔符类型、标准版本和性能要求,直接判断该选哪种写法。
C++20:删除单个分隔符字符,直接用 std::erase
如果目标很明确,就是把字符串中的某个字符全部删掉,例如所有 '-'、',' 或 '|',那么 C++20 提供的 std::erase 就是最直接的做法。
std::string s = "a-b-c,d";
std::erase(s, '-'); // s 变成 "abc,d"
std::erase(s, ','); // s 变成 "abcd"
这个接口的优点很明确:
- 原地修改
std::string,不需要自己写循环; - 语义直观,代码一眼能看懂是在“删除某个字符”;
- 相比手写下标遍历或边遍历边擦除,更不容易出错。
不过它只适用于“字符删除”。这里的参数应当是 '-' 这样的字符,而不是 "-" 这样的字符串字面量。前者删除字符,后者是子串概念,直接传给这个接口会编译失败。
因此,这一招适合的场景只有一个:分隔符本身就是单个字符,而且你确实希望把它们从原字符串里彻底移除。
多字符分隔符怎么删:用 find + erase 循环
一旦分隔符变成多个字符,例如 "::"、"||" 或换行序列,std::erase 就帮不上忙了。因为它解决的是“删除某个值相等的字符”,不是“删除一段子串”。这时要回到 std::string 自身的查找与擦除能力。
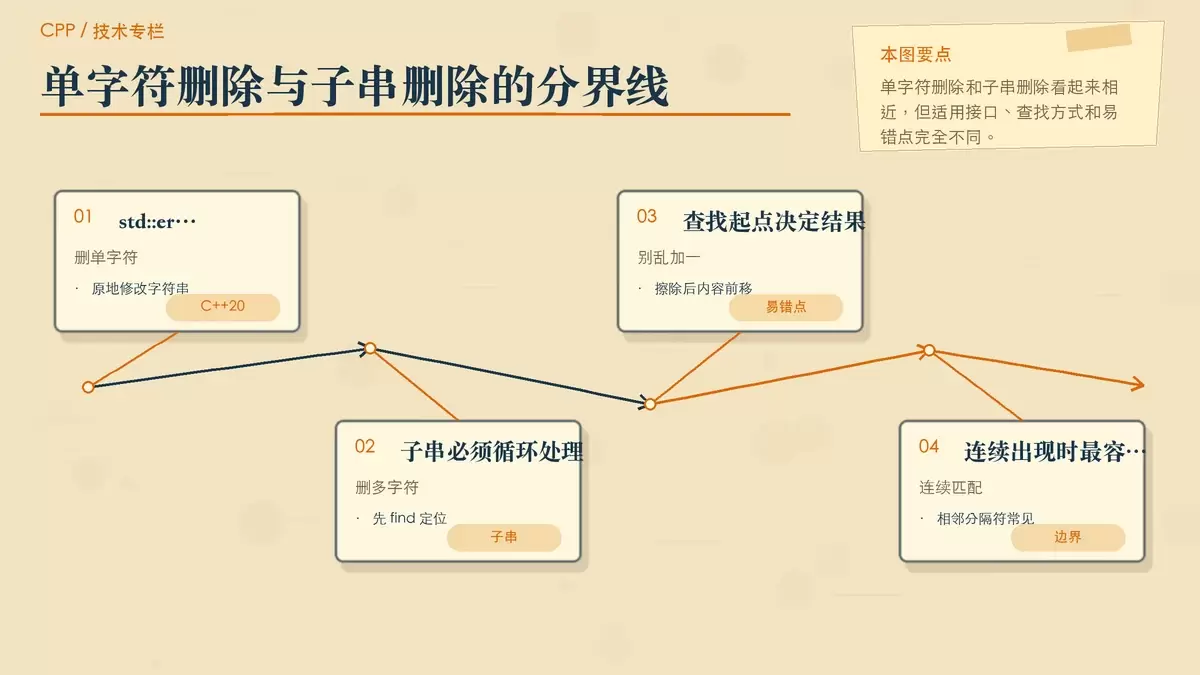
标准做法是三步:
- 用
s.find(delimiter, pos)找到分隔符出现的位置; - 找到后调用
s.erase(pos, delimiter.length())擦掉这段内容; - 继续从当前位置
pos重新查找,而不是盲目后移。
示例代码如下:
std::string s = "a|b||c";
std::string delim = "|";
size_t pos = 0;
while ((pos = s.find(delim, pos)) != std::string::npos) {
    s.erase(pos, delim.length());
    // 不加 pos++,因为擦除后新内容已落在 pos 处
}
这里最容易写错的地方,就是擦除之后下一次从哪里开始查找。很多人会习惯性地写成 pos + 1,但这在删除操作里并不总是对。因为 erase 之后,后面的内容会整体前移,新的待检查内容已经落在原来的 pos 位置上。如果这时你直接跳到后一个位置,就可能漏掉紧挨着的分隔符。
以 "a|b||c" 为例,删除第一个 "|" 后,后面的字符已经补到前面;如果再强行前进,就可能把连续的 "||" 中一个匹配跳过去。相邻分隔符处理不干净,正是这类代码里最常见的问题之一。
所以,删除子串时的核心不是 find 和 erase 这两个 API 本身,而是要理解“擦除后字符串已经变了”,查找起点也必须跟着这个事实来设计。
如果目的是切分内容,优先考虑 std::string_view
很多时候,所谓“去掉分隔符”并不是最终目标。真正的需求可能是:把一行数据按分隔符拆成几段,再分别处理。如果是这种情况,先删分隔符再取内容,往往并不划算。
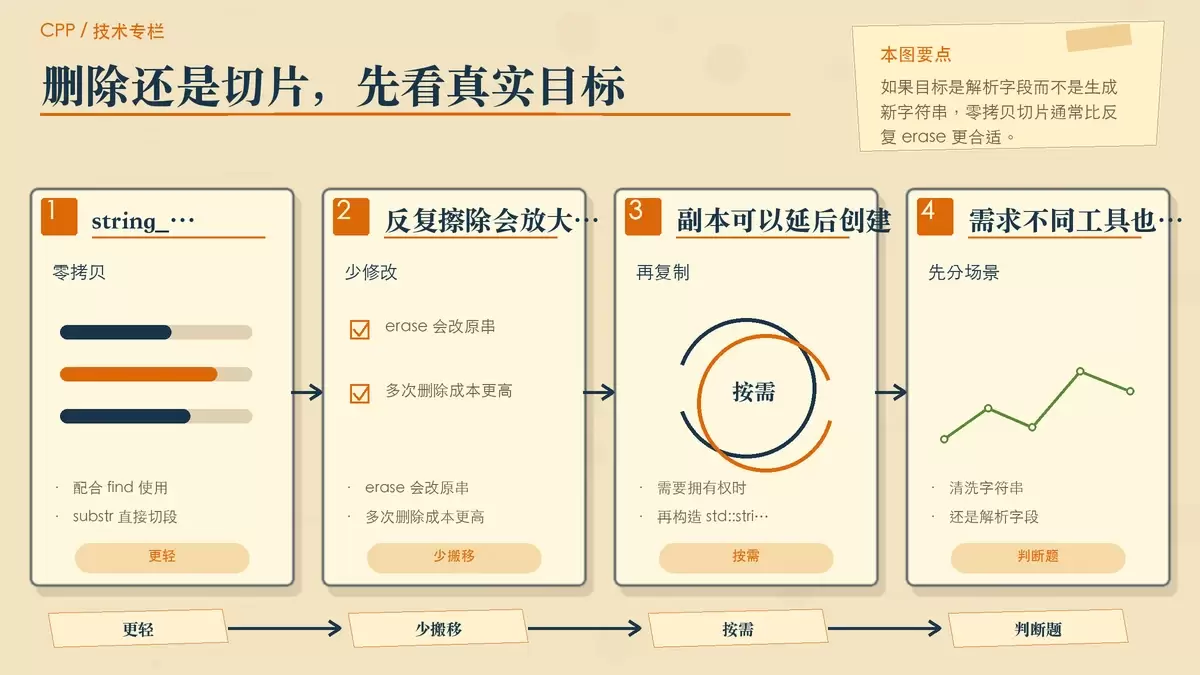
原因很简单:erase 会修改原字符串,每次删除都可能触发后续字符搬移。字符串越大、删除次数越多,这种成本越明显。尤其是在日志解析、协议字段处理、配置读取这类场景里,反复擦除通常不是最轻的办法。
从 C++17 开始,更适合这类任务的是 std::string_view。它可以配合 find 和 substr 做只读切片,直接引用原字符串中的一段内容,不额外拷贝数据。
- 如果只是遍历、比较、解析字段,用
std::string_view往往就够了; - 只有在确实需要拥有独立字符串副本时,再执行
std::string{sv}; - 第三方库如
absl::StrSplit、boost::split也常围绕这种思路来减少冗余复制。
这类场景里,一个很实用的判断标准是:你到底需要“一个已经删干净的新字符串”,还是只需要“访问被分开的各段内容”。如果答案是后者,那么直接切片几乎总比反复删除更合理。
换句话说,分隔符处理的第一步不该是写代码,而是先确认需求模型。是清洗字符串,还是解析结构?这两个问题看似接近,选用的工具却并不一样。
兼容 C++11/14:封装 erase_all 比临时拼循环更稳
如果项目还没有上 C++20,就不能直接使用 std::erase。这时更稳妥的做法,不是每次现场写一段删除逻辑,而是直接封装成一个可复用函数,把“删字符”和“删子串”分别处理。
void erase_all(std::string& s, char c) {
    s.erase(std::remove(s.begin(), s.end(), c), s.end());
}

void erase_all(std::string& s, const std::string& substr) {
    size_t pos = 0;
    while ((pos = s.find(substr, pos)) != std::string::npos) {
        s.erase(pos, substr.length());
    }
}
第一个版本使用的是经典的 erase-remove idiom,也就是 std::remove 配合 erase。这是 C++ 里处理“删除所有某字符”的惯用写法,简洁而且效率稳定,老标准项目里很常见。
第二个版本则是前面提到的子串删除循环。把它封装起来的价值在于:
- 减少重复代码,避免每个调用点各写一套;
- 把查找起点、删除长度这些容易写错的细节收口到一个地方;
- 以后如果要补边界处理或做行为约束,也只需要改一个函数。
有些代码会尝试用 replace 把目标替换成空字符串,看起来也能达到效果,但这通常不是更好的选择。因为本质上它仍然涉及分配和拷贝,语义上也不如直接 erase 明确。既然目标就是删除,就用删除接口表达意图,代码会更直接。
最后一个边界:重叠匹配该怎么定义
真正容易被忽略的,不是 API 写法,而是业务规则本身。尤其当分隔符可能发生重叠时,删除结果并不是天然唯一的。
例如删除 "aa" 时,字符串 "aaaa" 应该得到什么结果?是删成空字符串,还是留下 "aa"?这取决于你采用的是“非重叠删除”还是把重叠情况按另一种规则处理。
上面给出的循环实现,默认是按非重叠方式删除。也就是说,每次匹配到一个子串后就把这一段擦掉,然后继续在当前位置查找新的匹配。这种行为在大多数文本清洗、分隔符移除任务里已经足够,而且结果可预测。
如果你的业务要求把重叠关系也纳入匹配策略,那么查找起点的推进方式就要重新定义。原文中的结论是:若需重叠处理,擦除后应把 pos 设为 pos + 1,而不是保持原值。无论最终采用哪种规则,关键都在于先把语义定下来,再决定循环怎么写。库函数只负责提供工具,不会替你决定业务含义。
因此,处理“去掉所有分隔符”时,最实用的判断顺序通常是:
- 先判断分隔符是单字符还是子串;
- 再判断你要的是原地删除,还是只做切分访问;
- 最后确认是否存在连续匹配、相邻匹配或重叠匹配这类边界规则。
把这三层问题分开后,代码选择就会清晰很多:C++20 的单字符删除用 std::erase,多字符删除用 find + erase,仅做解析时优先 std::string_view,旧标准项目则封装好自己的 erase_all。









