


在 C++ 里,`map`、`set` 这类关联式容器几乎每个项目都会用到,但真正的问题往往不在“会不会用”,而在“选得对不对、写得稳不稳”。这篇文章按选型、安全访问和实现模式三个层次展开,既保留常用容器的性能事实,也补齐查找、插入、迭代、并发和异常处理里的高频坑点,方便你在具体业务里做出更可靠的判断。
关联式容器到底解决什么问题
关联式容器是 C++ 标准模板库(STL)中基于键组织数据的一类容器,适合做快速检索、插入和删除。和 vector、list 这类顺序容器不同,它们不是按插入顺序线性管理元素,而是依赖底层数据结构来维护查找能力。
常见关联式容器有哪些
C++ 中常见的有序关联式容器包括以下四种:
| 容器 | 关键特性 | 有序 | 唯一键 |
|---|---|---|---|
set | 存储唯一键 | 是 | 是 |
map | 存储键值对 | 是 | 是 |
multiset | 允许重复键 | 是 | 否 |
multimap | 允许键值对中重复键 | 是 | 否 |
如果进一步扩大到无序容器,对应还有 unordered_set、unordered_map、unordered_multiset 和 unordered_multimap。
底层结构和性能差异
有序关联式容器通常基于红黑树实现,无序关联式容器通常基于哈希表实现,因此两者在操作复杂度和使用场景上差异明显。
graph TD
    A[关联式容器] --> B[红黑树]
    A --> C[哈希表]
    B --> D[set]
    B --> E[map]
    B --> F[multiset]
    B --> G[multimap]
    C --> H[unordered_set]
    C --> I[unordered_map]
    C --> J[unordered_multiset]
    C --> K[unordered_multimap]
性能上可以先记住一条简单结论:
- 有序容器的搜索、插入、删除通常为
O(log n) - 无序容器的搜索、插入、删除平均为
O(1)
但“平均 O(1)”并不意味着无序容器永远更好。如果你需要稳定顺序、范围查询或按键排序遍历,有序容器依然更合适。
一个最基础的 map 示例
先看一个标准的 std::map 用法:
#include <iostream>
#include <map>
#include <string>

int main() {
    // 创建一个学生姓名和分数的 map
    std::map<std::string, int> studentScores;

    // 插入元素
    studentScores["Alice"] = 95;
    studentScores["Bob"] = 87;
    studentScores["Charlie"] = 92;

    // 访问元素
    std::cout << "Alice 的分数:" << studentScores["Alice"] << std::endl;

    // 遍历 map
    for (const auto& [name, score] : studentScores) {
        std::cout << name << ": " << score << std::endl;
    }

    return 0;
}
这段代码能正常工作,但也埋着一个初学者常见问题:operator[] 在键不存在时会默认构造并插入新元素。做“只读查询”时,这并不总是安全。
先选对容器,再谈性能和安全
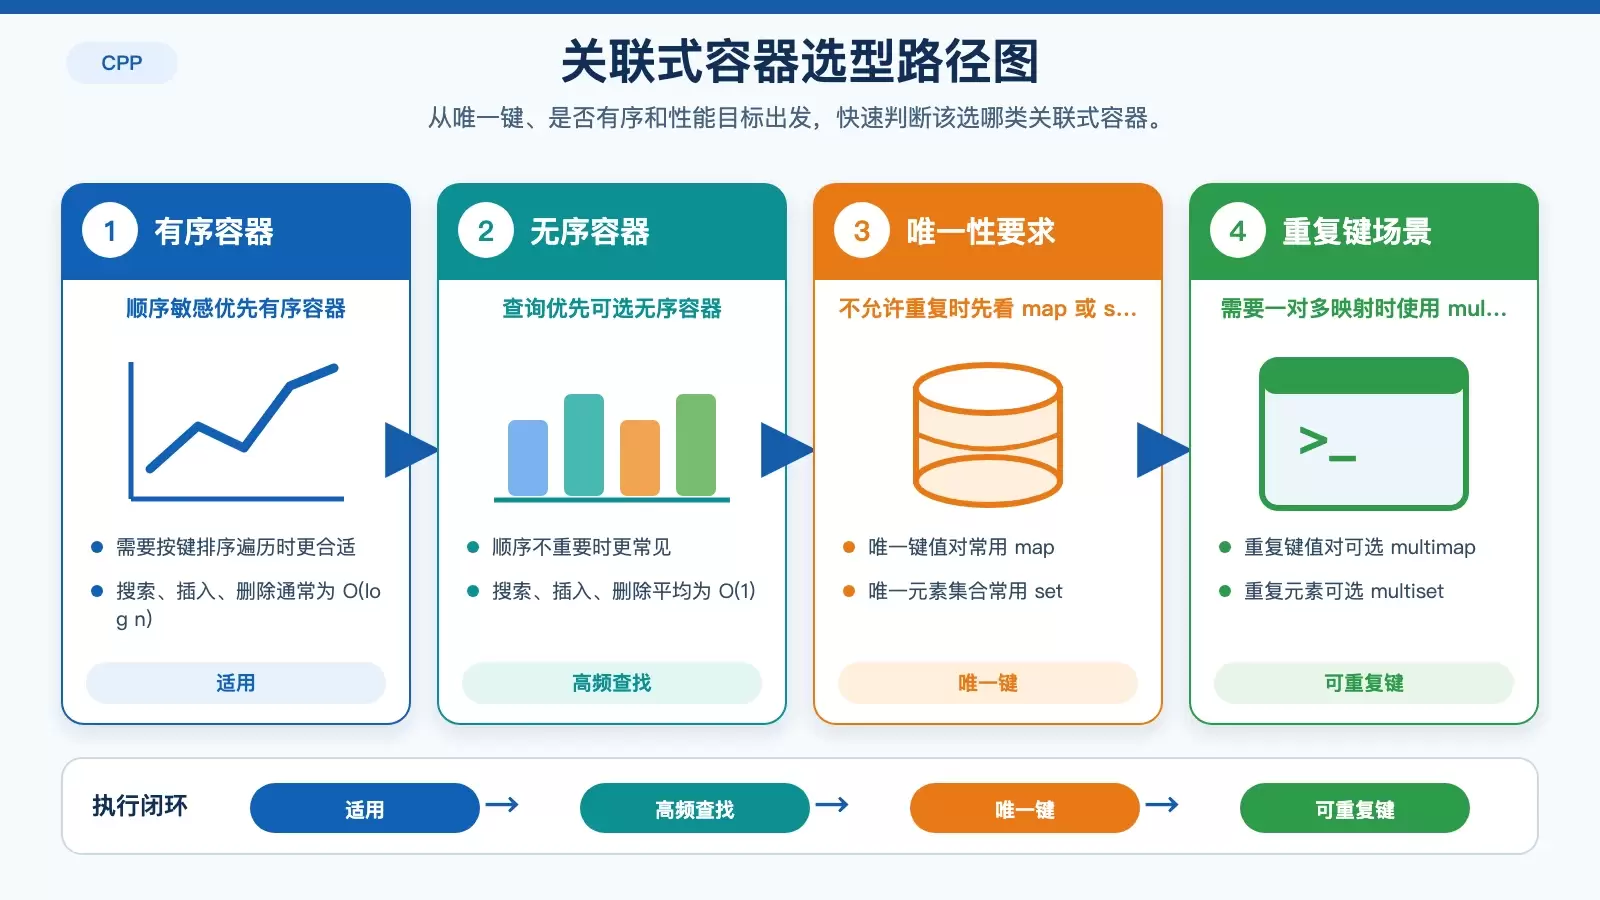
很多关联式容器问题,本质上都来自一开始选错了容器。判断时建议先看三个维度:是否需要唯一键、是否需要有序、是否更关注极致查找性能。
一个够用的选型思路
graph TD
    A[容器选择] --> B{唯一键?}
    B -->|是| C{有序存储?}
    B -->|否| D{有序存储?}
    C -->|是| E[map]
    C -->|否| F[unordered_map]
    D -->|是| G[multimap]
    D -->|否| H[unordered_multimap]
有序和无序容器怎么取舍
| 容器 | 关键特性 | 最佳使用场景 | 性能 |
|---|---|---|---|
set | 唯一、有序键 | 维护已排序的唯一元素 | O(log n) 操作 |
map | 唯一键值对 | 字典式结构 | O(log n) 操作 |
multiset | 多个有序键 | 频率跟踪 | O(log n) 操作 |
multimap | 多个键值对 | 复杂映射 | O(log n) 操作 |
unordered_set | 唯一、哈希键 | 快速查找 | 平均 O(1) |
unordered_map | 唯一键值对 | 高性能查找 | 平均 O(1) |
如果你的需求是“维护排序结果、按区间查找、稳定遍历顺序”,优先考虑有序容器;如果需求是“高频查询、顺序无所谓”,unordered_map 往往更贴近目标。
两个典型场景
场景 1:唯一且按键有序的字典
#include <map>
#include <string>

class StudentRegistry {
private:
    std::map<std::string, int> studentGrades;
public:
    void addStudent(const std::string& name, int grade) {
        studentGrades[name] = grade;  // 插入后会按键自动保持有序
    }
};
场景 2:频率统计
#include <unordered_map>
#include <vector>

class FrequencyCounter {
public:
    std::unordered_map<int, int> countFrequency(const std::vector<int>& numbers) {
        std::unordered_map<int, int> frequencies;
        for (int num : numbers) {
            frequencies[num]++;
        }
        return frequencies;
    }
};
频率统计这种场景通常不关心顺序,直接使用 std::unordered_map 更符合访问模式。
选型前可以先问自己这几件事
- 你需要唯一键还是允许重复键?
- 顺序是否重要?
- 你的性能目标更偏向稳定复杂度还是平均查询速度?
- 数据集规模有多大?
- 访问模式是读多写少,还是高频更新?
安全使用时,最容易踩的坑是什么
教程里最容易被忽略的一点是:关联式容器“能用”不代表“用法安全”。很多 bug 都发生在查找、插入和迭代细节里。
查找时优先考虑 find()
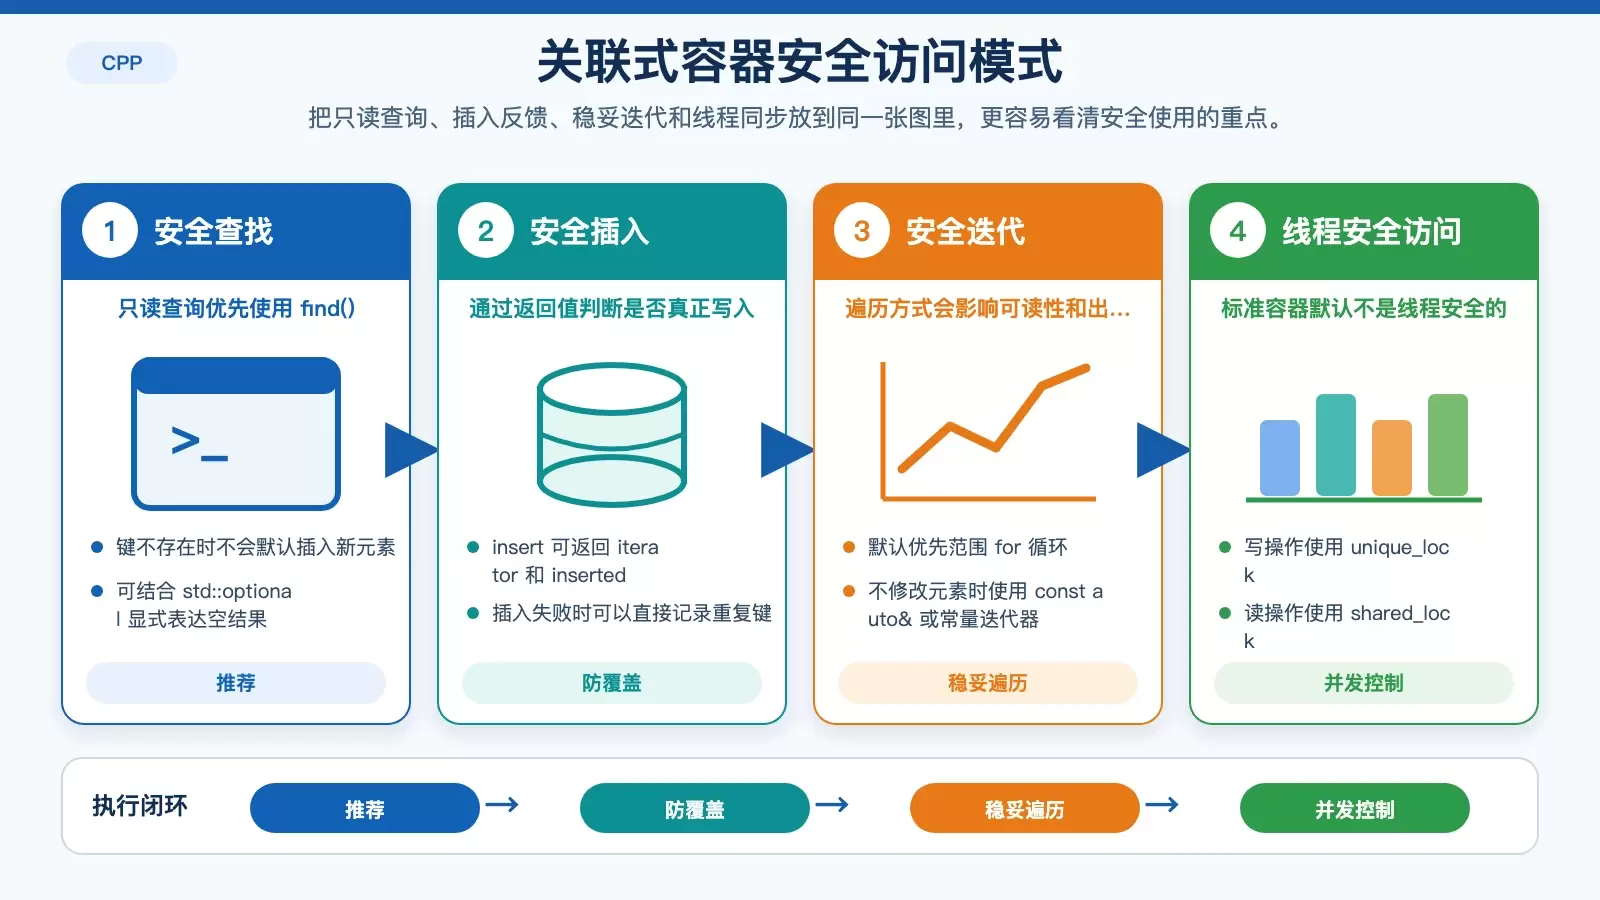
如果只是判断键是否存在,或者只想读取已有值,find() 往往比直接使用 operator[] 更安全,因为后者可能触发意外插入。
#include <map>
#include <iostream>
#include <optional>

class SafeDataStore {
private:
    std::map<std::string, int> dataMap;

public:
    std::optional<int> getValue(const std::string& key) {
        auto it = dataMap.find(key);
        return (it != dataMap.end()) ? std::optional<int>(it->second) : std::nullopt;
    }

    void insertSafely(const std::string& key, int value) {
        auto [iterator, inserted] = dataMap.insert({key, value});
        if (!inserted) {
            std::cerr << "键已存在:" << key << std::endl;
        }
    }
};
这里有两个值得保留的实践:
- 查询返回
std::optional<int>,显式表达“可能不存在” - 插入时检查
insert的返回结果,而不是默认覆盖旧值
迭代时尽量使用更稳妥的方式
graph TD
    A[迭代策略] --> B[基于范围的 For 循环]
    A --> C[基于迭代器的遍历]
    A --> D[常量迭代器]
    B --> E[最安全的方法]
    C --> F[更多控制]
    D --> G[防止修改]
遍历时的一般建议是:
- 默认优先使用范围
for,代码更短,也更不容易写错 - 不需要修改元素时使用
const auto&或常量迭代器 - 涉及删除或复杂条件移动时,再使用显式迭代器并仔细处理失效规则
几个高频误区
- 使用了不适合的容器类型
- 忽略性能影响,只看接口是否顺手
- 忽略内存消耗
- 不理解迭代器失效规则
把代码写稳的实现模式
当关联式容器进入真实项目后,问题通常不再只是“选哪个”,而是怎样把访问控制、异常处理和并发读写组织得足够可靠。
并发访问要显式设计线程安全
标准关联式容器默认不是线程安全的。如果多个线程同时读写同一个容器,需要自己加同步机制。
#include <map>
#include <shared_mutex>

class ThreadSafeMap {
private:
    std::map<std::string, int> dataMap;
    mutable std::shared_mutex mutex;

public:
    void write(const std::string& key, int value) {
        std::unique_lock<std::shared_mutex> lock(mutex);
        dataMap[key] = value;
    }

    std::optional<int> read(const std::string& key) const {
        std::shared_lock<std::shared_mutex> lock(mutex);
        auto it = dataMap.find(key);
        return (it != dataMap.end()) ? std::optional<int>(it->second) : std::nullopt;
    }
};
这类写法的核心是把“读共享、写独占”区分开,避免竞争条件在业务层随机出现。
内存管理和资源生命周期也要一起考虑
| 模式 | 描述 | 建议 |
|---|---|---|
| RAII | 资源获取即初始化 | 始终优先使用 |
| 智能指针 | 自动内存管理 | 与容器一起使用 |
| 复制 - 写入 | 高效内存处理 | 考虑大型数据集 |
如果容器里存放的是复杂对象或资源句柄,就不能只盯着查找复杂度,还要评估复制成本、所有权关系和异常时的清理路径。
异常安全可以单独设计
#include <map>
#include <stdexcept>

class ExceptionSafeContainer {
private:
    std::map<std::string, std::string> safeMap;

public:
    void updateValue(const std::string& key, const std::string& value) {
        try {
            // 强异常保证
            auto tempMap = safeMap;
            tempMap[key] = value;
            std::swap(safeMap, tempMap);
        } catch (const std::exception& e) {
            // 记录并处理潜在错误
            std::cerr << "更新失败:" << e.what() << std::endl;
        }
    }
};
这个思路的重点是先在临时对象上完成修改,再通过 std::swap 替换原数据,从而提供更强的异常保证。
输入验证不要放到最后补
#include <map>
#include <regex>
#include <string>

class ValidatedMap {
private:
    std::map<std::string, std::string> validatedData;

    bool isValidKey(const std::string& key) {
        return std::regex_match(key, std::regex("^[a-zA-Z0-9_]+$"));
    }

public:
    bool insert(const std::string& key, const std::string& value) {
        if (!isValidKey(key)) {
            return false;
        }
        validatedData[key] = value;
        return true;
    }
};
对于外部输入参与键构造的场景,先做校验再进入容器,比事后清理更可靠。
graph LR
    A[安全技术] --> B[验证]
    A --> C[错误处理]
    A --> D[内存管理]
    B --> E[输入清理]
    C --> F[异常处理]
    D --> G[智能指针]
一套更适合项目落地的工作流程
如果你想把关联式容器用得更稳,建议按下面的顺序推进,而不是先写完再零散补丁式修修补补。
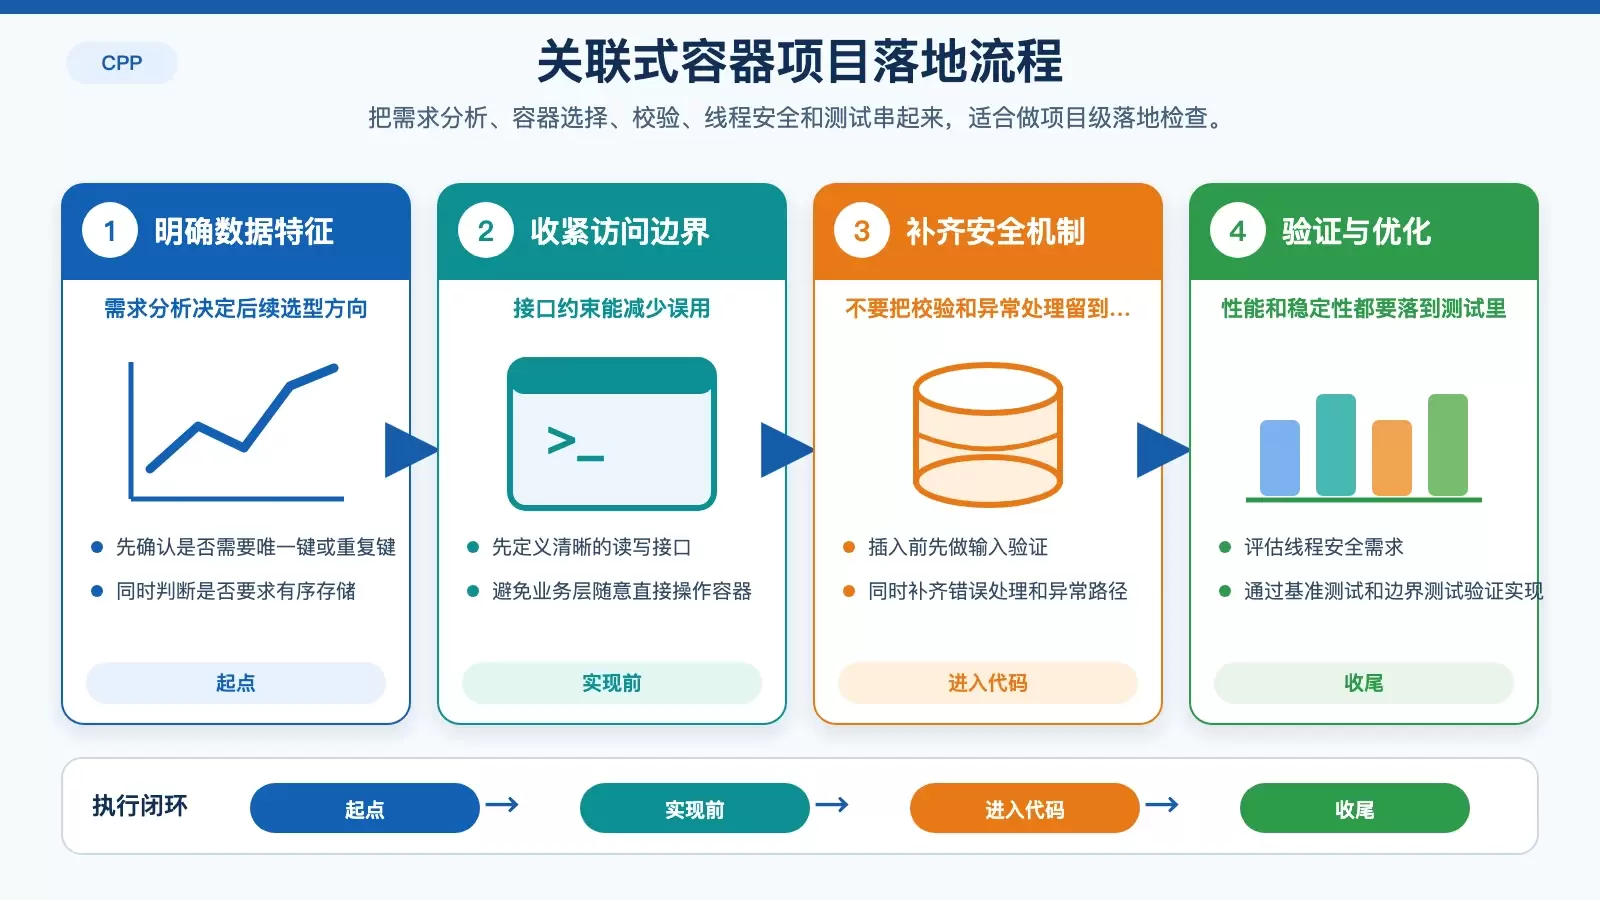
- 先分析需求:唯一键、重复键、有序、无序、数据规模、访问模式
- 选择合适的容器
- 定义清晰接口,约束读写方式
- 补上验证机制和错误处理
- 提前评估线程安全需求
- 做分析、基准测试和边界测试
这类流程看起来比“直接写”慢一点,但通常能显著减少后期因为容器误用而产生的隐蔽 bug。
总结
安全使用 C++ 关联式容器,关键不只是记住 map、set 的接口,而是把容器选型、访问方式和实现约束一起考虑。只要你能明确是否需要顺序、是否允许重复键,并在查找、插入、迭代、并发和异常处理上采用更稳妥的模式,这类容器就能在保证性能的同时,把很多隐藏风险提前消化掉。









