


部署 Go 服务时,启动命令里常能看到 GOMAXPROCS=2 ./server,不少项目还会在代码里顺手写上 runtime.GOMAXPROCS(runtime.NumCPU())。问题是,这些做法在容器环境里未必正确:宿主机可能有 64 个逻辑 CPU,但容器真正拿到的 CPU limit 只有 2,沿用旧习惯反而会把并行度设高,放大 CPU throttling 和尾延迟问题。本文从运行时机制、Go 1.25 之后的变化,以及仍需手动干预的场景三部分来拆解,帮助你判断自己的项目该信默认值,还是该显式配置。
GOMAXPROCS 控制的到底是什么
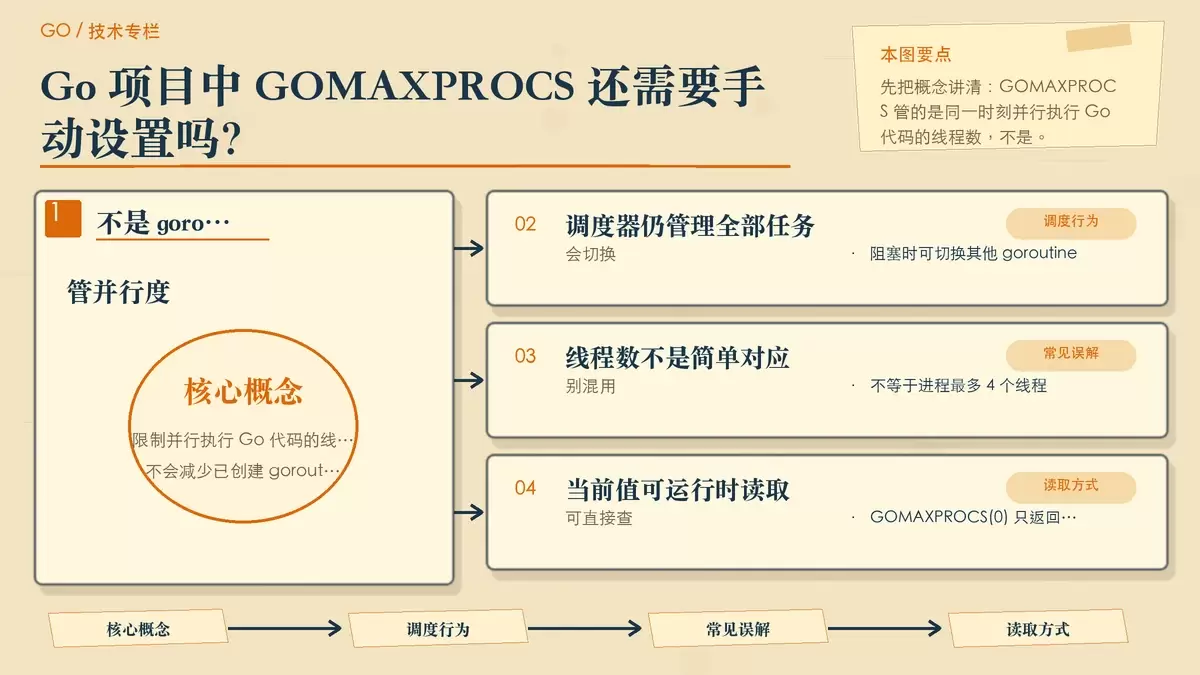
GOMAXPROCS 控制的不是 goroutine 总数,而是同一时刻最多允许多少个操作系统线程并行执行用户态 Go 代码。
这意味着,即使程序里创建了 1000 个 goroutine,把 GOMAXPROCS 设为 4,也不是“只能跑 4 个 goroutine”。运行时依然会管理全部 goroutine,只是在任意时刻,最多让 4 个线程并行执行 Go 代码。遇到阻塞、休眠、网络等待时,调度器还会切换到其他可运行 goroutine。
查看当前值可以直接用下面这段代码:
package main

import (
    "fmt"
    "runtime"
)

func main() {
    fmt.Println(runtime.GOMAXPROCS(0))
}
向 runtime.GOMAXPROCS 传入小于 1 的参数时,不会修改配置,只会返回当前设置。
还要区分一点:阻塞在系统调用中的线程,并不直接受这个数量限制。所以 GOMAXPROCS=4 不能理解成“整个进程最多只有 4 个线程”,更不能把它当作连接池、任务队列或业务并发控制的替代品。
为什么容器环境里最容易配错
问题集中出现在容器里,是因为“机器能看到多少 CPU”和“容器能稳定使用多少 CPU”往往不是一回事。
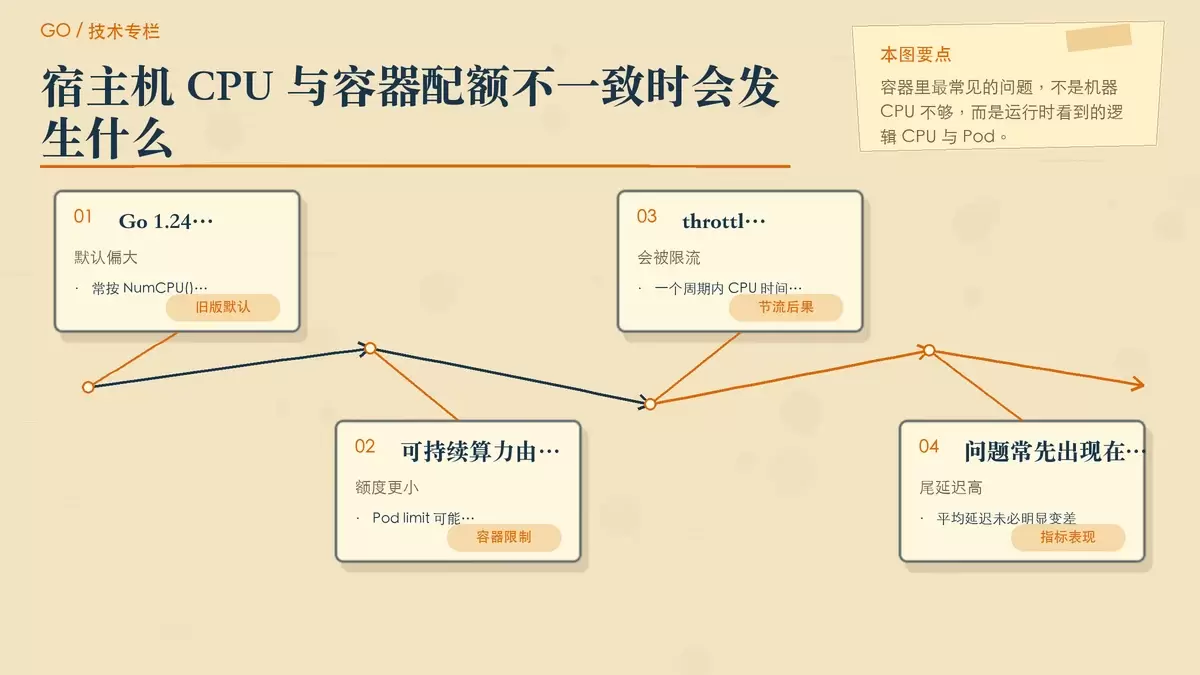
在 Go 1.24 及更早版本中,默认值通常取自程序启动时 runtime.NumCPU() 返回的逻辑 CPU 数量。但容器里看到的逻辑 CPU 数量,可能仍然接近宿主机,而不是容器实际被分配到的 CPU 配额。
例如 Kubernetes 节点有 64 个逻辑 CPU,而某个 Pod 的限制只有 2 核:
resources:
  limits:
    cpu: "2"
如果旧版 Go 运行时仍按 64 来决定并行度,那么一旦大量 goroutine 同时做计算,进程就可能在很短时间内耗尽 cgroup 当前周期允许使用的 CPU 时间,随后被 Linux 暂停到下一个周期。
这里的影响不只是“线程调度慢一点”。一旦发生 throttling,进程可能在一段时间内整体拿不到 CPU,连垃圾回收和请求处理都会一起受影响。平均延迟有时看不出问题,但 P99、P999 这类尾延迟往往会突然冒尖。
这也是为什么过去很多容器化 Go 项目会引入 go.uber.org/automaxprocs:它在程序启动时读取 cgroup CPU quota,再把 GOMAXPROCS 调整到更接近容器实际资源上限的值。
Go 1.25 之后,默认行为已经变了
从 Go 1.25 开始,运行时在 Linux 上加入了容器感知的 GOMAXPROCS 默认值,Go 1.26 继续沿用这一机制。前提是没有手动指定 GOMAXPROCS。
此时运行时会综合三类信息,并取其中最小值:
- 机器的逻辑 CPU 数量
- 当前进程的 CPU 亲和性掩码
- cgroup 配置的 CPU quota
其中,CPU quota 如果是 2.5 核,运行时会向上取整到 3,以尽量吃满配额。仅按 cgroup quota 算出的默认值不会低于 2;但如果逻辑 CPU 数量或 CPU 亲和性掩码本身只允许使用 1 个 CPU,最后结果仍可能是 1。
另一个容易被忽略的变化是:运行时不是只在启动时计算一次。所有操作系统上,它都会周期性检查可用逻辑 CPU 和 CPU 亲和性掩码;在 Linux 上还会检查 cgroup quota 的变化。检查频率通常不会超过每秒一次,程序空闲时可能更低。
不过,这套新行为要生效,通常要满足两个前提。
前提一:看的是 CPU limit,不是 CPU request
在 Kubernetes 里,cgroup quota 通常对应的是 CPU limit,不是 CPU request。如果 Pod 只配了 request,没有配置 limit,运行时不会用 request 来计算 GOMAXPROCS,因为 request 表示调度与资源保障,不代表硬性 CPU 上限。
前提二:go.mod 的语言版本也要跟上
除了升级工具链,项目还应在 go.mod 中声明 Go 1.25.0 或更高版本:
module example.com/server

go 1.25.0
如果只是换了新的编译器,但模块里仍保留 go 1.24 或更低版本声明,那么容器感知和自动更新默认仍会关闭。这是 Go 通过 GODEBUG 维持兼容性的结果,所以“编译器升级了”不等于“默认行为已经变了”。
手动设置时,等于告诉运行时别再自动调
不少项目为了求稳,会在启动脚本或初始化代码里固定写死并行度,但在 Go 1.25 之后,这种“保险设置”本身就可能变成问题。
下面两种方式,都会让运行时认为开发者已经明确指定过值,从而关闭默认的周期性更新:
GOMAXPROCS=4 ./server或者:
func init() {
    runtime.GOMAXPROCS(4)
}
因此,过去常见的这句:
runtime.GOMAXPROCS(runtime.NumCPU())在新版 Go 里通常没有必要,放在容器里还可能覆盖掉运行时基于 CPU quota 算出的更合理结果。
如果确实要恢复旧行为或做对照测试,也可以通过 GODEBUG 开关控制:
- Linux 上用
GODEBUG=containermaxprocs=0关闭 cgroup 感知 - 所有操作系统上用
GODEBUG=updatemaxprocs=0关闭周期性更新
除非是兼容历史行为或排查问题,一般没有必要修改这两个开关。
如果程序此前已经手动改过并行度,后来希望重新回到运行时默认值,可以在 Go 1.25 及以上版本调用:
func restoreDefault() {
    runtime.SetDefaultGOMAXPROCS()
}
这个函数会重新计算默认值,并恢复后续自动更新能力。它也适合在程序明确知道 CPU 亲和性掩码或 cgroup quota 刚发生变化时,主动触发一次刷新。
哪些场景还值得手动调整
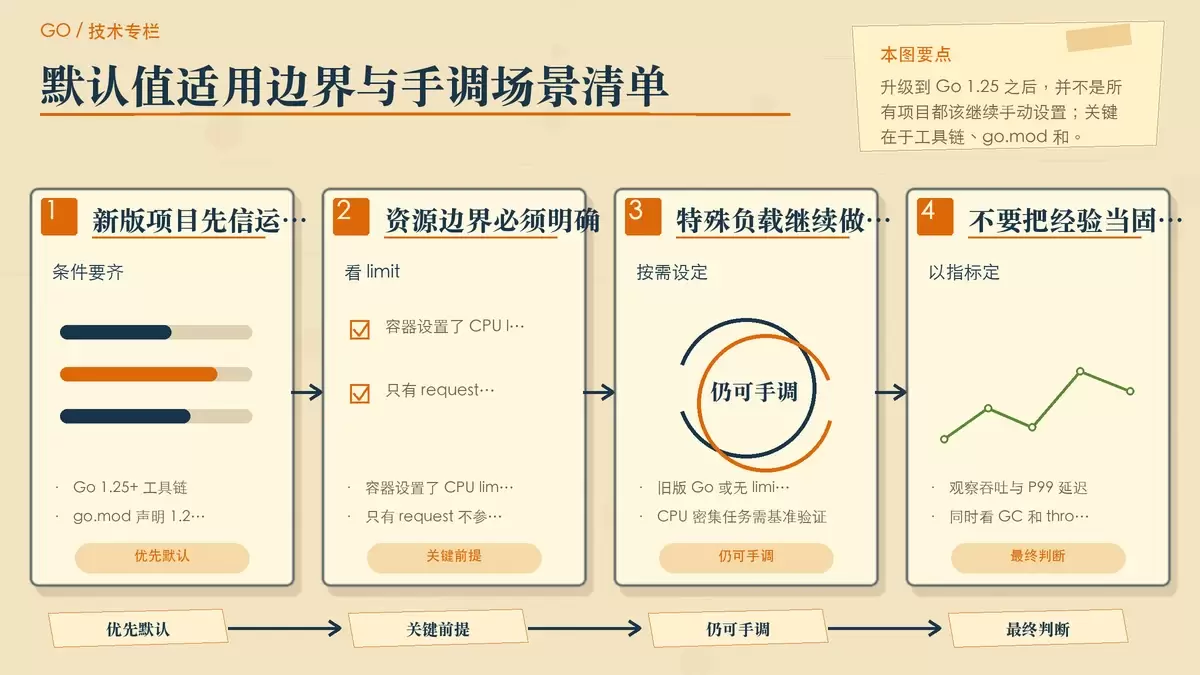
如果项目满足这几个条件:使用 Go 1.25 及以上工具链、go.mod 声明为 Go 1.25.0 或更高版本、容器明确设置了 CPU limit,那么大多数普通服务优先相信运行时默认值就够了。
但这不等于以后完全不用管。以下场景里,显式配置仍然有意义:
- 程序还运行在 Go 1.24 或更早版本
- 容器只有 CPU request,没有 CPU limit
- 需要主动给同机其他进程预留 CPU
- CPU 密集型任务经过基准测试后,确认限制并行度更合适
- 极短突发计算希望临时利用超过平均 quota 的并行能力
- 排查调度、GC 或尾延迟问题时,需要做对照实验
这里尤其要分清两件事:CPU limit 代表一个时间窗口内允许使用的平均 CPU 吞吐额度,而 GOMAXPROCS 代表同一时刻能并行执行多少份 Go 代码。两者相关,但并不完全等价。
某些突发型任务,的确可能从更高并行度中获益;但并行度拉高以后,也可能更快打满 cgroup 配额,提前触发 throttling。最终该怎么选,不能靠经验口号,还是要看真实流量或可信压测下的吞吐、P99 延迟、CPU throttling 和 GC 指标。
实际工程里,最好把关键运行时信息打到日志或监控里:
func logRuntimeConfig() {
    slog.Info("runtime config",
        "gomaxprocs", runtime.GOMAXPROCS(0),
        "num_cpu", runtime.NumCPU(),
    )
}
如果看到 runtime.GOMAXPROCS(0) 和 runtime.NumCPU() 不一样,不必立刻判断为异常。在新版 Go 中,这往往正说明运行时根据 CPU 亲和性掩码或容器 quota 主动下调了并行度。
结论:先理解资源边界,再决定要不要手动设
GOMAXPROCS 限制的是 Go 代码的执行并行度,不是 goroutine 数量,也不是整个进程的线程总数。设得过高,受限容器里容易频繁遭遇 CPU throttling;设得过低,又会浪费本来可用的算力。
对使用 Go 1.25 及以上工具链,并在 go.mod 中声明 Go 1.25.0 或更高版本的项目来说,默认应优先信任运行时的容器感知行为,不要再把 runtime.GOMAXPROCS(runtime.NumCPU()) 当成固定模板。只有在旧版本、没有 CPU limit,或存在明确的性能目标与实验需求时,才值得手动设置。
更实用的原则不是“永远手动设”或者“永远别设”,而是先搞清楚部署环境到底给了多少 CPU,再让并行度和真实资源约束对齐。









