


在 Go 里做标签解析、配置绑定、序列化适配时,反射几乎绕不过去。Go 1.26 给 reflect.Type 和 reflect.Value 增加了 Fields 方法,目的是把原本机械的字段索引循环改成更顺手的迭代接口。要判断它值不值得用,关键看三点:它能替你省掉哪些样板代码、哪些反射边界完全没变、以及在工具代码里该如何避开 panic 和误用。
过去遍历结构体字段,麻烦主要在哪
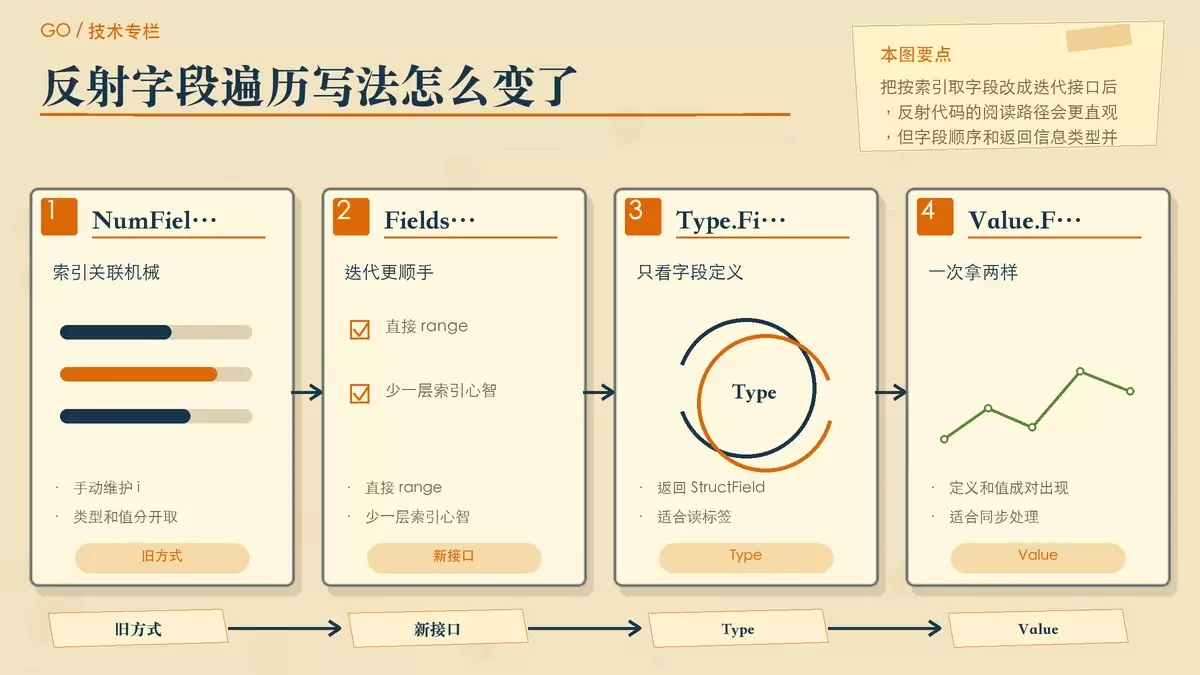
在 Go 1.26 之前,遍历结构体字段的常见写法是先取字段数量,再按索引分别从类型和值里拿数据:
t := reflect.TypeOf(user)
v := reflect.ValueOf(user)

for i := 0; i < t.NumField(); i++ {
    field := t.Field(i)
    value := v.Field(i)
    fmt.Println(field.Name, value)
}
这套写法本身没有问题,问题在于它很“机械”:类型信息和字段值依赖同一个 i 维持对应关系,读代码的人需要不断确认当前索引是不是拿对了对象。对于 ORM 映射、标签提取、结构体清洗这类经常要写反射辅助函数的场景,这类样板代码会反复出现。
因此,Fields 的意义首先不是增加新能力,而是把“按索引遍历字段”这件很常见的事情封装成了更贴近意图的接口。
Type.Fields:更适合处理字段定义和标签
reflect.Type 上新增的 Fields 方法,返回的是 iter.Seq[reflect.StructField]。也就是说,遍历时每次拿到的是一个字段定义,而不是字段值:
t := reflect.TypeOf(User{})

for field := range t.Fields() {
    name := field.Tag.Get("json")
    fmt.Println(field.Name, name)
}
这里的 field 是 reflect.StructField,里面保留了字段名、字段类型、标签、索引路径等信息。对以下场景,这个接口会比旧写法更自然:
- 提取
json、db、yaml等标签 - 生成字段映射表或配置元数据
- 做文档生成、校验规则收集、ORM 字段分析
它的遍历顺序与过去从 Field(0) 一直到 Field(NumField()-1) 完全一致,因此在行为上更像是语法层面的简化,而不是另一套新规则。使用时也可以直接 break,这点和普通迭代保持一致。
如果你的目标只是“看结构体长什么样”,例如读取标签、判断字段是否匿名、拿到类型信息,那么 Type.Fields 通常已经足够,不需要再同时准备一个 reflect.Value。
Value.Fields:一次同时拿到字段描述和值
如果不仅要读定义,还要读每个字段当前的值,那么对应的是 reflect.Value.Fields。它返回 iter.Seq2[reflect.StructField, reflect.Value],迭代时可以同时得到字段定义和值:
v := reflect.ValueOf(user)

for field, value := range v.Fields() {
    tag := field.Tag.Get("json")
    fmt.Println(tag, value)
}
这比旧写法省掉了“同一个索引取两次”的关联动作。对于需要边看标签边读值的代码,尤其是通用序列化、参数绑定、审计日志拼装之类的逻辑,可读性会直接好一些。
但这里要注意,Value.Fields 只是把遍历写法换了,反射约束并没有变:
- 如果传入的是指针,通常要先调用
Elem - 如果对指针、切片等非结构体类型直接调用
Fields,会 panic - 写通用工具时,应该先检查
Kind,同时处理 nil 指针
也就是说,这个 API 更像“更好用的入口”,不是“更宽松的反射模式”。凡是过去需要做的类型判断,现在仍然需要做。
能不能改值、会不会展开嵌入字段,边界都没变
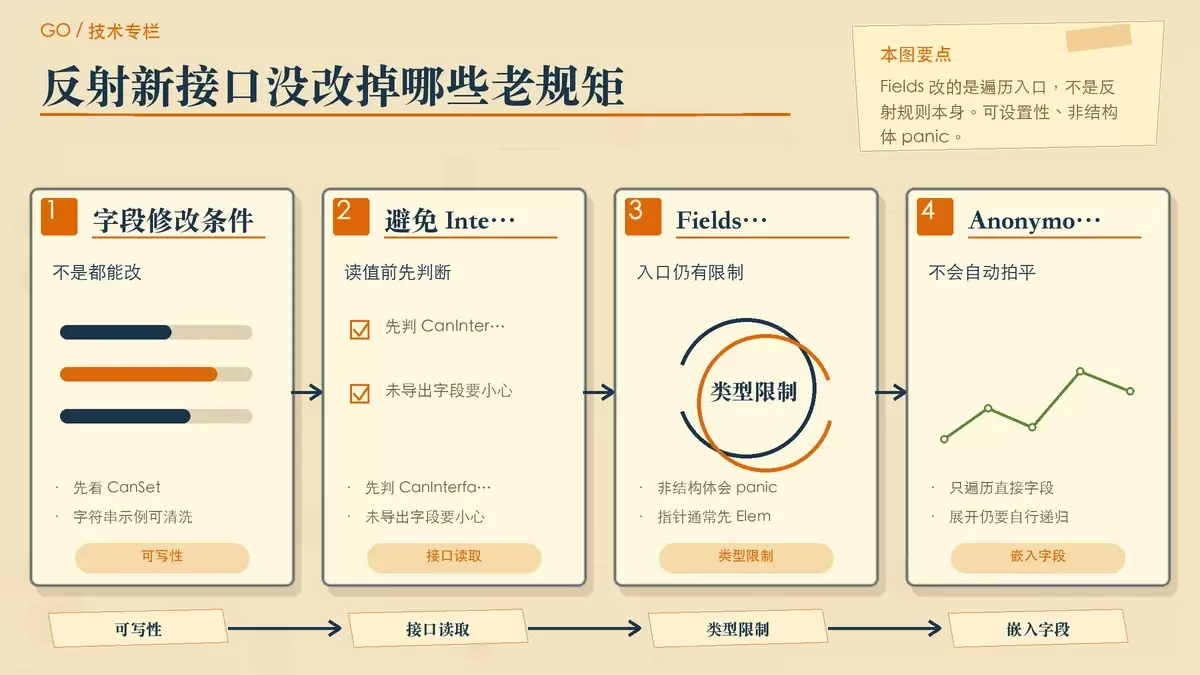
很多人看到 Value.Fields 后,第一反应是能不能顺手修改字段。答案是可以,但规则和 Value.Field(i) 完全一样:只有原始结构体可寻址、目标字段可设置时,修改才成立。
for _, value := range v.Fields() {
    if value.Kind() == reflect.String && value.CanSet() {
        value.SetString(strings.TrimSpace(value.String()))
    }
}
这里最重要的检查仍然是 CanSet。如果字段不可设置,直接调用设置方法就可能触发 panic。类似地,在打算把字段值转成接口前,也应先判断 CanInterface,因为未导出字段通常不能随意暴露为接口值。
另一个容易误判的地方是匿名嵌入字段。Fields 只遍历直接字段,不会自动帮你把嵌入结构体“拍平”。例如 Order 里有普通字段 ID,还有匿名嵌入的 Audit,遍历结果只会得到 ID 和 Audit,不会直接产生 Audit.CreatedAt 这样的子字段。
如果业务逻辑要求展开嵌入字段,做法仍然是基于 field.Anonymous 和字段类型自行递归。这一点尤其影响标签收集器、扁平化导出器、对象映射工具,迁移到 Fields 后也不要误以为递归逻辑可以删除。
新 API 会不会更快:重点还是测量而不是猜测
从实现意图看,Go 1.26 的 Fields 主要改善的是表达方式,而不是承诺性能收益。文章给出的结论很明确:底层仍然是按索引遍历 NumField,再调用 Field(i) 产生结果。
这意味着两件事。第一,把旧代码改成 Fields 写法,不应该默认期待吞吐量明显提升;第二,如果你的反射逻辑位于高频路径,仍然应该老老实实做 Benchmark,而不是根据 API 形式推断成本。
更实际的优化方向通常还是这些:
- 在初始化阶段缓存字段信息
- 避免重复解析同一类结构体标签
- 把反射留在边缘层,而不是放进核心热路径
换句话说,Fields 提升的是代码组织质量,对性能是否有帮助,要交给基准测试判断。
使用前先记住这几条判断标准
Type.Fields返回字段定义,适合分析结构体元信息Value.Fields同时返回字段定义和值,适合边读标签边处理内容- 两者都只按声明顺序遍历直接字段
- 非结构体类型调用会 panic,遇到指针通常要先解引用
- 修改前检查
CanSet,读取接口值前检查CanInterface - 需要 Go 1.26 工具链;使用迭代器
range时,模块语言版本至少为 Go 1.23,建议直接设置为go 1.26.0
如果你的代码主要是在做“结构体定义分析”,优先考虑 Type.Fields;如果你需要把字段描述和值一起送入处理流程,Value.Fields 会更顺手。它们确实让反射代码更接近业务意图,但不会绕过 Go 反射长期存在的类型检查、访问控制和性能边界。









