深入理解 MySQL 聚集索引:原理、选择规则与性能影响
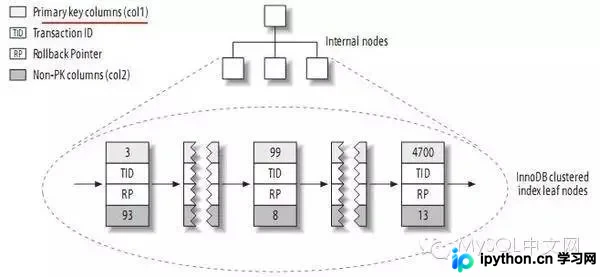
本文详解 MySQL InnoDB 存储引擎中的聚集索引(聚簇索引)概念。阐述其通过主键逻辑顺序决定数据物理存储顺序的特性,对比索引组织表(IOT)与堆组织表(HOT)的性能差异。梳理 InnoDB 自动选择聚集索引的三条核心规则,分析其对范围查询、更新碎片及回表开销的影响。
2026-10-13
6
本文详解 MySQL InnoDB 存储引擎中的聚集索引(聚簇索引)概念。阐述其通过主键逻辑顺序决定数据物理存储顺序的特性,对比索引组织表(IOT)与堆组织表(HOT)的性能差异。梳理 InnoDB 自动选择聚集索引的三条核心规则,分析其对范围查询、更新碎片及回表开销的影响。
本文介绍在Python中执行Hive SQL的两种主要方法:通过os.system直接运行脚本,以及利用os.popen配合pandas读取结果。重点解析如何设置hive.cli.print.header以显示表头,并探讨结合TensorFlow等框架时可能遇到的显存占用问题及优化思路。
本文详细介绍MySQL查询缓存的开启条件,包括配置文件参数 query_cache_type 的三种模式(OFF、ON、DEMAND),以及通过 SHOW VARIABLES 查看状态。重点解析 show status like 'qcache%' 中 Qcache_free_blocks 等核心指标的含义。最后说明如何利用 FLUSH QUERY CACHE 清理碎片或 FLUSH TABLES 清空缓存,帮助开发者根据实际场景优化数据库性能。
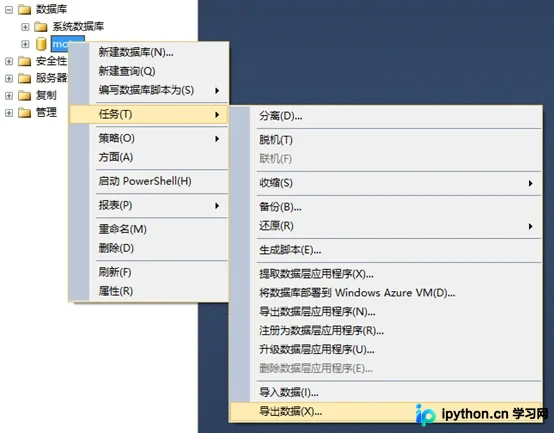
本文详细讲解如何在 SQL Server Management Studio (SSMS) 中将一个数据库的数据导出并迁移至另一个数据库。通过任务菜单触发向导,分别配置源与目标连接信息,支持直接复制表或自定义 SQL 查询两种模式,适用于本地开发环境切换或服务器间轻量级数据备份场景。
本文介绍在 Python 3 环境下使用 PyMySQL 模块连接 MySQL 数据库的方法。内容涵盖模块安装、数据库连接配置、以及利用游标执行查询、插入、修改和删除数据的具体代码示例,重点强调事务提交(commit)的必要性。
本文介绍如何利用PHP接收前端提交的JSON数据,使用json_decode函数将其解码为关联数组,并通过PDO预处理语句安全地将订单主表及明细列表数据批量插入MySQL数据库中。代码演示了从接收POST请求、数据提取到事务性写入的完整流程,重点解决了嵌套数组遍历与参数绑定的实际问题。
在并发场景下,多个线程使用 SELECT ... FOR UPDATE 可能因索引锁定顺序不一致产生死锁。当未提交的事务修改了非主键索引值(如状态字段),后续查询即使过滤掉该行,也会因不确定性而阻塞。通过分析执行顺序、统一加锁路径及监控长事务,可有效避免此类问题。
本文详细解析如何在Django项目中配置MySQL数据库并实现读写分离。通过修改settings.py添加主从库配置,使用pymysql驱动,并编写自定义数据库路由类MasterSlaveDBRouter。文章涵盖手动指定数据库与自动路由两种方案,帮助提升高并发场景下的数据库读写性能。
本文详细记录了在Ubuntu系统中,从安装MySQL到配置Node.js环境并实现Express应用连接数据库的完整流程。涵盖数据库建表、Node依赖安装、数据封装逻辑编写及页面交互测试,帮助开发者快速掌握Node.js与MySQL的基础集成方法。
本文详细解析C语言中的符号常量定义、变量声明及算术表达式计算规则。通过温度转换实例,对比整型与浮点运算差异,说明如何正确使用#define提升代码可读性,并掌握printf格式化输出的精度控制方法。
本文详细介绍如何在Python 3.x环境中使用PyMySQL库连接MySQL数据库。内容涵盖库的安装方法、基本连接与查询流程、事务提交与回滚操作,以及通过参数化查询防止SQL注入的安全实践。适用于Django等框架及独立脚本开发,提供完整的代码示例与注意事项。
本文介绍如何利用wxPython库创建图形用户界面,并结合PyMySQL连接本地MySQL数据库实现用户登录功能。内容涵盖窗口图标设置、静态图片展示、按钮事件绑定及数据库查询逻辑,提供完整代码示例与布局注意事项。