Python处理数据并导入Hive表的完整流程
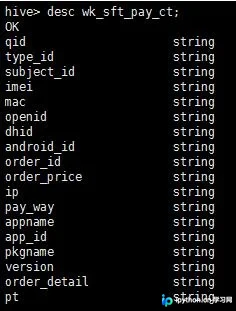
本文详细介绍如何利用Python将本地TXT文件中的数据清洗并导入Hive表。核心步骤包括:分析源数据与目标Hive表结构的差异,通过字段筛选与重排序实现结构对齐,处理JSON字段及空值,最后创建对应Hive表并使用LOAD DATA命令完成数据加载。
2026-10-13
6
本文详细介绍如何利用Python将本地TXT文件中的数据清洗并导入Hive表。核心步骤包括:分析源数据与目标Hive表结构的差异,通过字段筛选与重排序实现结构对齐,处理JSON字段及空值,最后创建对应Hive表并使用LOAD DATA命令完成数据加载。
本文详细讲解Python通过pyodbc库连接数据库的方法,涵盖驱动安装、64位ODBC配置及常见报错解决。通过完整代码示例演示连接、查询、参数化SQL、插入修改及提交事务等核心操作,帮助开发者高效实现数据库交互。
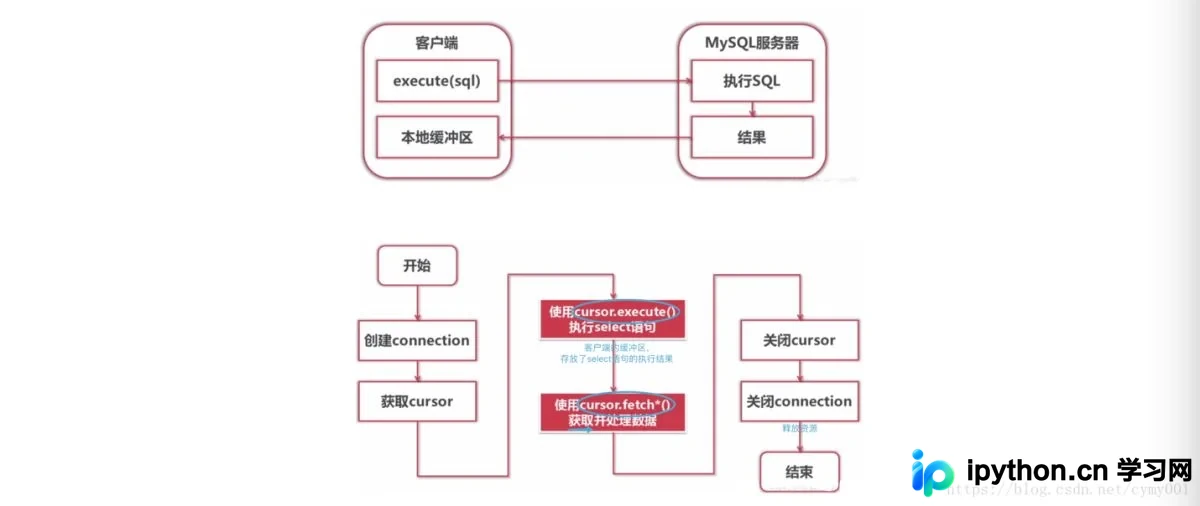
本文详细介绍在Mac系统下使用Python3的pymysql库连接MySQL数据库的完整流程。涵盖从环境配置、Navicat建表到Jupyter Notebook中执行SQL查询及数据插入的实操步骤,提供关键代码片段与参数说明,帮助开发者快速掌握Python操作数据库的核心方法。
本文详细解析如何在Flask框架中集成sqlite3数据库。通过新建models.py定义数据模型,利用flask_script扩展创建manage.py管理脚本,实现数据库初始化、数据保存及查询功能。文中提供了完整的代码示例与终端运行命令,帮助开发者快速掌握Flask与SQLite3的连接与操作方法。
MySQL 提供的 procedure analyse() 函数可自动分析表中数据分布,推荐更节省存储空间的字段类型(如将 VARCHAR 转为 CHAR 或调整 INT 范围)。通过指定 max_elements 和 max_memory 参数,开发者无需手动审查即可实现初步的存储优化,是提升数据库效率的有效手段。
本文介绍在Python中处理超长SQL语句的实用方法。通过将SQL字符串用括号包裹实现自动多行拼接,并在每行末尾添加%s占位符,最后使用元组依次传入变量值。该方法有效解决了长SQL编写困难、易出错及参数传递复杂的问题,提升代码可读性与维护性。
本文详解 MySQL 中 UNION 与 ORDER BY 同时使用的三种实现方式。通过具体示例说明直接混合使用会报错的原因,并分别介绍去除内部 ORDER BY、子查询包裹以及双层嵌套子查询的正确写法,确保查询结果按预期排序。
本文详细介绍如何在macOS终端中通过符号链接的方式,配置系统以使用XAMPP自带的MySQL。针对Rootless权限问题,提供禁用CSRutil的恢复模式解决方案,确保开发者能顺畅调用mysql命令进行数据库操作。
本文介绍了在Python中使用Pandas读取MySQL数据库数据并转换为DataFrame的两种主要方法。第一种方式基于SQLAlchemy引擎,适用于Pandas 1.9及后续版本,通过配置连接参数建立引擎后执行SQL查询;第二种方式利用MySQLdb直接连接数据库进行数据获取。文章提供了具体的代码示例和注意事项,帮助开发者根据项目需求选择合适的技术方案。
Python 3.x 已不再支持 MySQLdb,推荐使用 PyMySQL 库进行数据库交互。本文介绍了通过 pip3 install PyMySQL 安装库的方法,并展示了利用 pymysql 建立连接、执行 SQL 查询并将结果转换为 Pandas DataFrame 的完整代码示例,解决 No module named 'MySQLdb' 报错问题。
本文介绍如何利用Python和pymysql库批量执行SQL文件以修改多个数据库。通过连接数据库、遍历所有库、删除指定表后重新导入SQL脚本,实现自动化批量操作。文章详细解析了代码逻辑,包括处理编码问题、分割SQL语句及异常捕获,旨在提升数据库维护效率,减少重复劳动。
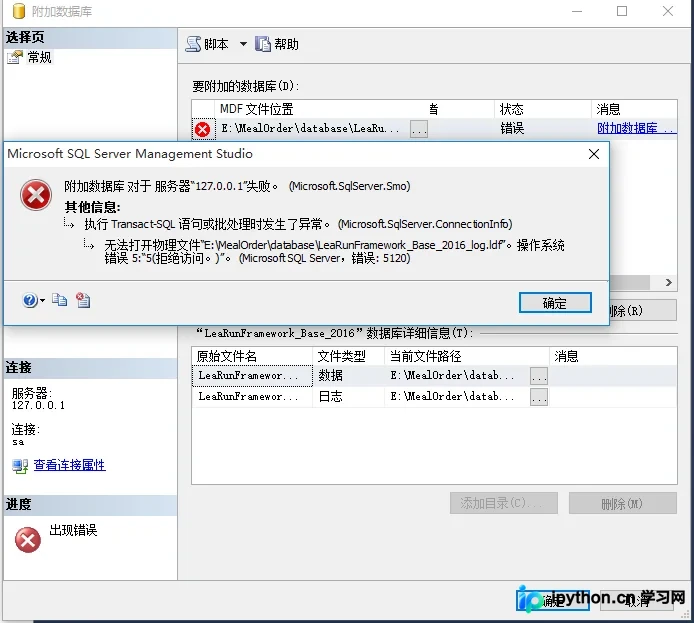
在使用SQL Server附加数据库时遇到“无法打开物理文件,操作系统错误5”是常见的权限问题。本文详细介绍如何通过修改数据库文件的“安全”选项,为Everyone用户授予“完全控制”权限来彻底解决该错误,附带完整操作截图与步骤指引。