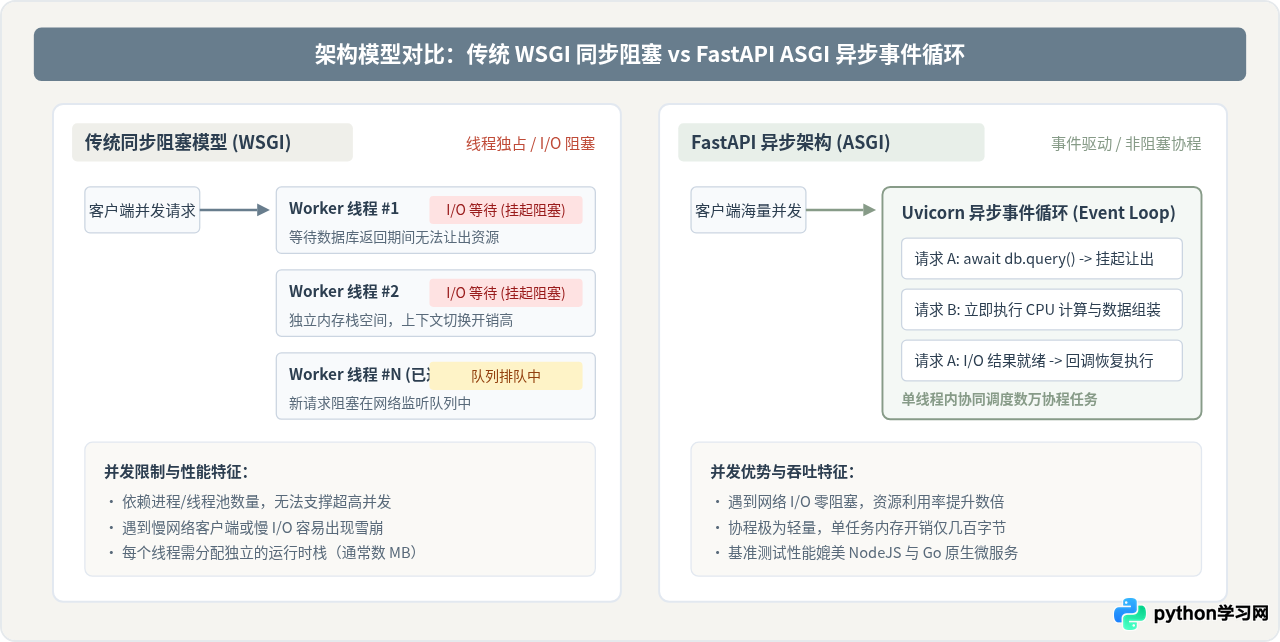
Python高性能Web框架推荐:FastAPI为何成为新宠
深入解析Python高性能现代Web框架FastAPI的核心优势、底层架构、与传统框架的关键差异以及实战使用方法,解答FastAPI为何成为现代后端与AI接口开发的新宠。
2026-10-29
47
深入解析Python高性能现代Web框架FastAPI的核心优势、底层架构、与传统框架的关键差异以及实战使用方法,解答FastAPI为何成为现代后端与AI接口开发的新宠。
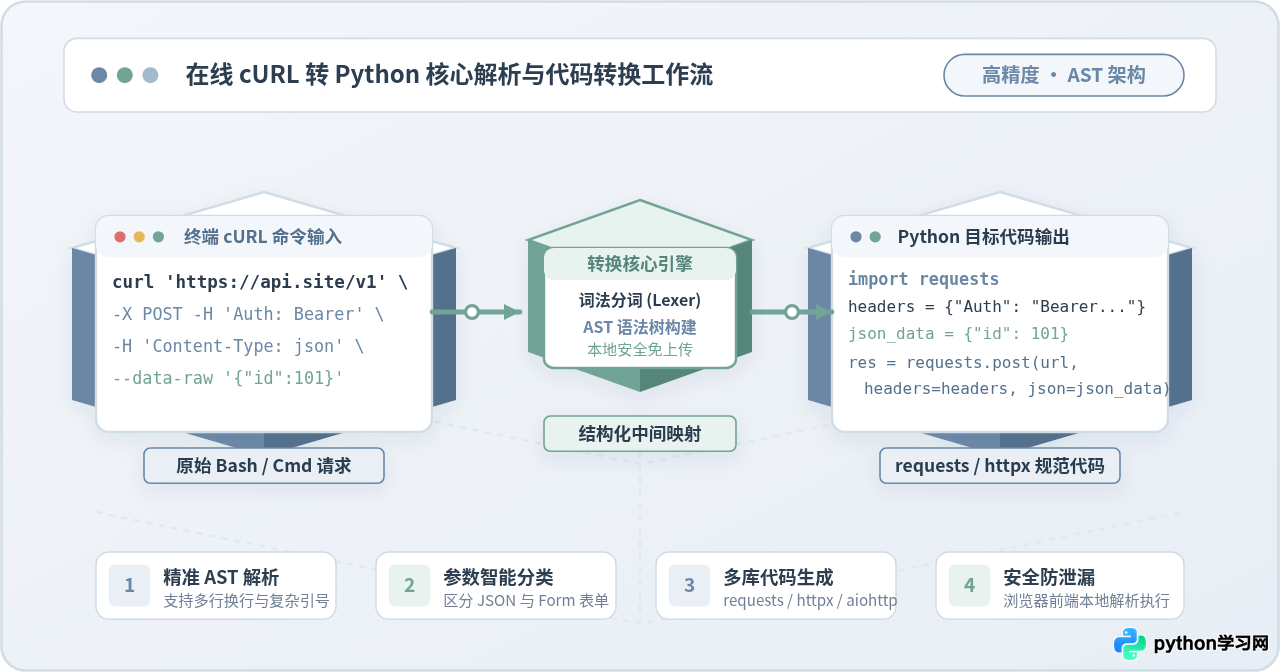
推荐几款准确度高、经受复杂请求考验的在线cURL转Python工具,解析语法树映射原理与参数转换避坑细节,帮助开发者快速完成网络请求代码复现。
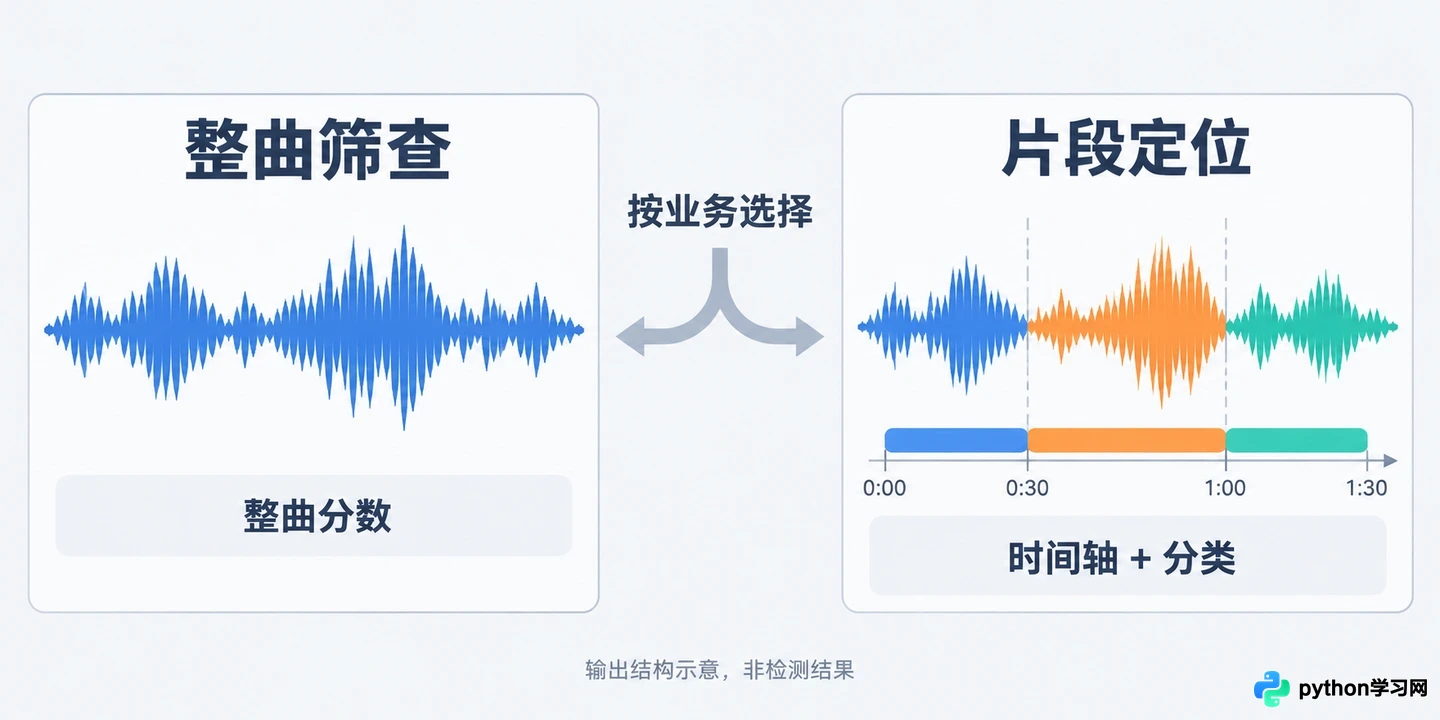
本文针对开发者将AI音乐检测接入自有应用的需求,解析Resemble、Pex和Hive三家主流API的集成逻辑。文章从业务场景切入,区分整曲判断与分段定位的不同需求,详细讲解各平台的认证方式、异步处理机制及结果解读误区,帮助开发者构建可复核、低风险的审核工作流。
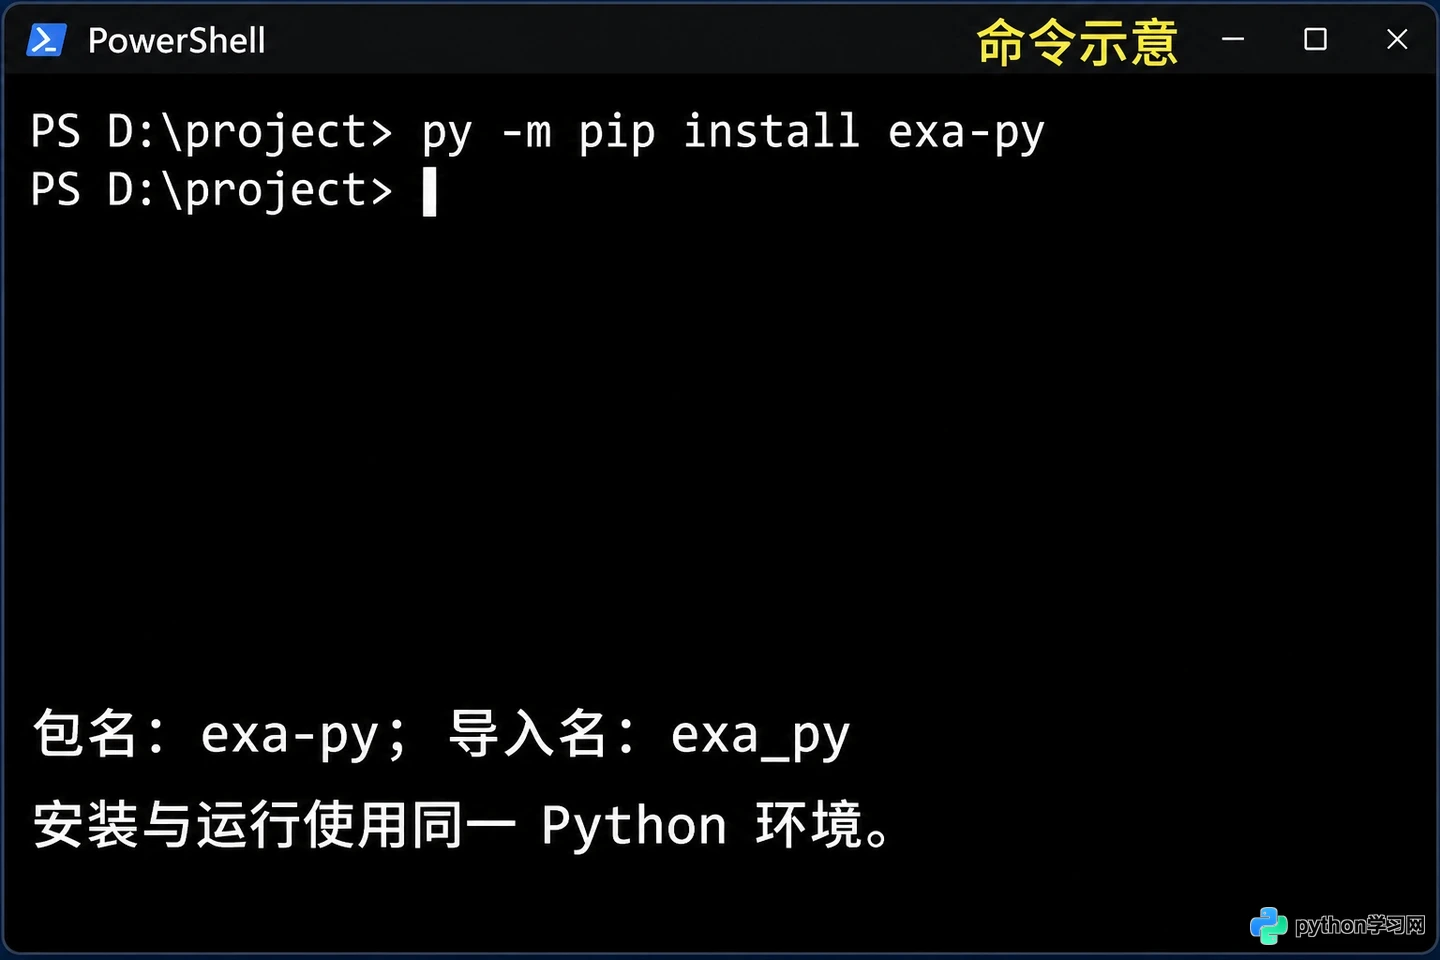
本文介绍如何在 Windows 环境下使用 Python 调用 Exa AI 搜索 API。内容涵盖环境配置、语义检索参数设置、客户端代码编写及结果对象解析,帮助开发者快速集成互联网网页的语义搜索功能,并正确提取标题、链接及相关片段。
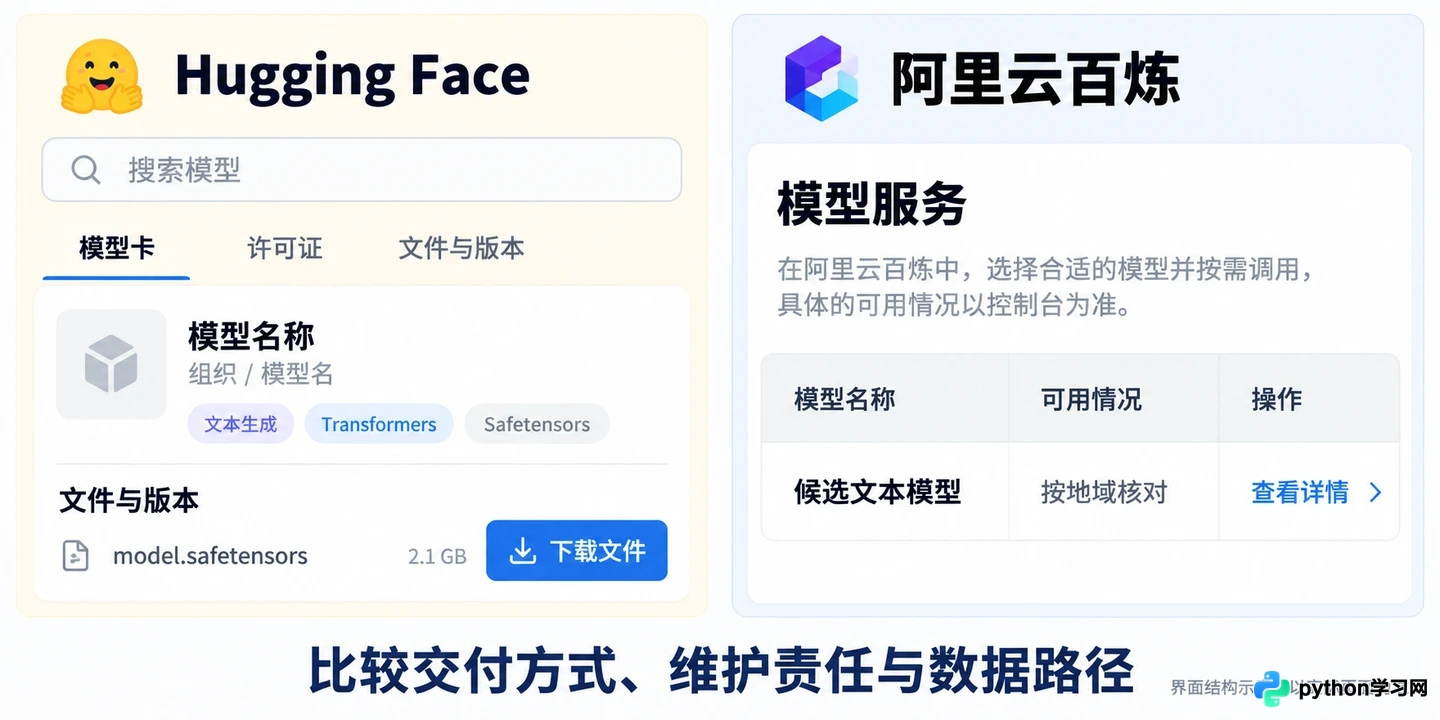
本文通过具体的中文信息抽取任务,对比 Hugging Face 与阿里云百炼在模型获取、在线调用、地域合规及成本结构上的差异。文章不虚构性能排名,而是提供一套可执行的选型核对流程,帮助开发者根据数据敏感性、维护能力和业务场景做出合理选择。
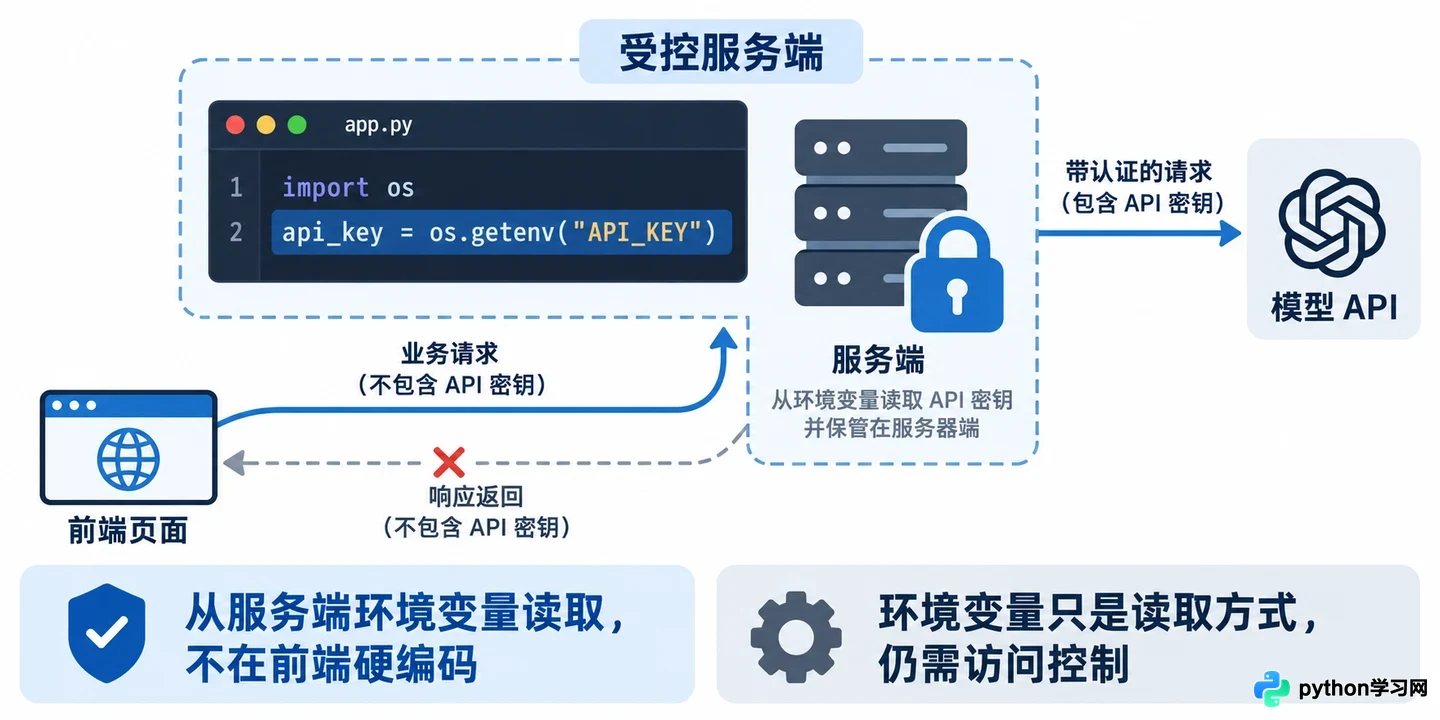
本文从实际业务接入场景出发,解析大模型平台的核心价值。区别于单纯的模型能力展示,文章重点阐述平台如何通过API管理、RAG知识库构建、差异化部署策略及评估监控体系,屏蔽底层算力复杂性,将演示级的聊天功能转化为可维护、可控的企业级服务。
本文详细讲解Python爬虫处理JavaScript动态渲染与加载内容的三种主流方法:抓包逆向直接请求真实接口、使用Playwright无头浏览器自动化以及源码内嵌数据提取,提供完整代码示例、选型对比与排查流程。
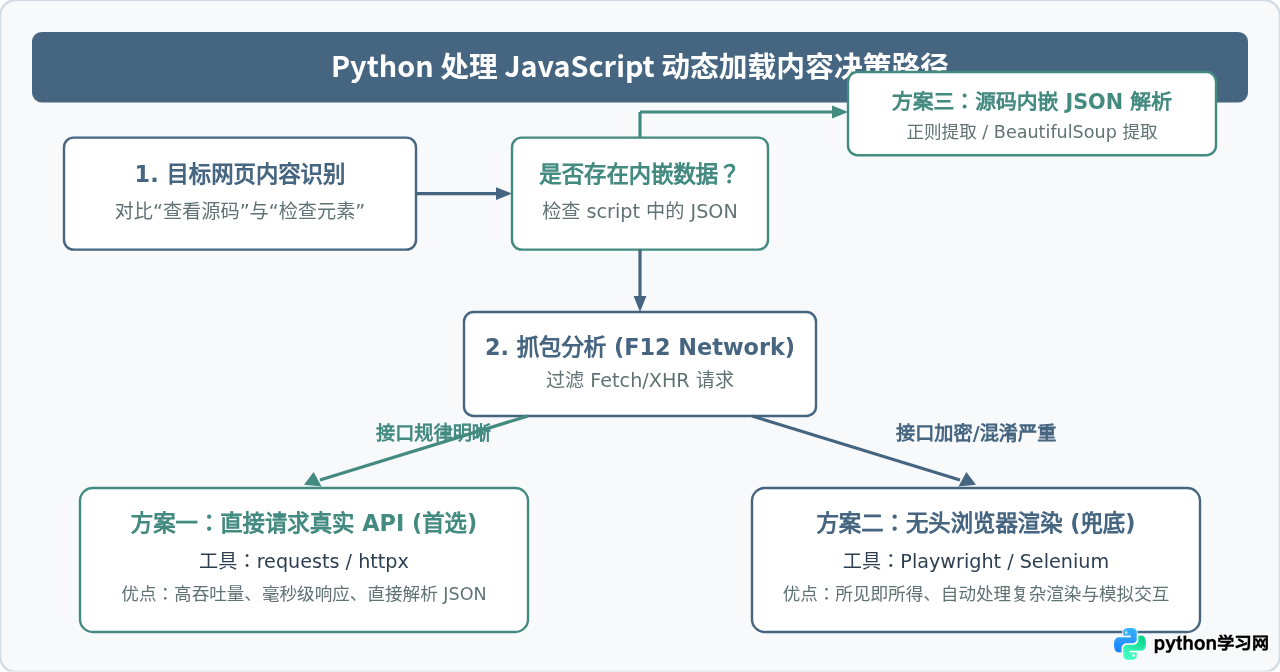
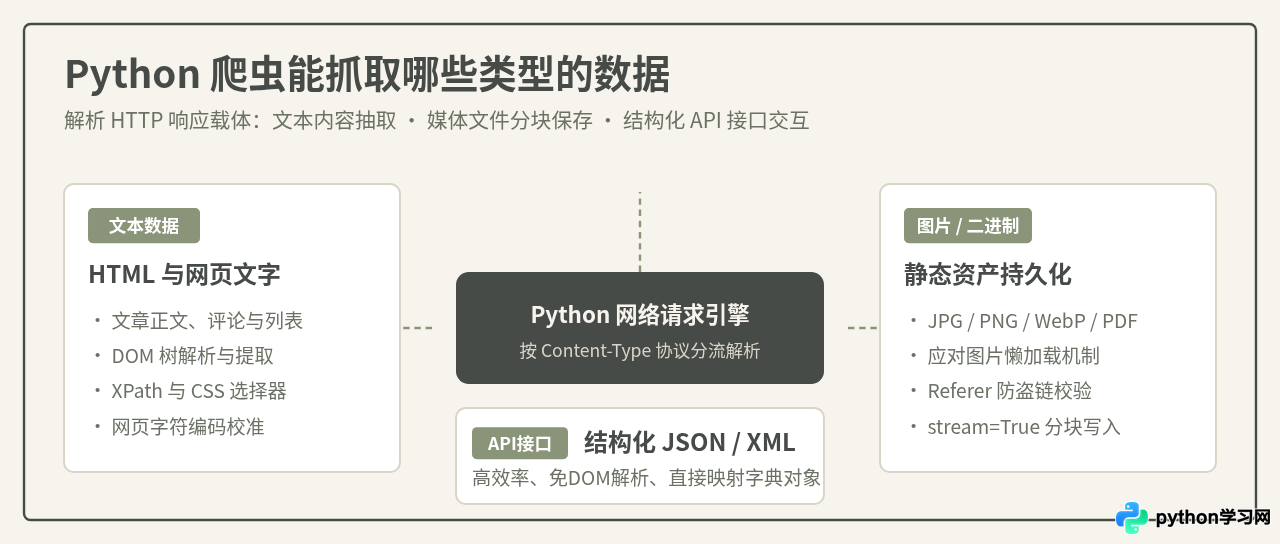
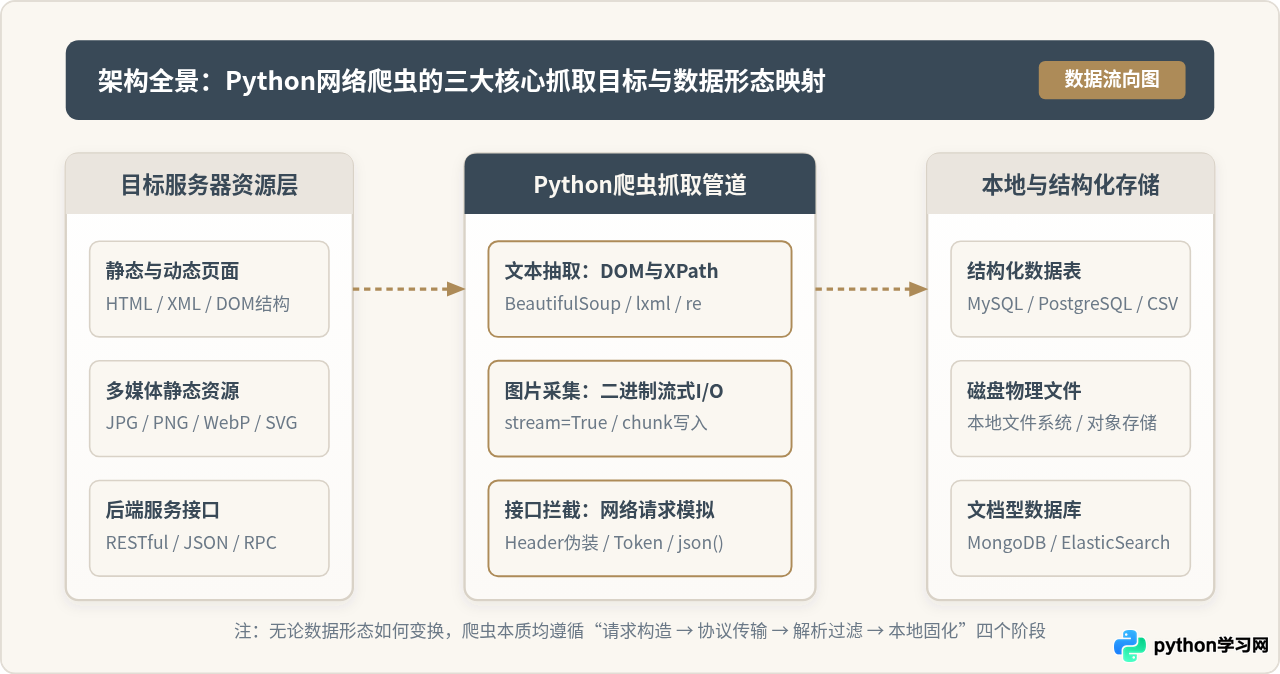
深入解析Python网络爬虫可以抓取的三大核心数据形态:HTML网页文本、图片及多媒体二进制流、后端API接口数据。详细讲解DOM解析、防盗链突破、接口逆向与选型决策。
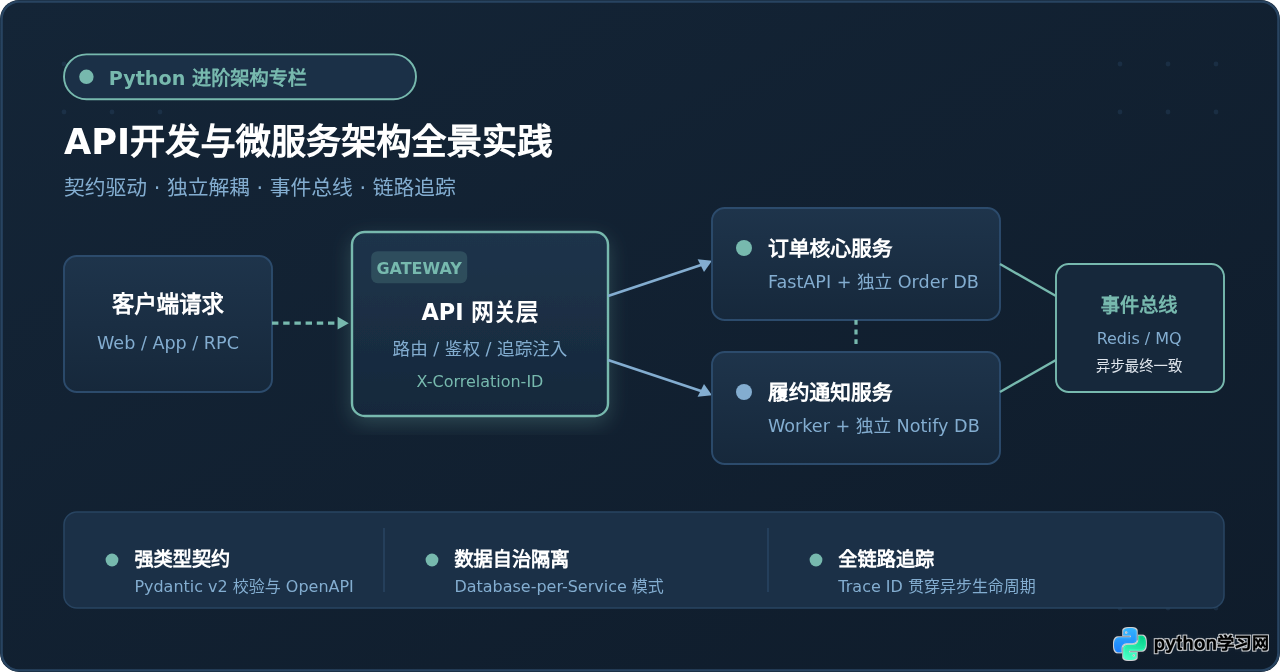
面向中级开发者的Python进阶实践指南:从单体应用向微服务架构演进,深入讲解FastAPI规范化接口开发、Database-per-Service数据隔离、基于发件箱模式的异步通信及分布式链路追踪实战。
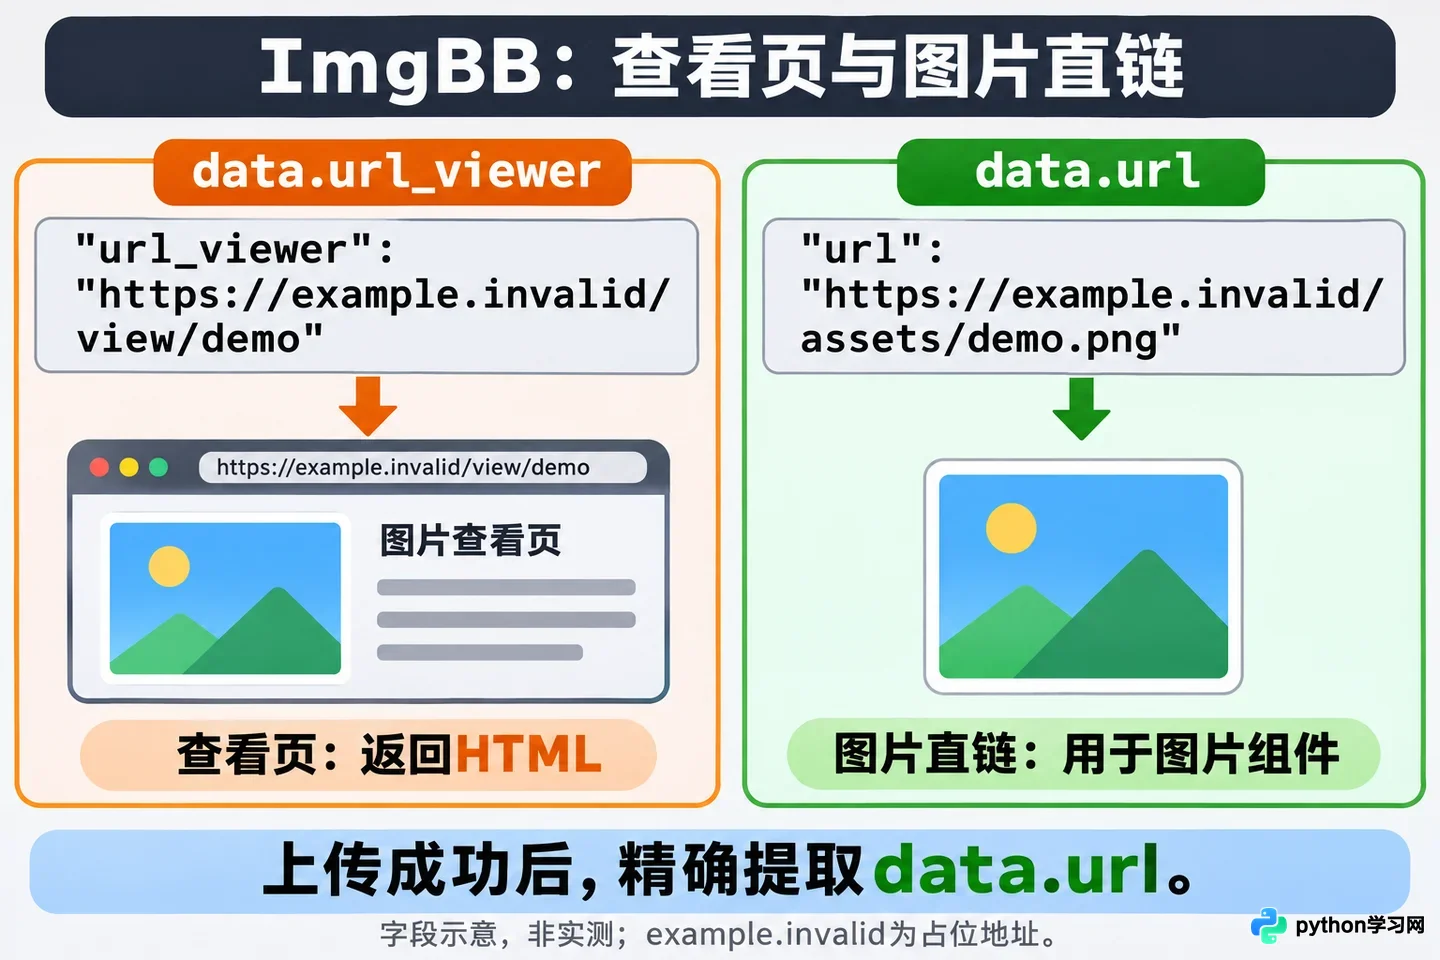
本文以 ImgBB 为例,解析自动化上传中“地址可用但图片不显示”的常见误区。通过 Python 标准库实现无依赖的文件读取、Base64 编码与 multipart 表单提交,重点区分查看页 URL 与直链 URL。代码包含完整的异常处理与字段校验,适用于将图片上传集成到脚本或后端服务的开发者。
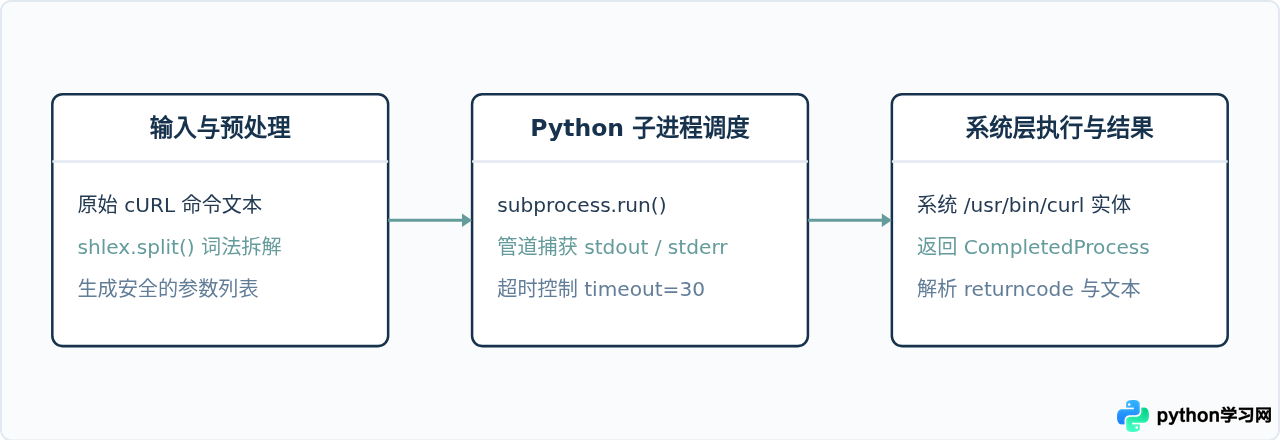
详细讲解在Python中使用内置subprocess模块直接调用和执行cURL命令的方法,涵盖参数拆分、输出捕获、错误排查及两者的最佳实践方案。
深入解析Python爬虫能抓取的三大核心数据载体:HTML文本、图片与二进制媒体资源,以及结构化API接口数据。包含工作原理、抓取流程、完整代码示例与常见避坑指南。