


Python 爬取 114 黄页商家电话与数据实战
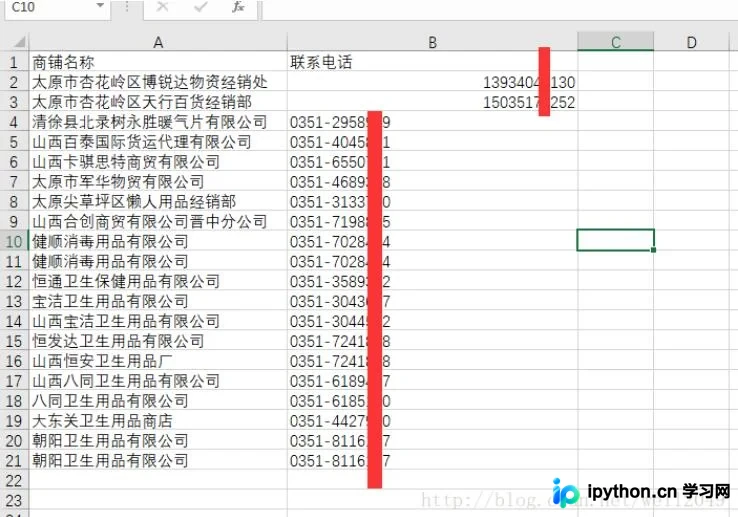
本文介绍如何使用 Python 爬取 114 黄页的商家联系电话及名称。通过 requests 获取页面源码,利用 BeautifulSoup 解析 HTML 结构,提取特定 div 下的列表数据。代码包含翻页逻辑、请求头设置及 CSV 文件写入,适合初学者学习基础爬虫开发。
2026-10-11
6
本文介绍如何使用 Python 爬取 114 黄页的商家联系电话及名称。通过 requests 获取页面源码,利用 BeautifulSoup 解析 HTML 结构,提取特定 div 下的列表数据。代码包含翻页逻辑、请求头设置及 CSV 文件写入,适合初学者学习基础爬虫开发。
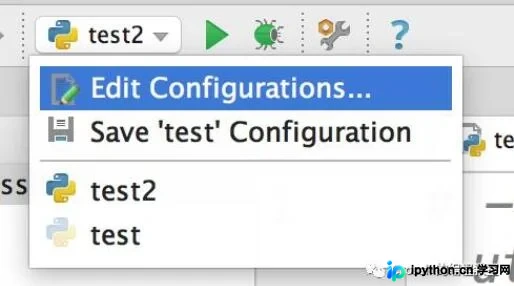
本文介绍在PyCharm调试Python程序时,如何动态执行其他语句。通过启用左下角的“Show Python Prompt”选项,开发者可以在调试中断时像Matlab一样输入变量并查看结果,或逐句输入执行语句,从而提升调试效率。
在使用Python编写递归函数时,若忘记在递归调用前添加return关键字,会导致外层调用意外返回None。本文通过对比错误与正确代码,说明如何通过补充返回值传递机制解决该问题,并简述其底层函数调用栈原理。
解决Python多进程间因内存隔离无法直接读取全局变量的问题。依托multiprocessing标准库提供的Value、Array、Queue及Manager模块,可安全传递数值、数组或字典列表等跨进程对象。本文对比Process独立进程与Pool进程池的运行差异,详解容器初始化步骤、参数配置方法及强制原地修改的核心规范,确保并发环境下数据同步准确生效。
本文解决PyCharm中右键菜单不显示“Run unittest”的问题。该问题通常由CLion创建的项目导入引起,导致项目配置不兼容。通过删除项目根目录下的.idea文件夹并重新导入项目,可恢复正常的单元测试运行功能。
传统HTTP轮询机制在获取实时数据时会导致服务器压力骤增与延迟累积。本文基于Python详解WebSocket与SSE两种主流推送方案,提供完整服务端与客户端代码实现,解析SSE协议字段规范、断线重连机制及性能优化策略,帮助开发者按需构建低开销的实时通信架构。
本文详解在 Python 中计算两个正整数最小公倍数的两种基础算法:辗转相除法与相减法。通过明确的操作顺序、完整的代码示例与状态判断标准,帮助开发者快速掌握基于最大公约数推导最小公倍数的编程逻辑,适用于算法练习与日常数据处理。
在Python开发中处理海量数据集时,一次性构建列表易导致内存瓶颈。利用yield关键字可将常规函数转换为生成器,实现状态记忆与惰性求值。本文详解其语法特征与迭代调用方式,通过实例展示如何按序产出数据以优化资源占用,并提供结果验证标准。
本文介绍如何使用Python将Excel文件中所有已存在的Sheet数据横向合并到一个新的Sheet中。通过xlrd读取源数据,利用xlwt和xlutils.copy创建并写入新Sheet,最后保存为新的Excel文件。
本文详解Python中使用PyYAML库读写YAML格式配置文件的标准流程。涵盖环境安装、安全加载规范、完整代码示例及常见报错排查,帮助开发者快速实现结构化数据的序列化与反序列化,避免因语法错误或加载方式不当引发的安全漏洞。
本文介绍如何使用Python脚本批量修改指定目录下的文件后缀名。通过os.listdir和os.rename函数实现自动化重命名,并针对Windows系统常见的Error 183(文件已存在)错误提供解决方案。脚本兼容Python3,支持自定义目录路径及随机文件名生成,适用于Windows和Linux环境。
本文详细介绍如何在 Selenium Python 中配置爬虫代理 IP。通过 ChromeOptions 添加 --proxy-server 参数,可解决反爬限制并提升抓取效率。文章涵盖代理类型选择、多线程注意事项及代码实现,帮助开发者高效部署爬虫。