


将Python Flask服务打包成Docker镜像并运行的完整指南
将 Python Flask Web 服务通过 Docker 容器化部署,可彻底消除环境差异并实现一键分发。本文基于阿里云镜像源加速配置多阶段构建流程,详细拆解从编写应用代码、定义依赖清单到编译镜像及端口映射的完整操作,帮助开发者快速掌握本地应用的标准化交付方法。
2026-10-10
6
将 Python Flask Web 服务通过 Docker 容器化部署,可彻底消除环境差异并实现一键分发。本文基于阿里云镜像源加速配置多阶段构建流程,详细拆解从编写应用代码、定义依赖清单到编译镜像及端口映射的完整操作,帮助开发者快速掌握本地应用的标准化交付方法。
本文介绍Python中列表去重的四种常用方法。前两种基于set和字典的方法执行效率高但不保证原始顺序;后两种通过循环遍历或排序索引的方式,在去重的同时严格保持元素首次出现的顺序。所有代码均基于Python3环境测试,适用于不同场景下的数据处理需求。
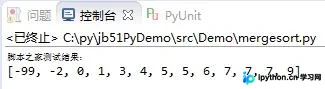
本文深入解析Python中的归并排序算法,提供完整的递归实现代码。归并排序的时间复杂度稳定为NlogN,且性能不受输入数据形态影响。文章包含详细的代码逻辑说明及测试用例,帮助开发者掌握这一高效排序算法的核心实现。
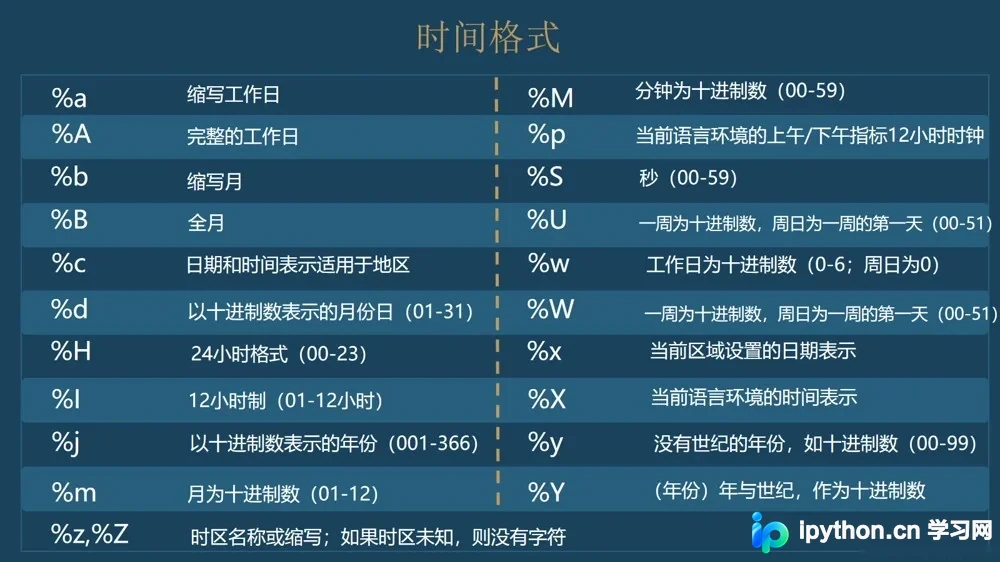
本文详细解析Python标准库datetime模块的核心对象date、time与datetime的使用方法。通过具体代码示例,演示如何创建日期时间对象、提取各项属性,并掌握利用strftime与strptime进行自定义格式转换的技巧,同时提供基于time模块的时间戳读写操作及注意事项,帮助开发者高效完成日常日期计算与时间格式化需求。
本文详解pandas中Timestamp类的两种核心创建方式:直接构造与to_datetime()转换。通过具体代码示例,展示如何从整数、datetime对象及字符串生成Timestamp,并验证其类型与输出格式,帮助开发者高效处理时间序列数据。
本文系统梳理 Python Pandas 库的结构化数据处理全流程,涵盖 DataFrame 构建、CSV 读写与探查、位置/标签/布尔索引、GroupBy 分组聚合、多表连接与透视表、时间序列解析,以及分块读取与类型转换等性能优化方案。结合可运行代码与预期输出对照,帮助开发者快速掌握数据清洗、转换与分析的核心操作。
本文探讨如何利用Python的package机制优化utils工具包的设计。通过合理配置__init__.py文件,将子模块导入至包根目录,调用者可直接通过命名空间访问工具类,无需知晓具体文件路径。文章从库作者视角出发,结合源码行数限制与内部模块隔离策略,提供了一套简洁高效的工具包组织方案。
本文详细解析NumPy中自动生成数组的多种方法。通过arange生成等差数列,linspace控制元素个数与边界包含,logspace创建等比数列。此外,介绍zeros、ones、empty、full及fromfunction等初始化函数的用法与区别,帮助开发者高效构建不同需求的数组。
本文详细介绍在Python环境中高效读写.xlsx文件格式的两种主流方案:openpyxl与pandas。涵盖基础数据写入、精确读取、大型文件性能优化(只读模式与分块处理)、单元格样式自定义以及多工作表管理等实用技巧,助您快速掌握自动化表格操作核心方法。
详细介绍Python中如何使用raise语句手动抛出异常,涵盖无参重抛、指定异常类及携带信息的三种核心语法。结合try-except-else-finally完整流程说明业务校验场景,并提供traceback模块精准定位报错位置的方法,帮助开发者规范程序容错机制。
本文详细解析 Python 中用于主动触发错误的 raise 语句,涵盖基础语法、内置异常调用、自定义异常类构造以及 raise from 异常链机制。通过输入校验、接口适配等实战场景演示如何替代传统错误码,并总结抛出具体的异常类与合理捕获的最佳实践,帮助开发者构建更健壮的代码结构。
详细演示 Windows、macOS 与 Linux 三大平台下彻底卸载 Python 的操作流程。涵盖主程序移除、残留目录清理、环境变量注销、注册表清理及缓存清除等关键步骤,附带风险提示与结果验证方法,确保干净重装避免路径冲突。