

Python使用国内源安装包后程序崩溃怎么排查

设想这样一个高频发生的开发场景:在一台新部署的 Linux 服务器或本地开发机上,为了加速第三方库下载,你按照常见文档配置了国内 PyPI 镜像源,并通过 pip install numpy torch opencv-python 顺利完成了安装。终端显示全部成功,然而刚运行脚本,控制台并未抛出常见的 Python 语法报错或异常堆栈,而是直接输出 Segmentation fault (core dumped)(段错误)或 Process finished with exit code 139,甚至进程直接静默退出。
这种“装包过程毫无报错、一执行程序就直接崩溃在底层 C/C++ 运行时”的现象,常常让人误以为是镜像源本身分发了被恶意篡改的损坏包。实际上,国内镜像源通常仅作为官方 PyPI 的同步副本,崩溃的深层原因往往在于 本地缓存污染与破损 Wheel、镜像源同步延时导致的多包版本依赖撕裂、平台 ABI/glibc/musl 架构误匹配 以及 多源混用触发的动态链接库冲突。本文将针对这一典型故障,给出清晰完整的诊断路径、分析工具与复原方案。
一、排查路径概览:从崩溃捕获到环境恢复
排查底层崩溃的核心原则是“由外到内、自底向上”:首先确定崩溃是原生 C 扩展故障还是 Python 解释器异常,其次核验包分发源的哈希一致性与缓存状态,接着检查底层共享库(.so 或 .dll)的 ABI 链接,最后在纯净虚拟环境中验证复现。
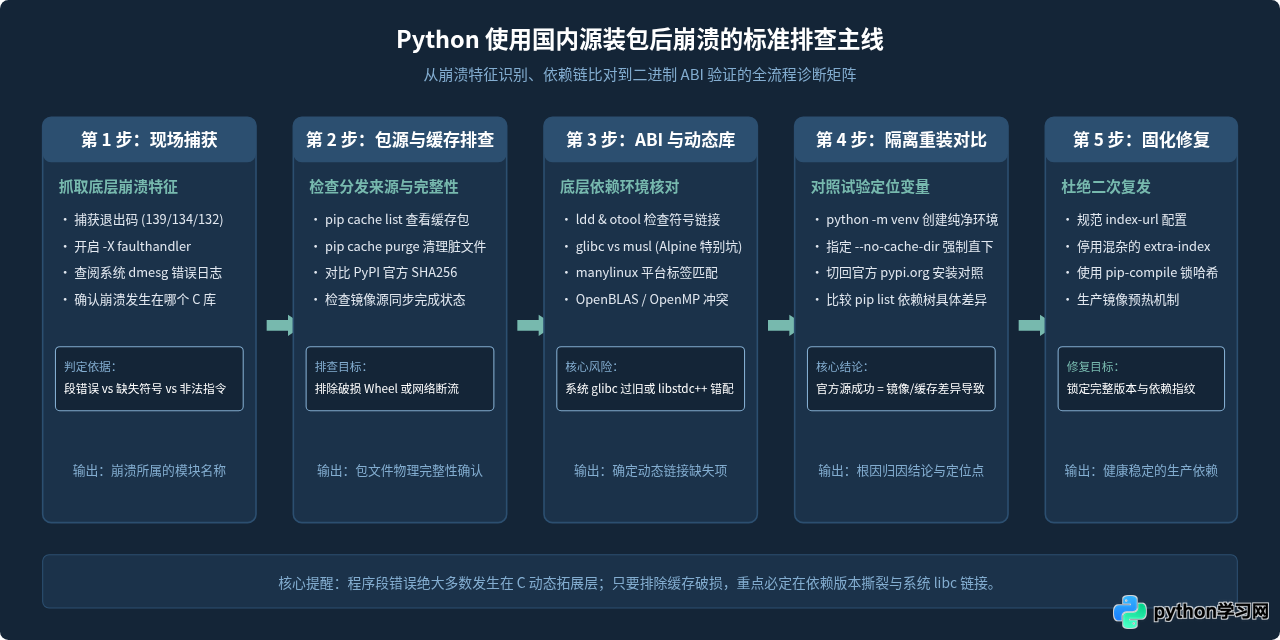
二、捕获现场:诊断退出码与底层崩溃原因
当 Python 进程突然中断时,普通的 try...except 代码块通常无法捕获原生层崩溃。此时必须借助操作系统或 Python 解释器内建的原生调试手段:
1. 开启 Python 解释器自带的 faulthandler
Python 3.3 及以上版本提供了 faulthandler 模块。在执行脚本时加入 -X faulthandler 参数,或者在代码入口处手动注册,可以在发生 SIGSEGV、SIGFPE、SIGABRT、SIGBUS 和 SIGILL 时,将 C 语言层面的崩溃调用栈打印到标准错误输出:
# 启动方式:在运行命令前增加 -X faulthandler 参数
python -X faulthandler run_app.py

# 或者在应用入口文件的最顶部写入:
import faulthandler
faulthandler.enable()
当崩溃发生时,终端将输出具体的调用帧。例如若看到 Fatal Python error: Segmentation fault 后面紧跟着 cv2/cv2.abi3.so 或 numpy/core/_multiarray_umath.cpython-310-x86_64-linux-gnu.so,就可以精准锁死是哪一个安装包触发了段错误。
2. 识别关键的退出码与信号含义
在 Linux/macOS 终端中,执行程序后紧接着运行 echo $? 可以获取最近一次命令的退出状态码:
- 139 (128 + 11 SIGSEGV):段错误。进程尝试访问未分配给它的内存空间,通常源于 C/C++ 扩展指针越界、空指针解引用或编译 ABI 内存布局错位。
- 134 (128 + 6 SIGABRT):异常终止。通常是底层的 C++ 库调用了
abort(),常见于底层断言失败或 C++ 未捕获异常(例如 PyTorch 底层检测到底层依赖版本不一致而主动终止)。 - 132 (128 + 4 SIGILL):非法指令。通常是因为安装的预编译 Wheel 开启了较新的 CPU 指令集(如 AVX2、AVX-512、FMA),而当前运行的 CPU(如老旧云服务器、轻量虚拟机)不支持该指令。
3. 从系统内核日志提取崩溃记录
# Linux 系统下检索最近的段错误事件
dmesg -T | grep -E "python|segfault"

# 示例输出:
# [Sun Oct 19 14:22:01 2026] python[12948]: segfault at 7f33a8220000 ip 00007f33b1940a12 sp 00007fffa481d860 error 4 in libopenblas.so.0[7f33b1800000+1b4000]
该日志直接表明:崩溃发生在 libopenblas.so.0 的内存访问越界,从而排除了纯 Python 脚本逻辑的问题。
三、根因剖析:为什么使用国内源容易引发崩溃?
国内镜像源(如清华大学开源镜像站、阿里云镜像站、中科大源、腾讯云源)本身是合规且高度可靠的 PyPI 代理节点。导致崩溃的并非“镜像源恶意注入”,而是由镜像同步特性、缓存机制与本地环境复合造成的。
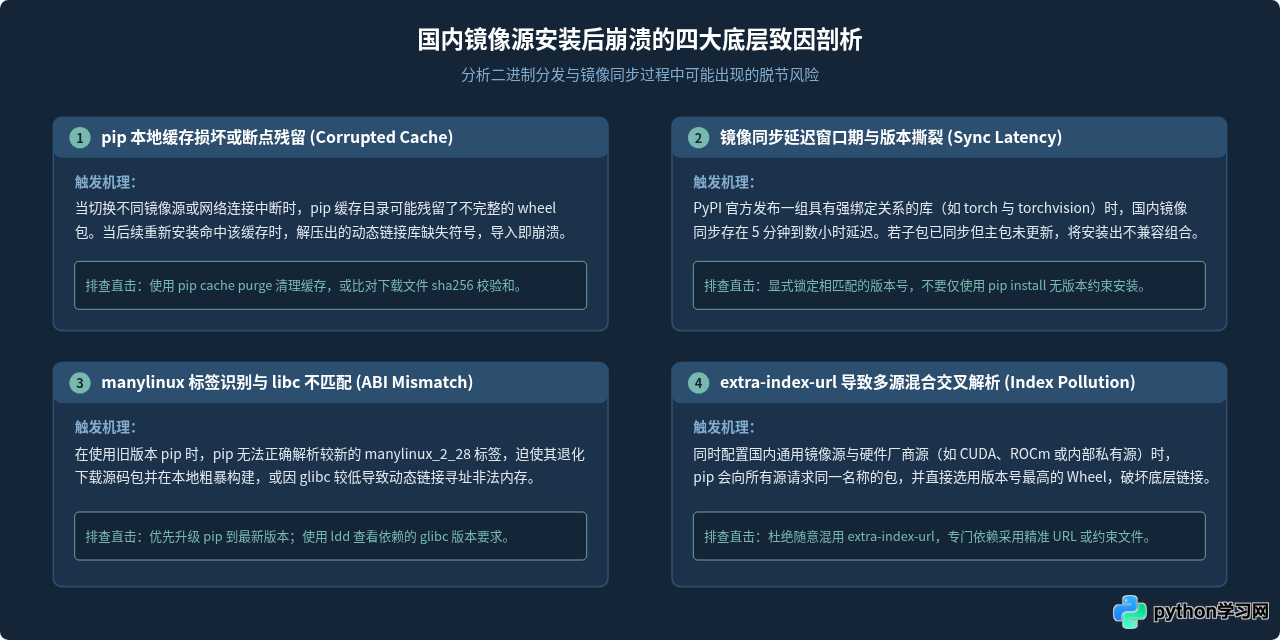
四、实操演练:逐步排查与取证命令
了解了根本原因后,请按以下 4 个具体实操步骤进行定位和验证:
步骤 1:排查 pip 缓存,剔除脏包与中断损坏
国内网络波动可能导致 Wheel 包在传输过程中被反向代理服务器(如 Nginx 缓存切片)缓存了不完整的文件,甚至在本地 ~/.cache/pip 中形成了脏包。
# 1. 查找当前本地针对该包的缓存记录
pip cache list | grep -i numpy

# 2. 完全清除 pip 本地缓存
pip cache purge

# 3. 强制不使用缓存重新安装
pip install --no-cache-dir --force-reinstall numpy
如果使用 --no-cache-dir 重新安装后程序恢复正常,说明问题是之前下载的 Wheel 物理损坏或断点续传污染所致。
步骤 2:比对已安装包的哈希值与官方 PyPI 元数据
为了确认国内源上的 Wheel 与 PyPI 官方是否完全一致,可直接计算已安装文件的实际哈希:
# 1. 查看目标包的物理存储位置
pip show -f numpy

# 2. 计算已安装核心扩展文件的 sha256(以 Linux 下的动态库为例)
sha256sum $(python -c "import numpy; print(numpy.__file__)")/../core/_multiarray_umath.*.so

# 3. 也可以直接下载 Wheel 包但不安装,验证其散列值
pip download --no-deps numpy -d /tmp/pkg_check
sha256sum /tmp/pkg_check/numpy-*.whl随后前往官方网站(https://pypi.org/project/numpy/#files),在对应的操作系统和 Python 版本条目下点击“View hashes”,对比 SHA256 字符串。如果完全相同,说明镜像源分发文件没有任何问题,崩溃属于本地环境兼容性问题;如果不一致,说明镜像源同步异常或本地网络存在代理劫持。
步骤 3:排查底层动态库链接(ldd / otool)
这是定位 C/C++ 崩溃最关键的系统级手段:
# Linux 平台下:检查已安装 .so 的动态链接状态
SO_PATH=$(python -c "import site; print(site.getsitepackages()[0])")/cv2/cv2.abi3.so
ldd $SO_PATH

# 关键检查点:
# 1. 是否存在 "not found" 的共享库(动态依赖缺失)
# 2. 是否链接了宿主机过旧的 libstdc++.so.6 或 libc.so.6
# 3. 查看系统支持的 glibc 版本列表:
strings /lib/x86_64-linux-gnu/libc.so.6 | grep GLIBC_python:3.10-alpine 搭配国内镜像源。Alpine 使用 musl libc 而非主流的 glibc。当镜像源缺乏针对 musllinux 的预编译 Wheel 时,pip 会尝试回退编译或误选错误的通用 wheel,进而引发导入时直接退出。对于包含复杂科学计算库(Numpy/Scipy/PyTorch)的项目,强烈建议选用基于 Debian 的 python:3.10-slim 基础镜像。
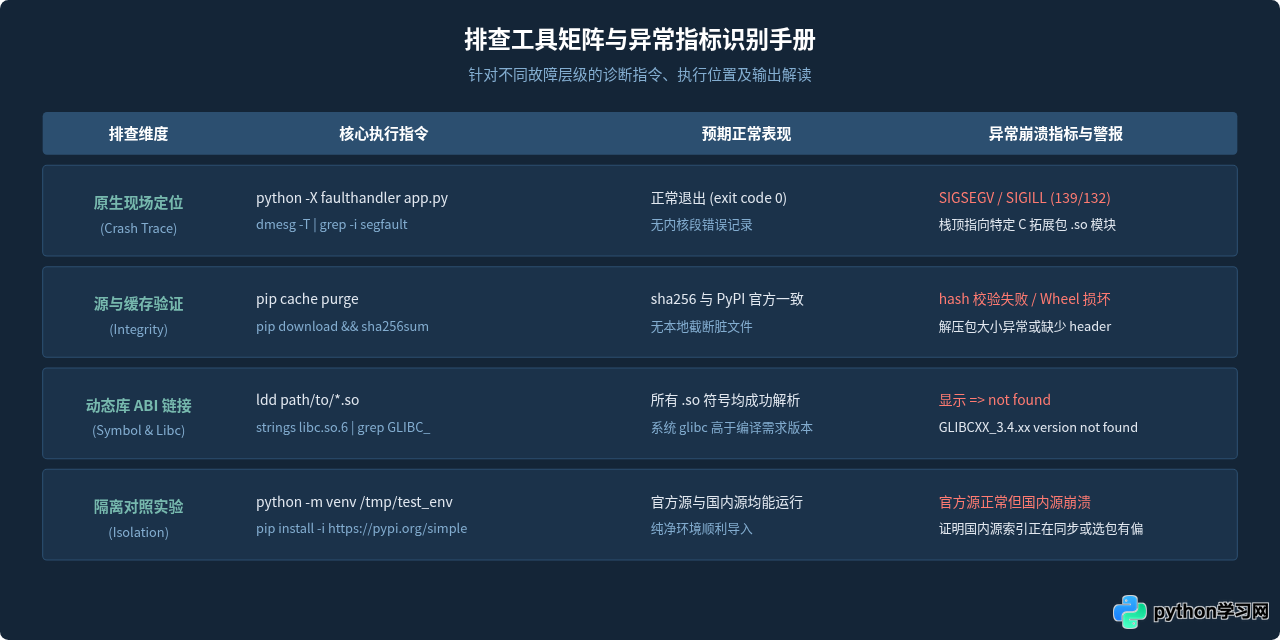
步骤 4:在纯净隔离环境中进行单变量对照
为了彻底排除宿主机全局环境已有依赖的污染,必须建立独立的最小复现沙箱:
# 1. 建立全新虚拟环境
python3 -m venv /tmp/clean_env
source /tmp/clean_env/bin/activate

# 2. 保证 pip 本身处于最新稳定版(旧版 pip 的解析器存在严重缺陷)
python -m pip install --upgrade pip

# 3. 直连官方源安装单包(不使用任何镜像与缓存)
pip install --no-cache-dir -i https://pypi.org/simple numpy

# 4. 运行简单导入验证
python -c "import numpy; print('Official Source Import OK:', numpy.__version__)"

# 5. 清理后,改换国内镜像源重新在隔离环境安装
pip uninstall -y numpy
pip install --no-cache-dir -i https://pypi.tuna.tsinghua.edu.cn/simple numpy
python -c "import numpy; print('Mirror Source Import OK:', numpy.__version__)"
如果在官方源下正常,而国内镜像源报错,对比两者安装时的终端输出,着重查看它们下载的具体 Wheel 文件名。例如:
- 官方源下载:
numpy-1.26.4-cp310-cp310-manylinux_2_17_x86_64.manylinux2014_x86_64.whl - 国内源下载:
numpy-1.26.4.tar.gz(说明镜像站上对应平台二进制包缺失或索引延时,导致 pip 退回源码编译,而本地缺少 gfortran/blas 依赖引发编译隐患)。
五、彻底解决与长期防范策略
通过排查确认具体诱因后,应按以下策略修复当前工程,并在团队和 CI/CD 流程中建立长效防范机制。
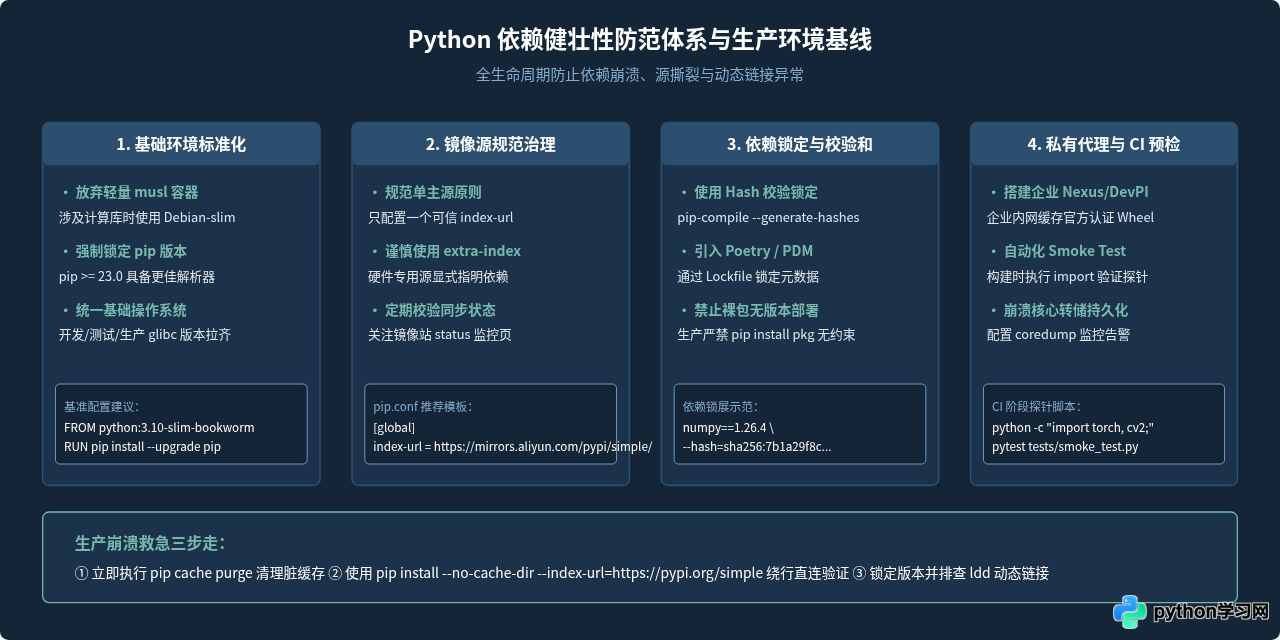
1. 依赖版本与文件哈希锁定(pip-tools)
在生产交付中,严禁仅依靠 requirements.txt 中书写 numpy>=1.20 这类松散版本约束。推荐使用 pip-tools 生成带 Hash 校验的完整锁文件:
# 1. 编写精确的 requirements.in
echo "numpy==1.26.4" > requirements.in
echo "torch==2.1.2" >> requirements.in

# 2. 编译并固化所有次级依赖及其 sha256 校验和
pip-compile --generate-hashes requirements.in

# 3. 安装时强制校验(若国内源提供的包与官方 Hash 不符,pip 会立即中止并报警,防止破损包进入系统)
pip install --require-hashes -r requirements.txt
2. 规范化配置 ~/.pip/pip.conf
配置国内源时,尽量避免在同一配置文件中杂糅多个 extra-index-url。建议只保留一个权威的全量镜像,并将超时时间适当放大:
[global]
index-url = https://pypi.tuna.tsinghua.edu.cn/simple
timeout = 60
trusted-host = pypi.tuna.tsinghua.edu.cn
no-cache-dir = false
如果确实需要使用特定硬件加速库(例如 PyTorch 的 CUDA 预编译轮子),建议在安装命令中单独指定来源,不要直接作为全局 extra-index-url:
# 明确指定专用源只负责特定包
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu118
3. 总结排查决策表
| 异常现象 | 初步判定原因 | 最快应对手段 |
|---|---|---|
Segmentation fault (core dumped) |
C扩展 ABI 错配、旧版本 Wheel 缓存损坏或 libstdc++ 不匹配 | pip cache purge 并开启 -X faulthandler 查看崩溃栈 |
Illegal instruction (core dumped) (132) |
预编译 Wheel 启用了当前 CPU 不支持的 AVX/AVX2 指令集 | 改用通用 manylinux1 轮子或下载源码本地编译适配当前 CPU |
ImportError: /lib64/libc.so.6: version 'GLIBC_2.28' not found |
运行操作系统 glibc 过低,Wheel 要求更新的 libc 环境 | 升级宿主系统基础镜像(如从 CentOS 7 迁移至 Rocky/Debian)或降低第三方库大版本 |
Fatal Python error: Aborted (134) |
C++ 底层断言触发,常见于主次包版本撕裂(如 Torch 与 CUDA 驱动) | 核对所有深度学习框架与加速库的版本兼容对照矩阵 |
总结而言,Python 使用国内镜像源后出现程序崩溃,绝大部分并非镜像网站故意篡改文件,而是本地残留断点脏缓存、镜像同步延迟导致的多库版本撕裂、或是宿主环境与预编译 Wheel 之间的 ABI 链接冲突。通过使用 faulthandler 捕获崩溃现场、清除本地缓存、比对 SHA256 哈希、核验 ldd 动态链接,并在隔离环境中进行单变量实验,可以迅速找出问题根源并恢复生产。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









