


PyCharm中导入Python包与模块的详细图文教程
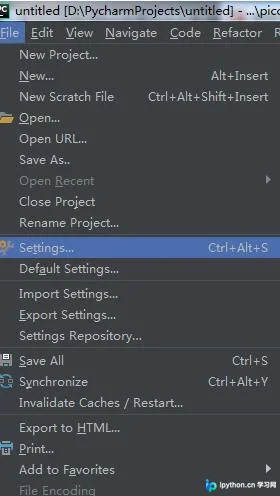
本文详细介绍在PyCharm中通过Project Interpreter安装Python包的完整流程。从点击File->Settings进入设置,到使用绿色加号添加新包,再到输入包名执行Install Package,最后提供查看已安装包的具体目录路径。适用于希望快速掌握PyCharm依赖管理的新手用户,确保模块正确安装并可在项目中调用。
2026-10-13
7
本文详细介绍在PyCharm中通过Project Interpreter安装Python包的完整流程。从点击File->Settings进入设置,到使用绿色加号添加新包,再到输入包名执行Install Package,最后提供查看已安装包的具体目录路径。适用于希望快速掌握PyCharm依赖管理的新手用户,确保模块正确安装并可在项目中调用。
本文介绍了一个基于Python的小型爬虫系统实现,涵盖URL管理、HTML下载、解析及输出模块。通过正则表达式提取链接,利用BeautifulSoup解析文本内容,并支持将抓取结果保存为HTML表格或TXT文件。代码展示了从初始URL到批量文档下载的全流程,适合Python初学者理解爬虫架构与核心逻辑。
本文详解Python中实现多条件数据筛选的三种方法:内建filter函数、pandas库及普通循环。通过词性标注示例对比代码实现与运行结果,指出filter与pandas在速度上更具优势,适合高效处理结构化数据。
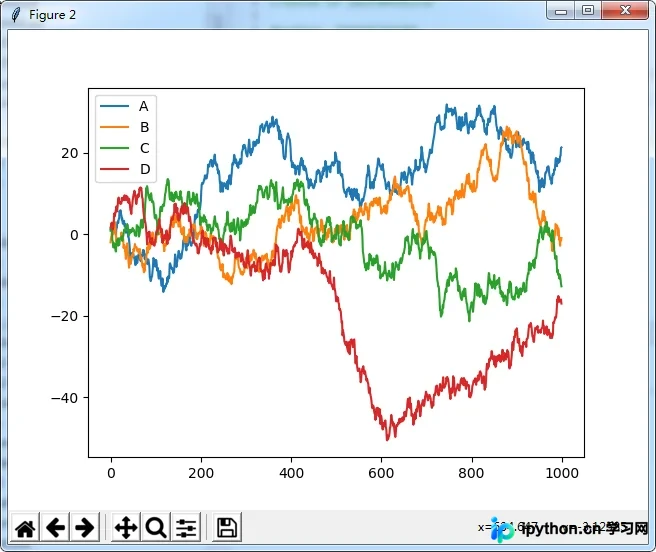
本文汇总了Python中利用matplotlib和pandas库进行数据可视化的经典示例。内容涵盖折线图、散点图、条形图、饼图、三维曲面图及矩阵散点图等多种图表类型的实现代码与运行效果,旨在帮助开发者快速掌握Python绘图技巧。
本文介绍如何在Python中使用Pandas库筛选数据集中特定列字符串长度大于20的记录。核心步骤包括将目标列强制转换为字符串类型,利用str.len()方法计算长度,并通过布尔索引过滤出满足条件的数据行。该方法简洁高效,适用于处理包含长文本字段的数据集。
在TensorFlow中直接打印Tensor对象仅能获取其形状和类型信息,无法看到具体数值。本文介绍了通过tf.Session或tf.InteractiveSession执行会话来提取Tensor实际值的方法,帮助开发者在模型调试时准确获取数据结果。
本文总结了TensorFlow在版本升级过程中常见的几类错误及其解决方案,包括rnn_cell属性缺失、concat参数顺序调整、pack函数替换为stack、softmax_cross_entropy_with_logits命名参数规范以及变量作用域复用问题。通过具体代码修正示例,帮助开发者快速定位并修复因API变更导致的程序异常,确保模型训练与部署的稳定性。
本文介绍如何利用Python的scipy库进行最小二乘法曲线拟合。通过定义包含四个参数的逻辑函数,生成含噪声的测试数据,并使用optimize.leastsq函数优化参数。文章包含完整的代码示例及可视化结果,展示如何对比真实值与估计值,适合需要处理非线性数据拟合的开发者参考。
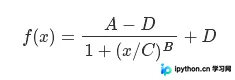
在 TensorFlow 中直接输出变量仅显示属性而非具体数值。本文介绍通过 InteractiveSession 结合 initializer.run() 初始化及 sess.run() 方法,正确获取并打印变量实际值的操作流程。
本文介绍如何利用Python的openpyxl库与正则表达式,解决Excel中非规律性数据的提取难题。通过定义日期和邮箱的正则模式,遍历指定单元格范围提取关键信息,并将结果写入新建的工作表中,最终实现自动化数据整理与保存,适用于需要统计特定时间段项目用时的场景。
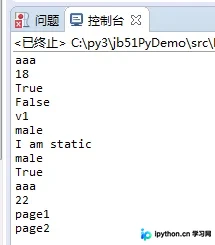
本文详解Python3.6中的反射操作,通过具体代码示例展示如何利用getattr、hasattr和setattr动态获取对象属性、检查成员存在性及添加成员。内容涵盖类实例与模块级别的反射应用,帮助开发者掌握Python动态特性在实际编程中的技巧。
本文系统介绍Python中常用的字符串处理方法,涵盖isalnum、isalpha、isdigit等判断方法,lower、upper、strip等转换与清理方法,以及replace、split、join、format等高级操作。通过具体示例解析各方法的参数与返回值,帮助开发者高效处理文本数据。