


Python DataFrame 大规模数据批量映射赋值实战
本文介绍在Python中利用Pandas库的map函数,对DataFrame中百万级大规模数据进行高效批量映射赋值的方法。通过定义状态字典,将原始状态码如HUMAN_REFUSE等映射为中文结果,并创建新列存储,实现数据清洗与转换。
2026-10-13
7
本文介绍在Python中利用Pandas库的map函数,对DataFrame中百万级大规模数据进行高效批量映射赋值的方法。通过定义状态字典,将原始状态码如HUMAN_REFUSE等映射为中文结果,并创建新列存储,实现数据清洗与转换。
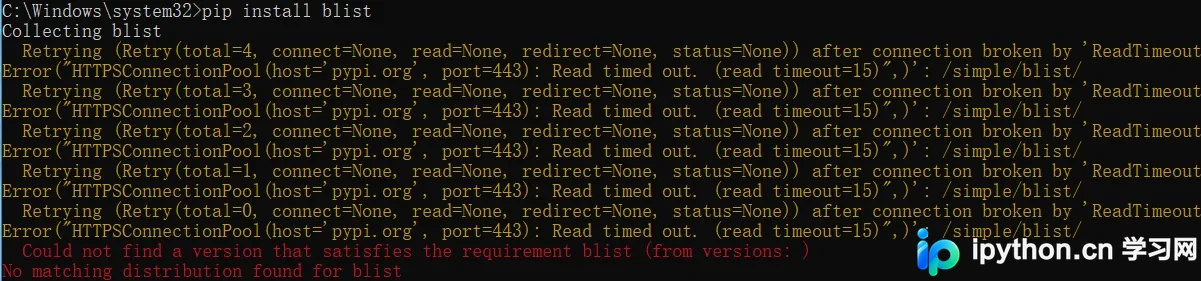
本文针对Python编程中常见的连接超时问题,重点分析了网络环境对依赖包安装的影响。通过调整pip软件源配置,如使用国内镜像或修改默认配置文件,可有效解决下载失败或连接超时错误。文章提供了临时指定源和永久修改配置的两种具体操作方案,帮助开发者快速恢复正常的包管理功能。
本文介绍在Ubuntu系统中使用pip安装mysql-python时,因缺少mysql_config命令导致EnvironmentError的解决方法。通过执行sudo apt-get install libmysqlclient-dev安装相关依赖即可修复该问题,适用于Debian系Linux发行版。
本文详细解析Python Pandas中数据选取的三种核心方法:.loc、.iloc和.ix。通过具体代码示例,阐述在已知列名与索引时使用.loc,通过整数位置切片时使用.iloc,以及混合使用标签与下标时使用.ix的适用场景。文章旨在帮助开发者清晰区分三者差异,提升数据处理的效率与准确性。
本文介绍如何在Anaconda3环境下快速创建并激活独立的Python 2.7虚拟开发环境。通过conda create命令指定版本,结合Linux/Mac的source activate或Windows的activate命令,实现环境隔离,确保库安装不影响主版本,适用于需要兼容旧版Python的项目开发。
本文详细介绍在Windows系统中使用Anaconda及Conda命令进行环境管理的方法。涵盖版本检查、库列表查看、虚拟环境的创建、激活、退出及删除操作,以及针对特定环境的包安装与移除命令,帮助用户高效管理Python开发环境。
本文深入解析Python中if-elif-else语句的使用,对比嵌套if与elif结构的优劣,强调条件判断的执行顺序对结果的影响,并通过分数判定案例演示如何编写清晰的条件逻辑。
本文介绍如何在 Python 脚本首尾添加代码以获取整体运行时间,适用于处理大文件或数据提取场景。通过 time.clock 计算差值输出耗时,并分享使用 %run 执行本地脚本的技巧,帮助开发者快速评估代码性能。
本文介绍如何使用Python检测指定路径下所有文件占用的存储空间,并获取磁盘剩余空间大小。通过os.walk遍历文件计算容量,利用os.statvfs或ctypes库实现跨平台(Windows与Unix/Linux)的磁盘空间查询,适用于系统监控与资源管理场景。
本文详细介绍Django框架中利用request对象获取浏览器发送参数的四种核心方式:URL正则匹配、查询字符串键值对、请求体数据及报文头信息。涵盖位置参数与命名参数的使用规范,以及GET、POST、JSON和文件上传的具体处理代码示例,帮助开发者全面掌握Web请求数据的解析技巧。
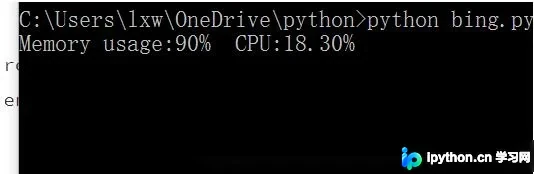
本文介绍利用Python的psutil库实时获取CPU和内存使用率的方法。通过安装psutil并调用virtual_memory及cpu_percent接口,可循环打印系统资源状态。代码包含完整实现逻辑,适用于需要轻量级系统监控脚本的场景。
本文详解Python中实现三元条件判断的三种方法,包括基础语法、and-or特性及列表索引技巧。同时介绍如何对字典按键或值进行排序,解析sorted与lambda的用法,并说明dict.get()的安全取值方式及Image与Ndarray互转代码。