Python实现递归检索指定内容文本文件
本文介绍在Windows环境下使用Python 2.7编写的脚本,用于递归检索指定目录下的文本文件。脚本通过命令行参数接收搜索路径和目标字符串,遍历所有文件并统计包含该字符串的行及位置,最终输出匹配结果。
2026-10-13
7
本文介绍在Windows环境下使用Python 2.7编写的脚本,用于递归检索指定目录下的文本文件。脚本通过命令行参数接收搜索路径和目标字符串,遍历所有文件并统计包含该字符串的行及位置,最终输出匹配结果。
本文详解Python写入CSV文件的两种核心方式。首先解析ASCII、GBK与UTF-8编码差异,解决中文写入乱码问题;其次演示标准库csv模块的逐行写入,并重点介绍利用pandas库进行高效批量数据写入的完整代码与安装步骤,适用于数据量较大的场景。
本文介绍使用Python计算两个日期之间所有节假日的方法。通过导入datetime和dateutil库,结合复活节、圣诞节等算法,自动统计指定年份内的假期天数及具体日期。文中提供了完整代码示例及运行结果,适用于需要批量处理假期数据的场景。
本文提供了使用Python和Shell语言读取文本文件内容的具体实现代码。Python部分演示了以只读模式打开文件、读取全部内容并关闭句柄的标准流程;Shell部分展示了通过while循环逐行读取指定路径文件内容的方法。代码简洁实用,适合需要快速处理文本数据的开发者参考。
本文介绍如何使用pandas.DataFrame.to_json方法将数据框转换为JSON格式。重点讲解orient参数,特别是records选项如何实现按行转换,生成[{column -> value}, ...]格式的列表,适用于前端展示等场景。
本文详细介绍利用Python进行文本预处理的完整流程,涵盖使用正则表达式去除多余空格、过滤非中文字符及BAS4编码解码。接着演示如何加载停用词表进行文本清洗,并深入讲解基于jieba库的TF-IDF与Textrank两种特征提取方法,帮助开发者构建高效的自然语言处理管道。
本文详解如何利用Python的open函数进行文件读写,结合os模块遍历目录,并通过正则表达式re模块从多个文本文件中精准提取指定数据。文章提供了完整的代码示例,演示如何去除换行符、匹配模式并将结果写入新文件,适合需要批量处理文本数据的开发者参考。
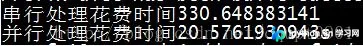
本文介绍利用Python multiprocessing模块的Pool进程池,结合jieba库对海量文本进行高效关键词提取的方法。通过对比单进程与多进程处理581行、7MB语料的耗时,验证了多进程异步处理的性能优势,并指出移除模拟延迟可显著缩短运行时间,为大规模文本分析提供实用参考。
本文详解Python中读写JSON文件的方法。首先区分单行JSON与整体JSON两种格式,接着通过json.load读取数据并转换为列表,示例展示如何提取字段值。随后演示使用json.dumps将列表写入JSON文件,并推荐实用在线工具辅助开发。
本文介绍了一个基于Python3的MySQL数据库操作封装类。重点解析了将数据库配置变量置于类外部以优化IO性能的设计思路,以及初始化时预创建游标以提升效率的做法。文章提供了完整的代码示例及注意事项,帮助开发者构建更健壮的数据库交互模块。
本文介绍如何使用Python的urllib2模块实现简单的网页内容抓取。通过普通抓取和带参数的GET请求两个实例,演示如何构建Request对象、发送请求、处理状态码及读取网页内容,适用于Python初学者学习网络请求基础。
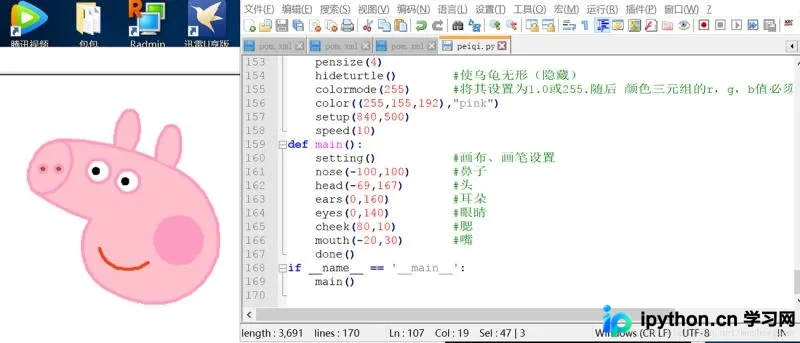
本文介绍利用Python内置Turtle模块绘制小猪佩奇的方法。通过设置画板、画笔颜色及粗细,按顺序绘制鼻子、头部、耳朵等部位,实现卡通形象。Turtle模块基于Tkinter,适合初学者理解代码逻辑与绘图指令。