


pandas replace函数全解析:Series与DataFrame值替换实战
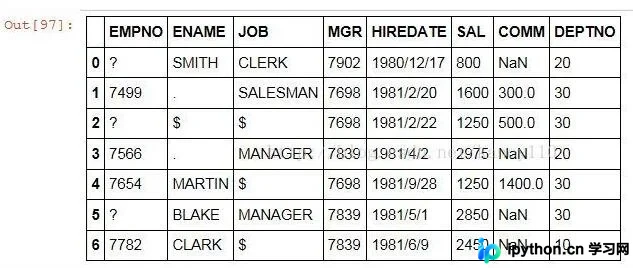
本文详细解析pandas中replace函数的核心用法,涵盖Series与DataFrame对象的单值、多值及正则表达式替换。通过具体代码示例,展示如何利用字典映射、列表替换以及pad/ffill/bfill等方法进行缺失值填充,并介绍limit参数对填充次数的控制,帮助开发者高效完成数据清洗任务。
2026-10-13
6
本文详细解析pandas中replace函数的核心用法,涵盖Series与DataFrame对象的单值、多值及正则表达式替换。通过具体代码示例,展示如何利用字典映射、列表替换以及pad/ffill/bfill等方法进行缺失值填充,并介绍limit参数对填充次数的控制,帮助开发者高效完成数据清洗任务。
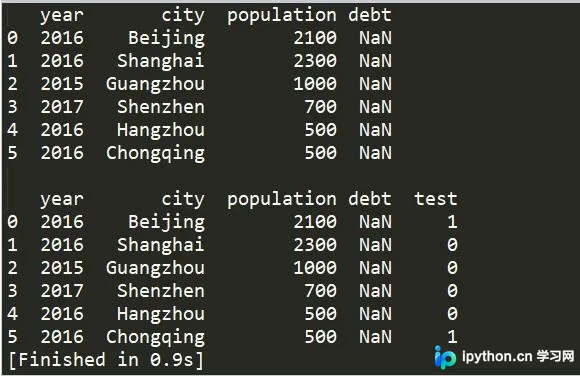
本文介绍如何利用pandas DataFrame的apply函数,基于多列条件生成新列。通过设置axis=1逐行处理,结合自定义函数或lambda表达式,实现如城市名含特定字符且年份匹配时的赋值逻辑。同时对比Series的apply用法,提供完整代码示例与运行结果参考。
本文详细解析PyCharm无法调用pip安装包的常见原因,即未正确设置Python解释器。通过指导用户在File->Settings中指定正确的python.exe路径,并建议在Terminal中验证版本,可有效解决包引用问题。若工程混乱导致解释器识别错误,建议重建工程以确保环境纯净。
本文介绍如何在pandas中利用str.split方法,以特定字符(如'#'和';')为分隔符对数据进行切割与提取。通过示例代码展示如何从包含分隔符的列中提取多段数据,并重新构建DataFrame以完成数据清洗与整理。

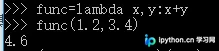
本文深入解析Python中的匿名函数,重点介绍lambda语法的定义方式与使用场景。通过具体示例说明如何创建无标识符的函数对象,并演示直接调用与赋值调用的两种用法,帮助开发者掌握简洁高效的函数编写技巧。
本文详细解析 Python3 Selenium 中切换浏览器窗口的两种常用方法。第一种通过获取 window_handles 列表并直接切换至最新句柄,代码简洁且性能较高;第二种通过遍历所有窗口句柄并排除当前窗口来定位新窗口,逻辑直观且易于理解。文章包含具体代码示例及对比分析,帮助开发者根据实际需求选择合适方案。
本文深入讲解PHP面向对象编程的高级特性,涵盖静态成员(static)的定义与调用规则,Final关键字防止类继承与方法重写的机制,以及接口(interface)的定义、实现与多重继承特性。通过具体代码示例阐明self、parent、static在访问控制中的作用及数据访问规范。
本文详细介绍在Mac系统中安装与配置virtualenvwrapper的方法,涵盖从pip3安装到bash/zsh环境变量的设置。通过实例演示如何创建、激活及管理Python虚拟环境,并深入解析利用postactivate钩子自动执行pip安装与环境变量设置的技巧,帮助开发者提升多项目开发的效率与环境隔离安全性。
本文深入解析Python中跳台阶、变态跳台阶及矩形覆盖三大经典算法问题。通过推导斐波那契数列递推公式,对比分析不同场景下的递归与迭代实现,提供高效代码示例,帮助开发者掌握动态规划思想及边界条件处理。
本文总结Python中几项实用但常被忽视的基础技巧。涵盖利用元组简化startswith/endswith判断、通过start参数控制enumerate索引、使用slice对象命名切片提升代码可读性、在with语句中同时管理多个资源,以及for/while/try语句中else子句的正确使用场景与异常处理规范。
本文介绍如何使用Python的lxml模块提取HTML页面中所有叶子节点的XPath路径。针对原始解析结果包含非叶子节点的问题,提出基于路径包含关系的过滤算法:若当前路径被下一路径包含则跳过,否则视为叶子节点。通过实际代码演示了从原始XPath列表到纯净叶子节点XPath列表的转换过程,并提供了相关XML处理工具推荐。
本文通过Python代码演示了如何计算两个数的最大公约数和最小公倍数。内容涵盖非递归与递归两种算法实现,并对比了Python内置库函数的用法。文中提供了完整的代码示例及运行结果分析,帮助开发者理解算法逻辑并应用于实际开发中。