Python pycurl模块核心方法详解与参数配置指南
本文深入解析Python中基于C语言libcurl实现的pycurl模块。详细阐述Curl对象的创建、连接超时、重定向及User-Agent等关键setopt参数的配置方法,并列举getinfo方法获取HTTP状态码、传输耗时及下载速度等性能指标的具体用法,为高性能网络请求处理提供实用参考。
2026-10-13
8
本文深入解析Python中基于C语言libcurl实现的pycurl模块。详细阐述Curl对象的创建、连接超时、重定向及User-Agent等关键setopt参数的配置方法,并列举getinfo方法获取HTTP状态码、传输耗时及下载速度等性能指标的具体用法,为高性能网络请求处理提供实用参考。
本文整理了Python字典高效使用的8个技巧,涵盖检查键存在、安全获取值、设置默认值、初始化字典、列表转字典、模拟Switch语句、迭代优化及推导式应用。通过对比Python2与Python3的差异,帮助开发者编写更简洁、高性能的Pythonic代码。
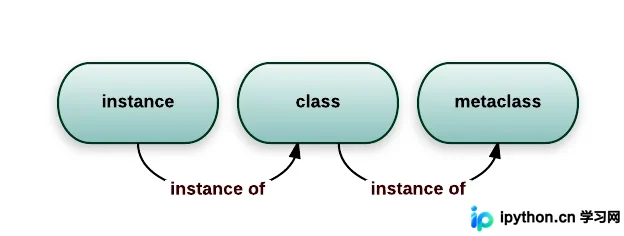
本文深入解析 Python 元类机制,阐述“一切皆对象”的核心思想。通过区分实例对象与类对象,揭示所有类均由 type 创建的底层逻辑。文章详细演示了如何使用 type 元类动态创建类,并对比 class 关键字的定义方式,帮助开发者理解 Python 中类的构造本质。
本文详细介绍如何在 VS Code 中配置 Python 开发环境并运行第一个程序。涵盖软件下载安装、项目结构创建、Python 插件安装、源代码编写以及 task.json 任务配置。针对旧版与新版 VS Code 分别提供 task.json 配置示例,并附带语言切换为英文的方法,帮助开发者快速上手。
本文介绍了在Python中使用Pandas库创建空DataFrame的两种常见方法。通过指定列名初始化一个无数据的DataFrame,以及直接创建完全空的DataFrame对象。文章提供了具体的代码示例和输出结果,帮助开发者快速掌握数据结构的初始化技巧,适用于需要预先定义数据结构或进行数据处理的场景。
在使用Pandas处理CSV文件时,Excel中的空白单元格可能被解析为空字符串而非NaN,导致dropna()或fillna()失效。本文介绍通过正则替换空字符串为NULL,并在read_csv中指定na_values参数将其识别为缺失值,从而正确执行缺失值处理的操作流程。
本文介绍在pandas中处理数据时,如何将现有Dataframe的指定行高效添加至新Dataframe。对比了使用append方法的低效与潜在问题,推荐先构建包含字典的列表再转换为Dataframe的方法,以解决速度慢及数据类型异常的问题,并提供完整代码示例。
本文详细介绍Django中实现文件下载的三种主要方式:HttpResponse、StreamingHttpResponse和FileResponse。通过对比源码与适用场景,指出FileResponse作为StreamingHttpResponse子类,利用迭代器处理大文件流传输的优势,并推荐在实际项目中优先使用FileResponse以获得更好的性能与内存管理。
本文介绍利用Python的threading.Timer模块实现轻量级定时数据库更新的方法。通过计算时间差创建非阻塞线程执行更新操作,避免了传统多进程方案的资源消耗。重点解析了异步环境下必须手动调用commit()确保数据生效的关键细节,并指出了服务重启导致线程丢失的局限性及持久化解决方案。
本文介绍在Python数据挖掘中修改DataFrame列名的两种方法。方法一通过直接赋值columns属性,需完整列出所有列名否则报错;方法二使用rename函数配合inplace参数,可灵活修改指定列名而不影响其他列,推荐用于部分列重命名场景。
本文详细解析pandas中shift和diff函数的功能与区别。shift用于数据框索引或数据的滚动偏移,支持时间频率设置;diff计算离散差分。通过代码示例展示两者在时间索引与非时间索引下的表现,并揭示diff本质上是当前值与shift后值的差,帮助开发者准确使用这两个关键数据处理工具。
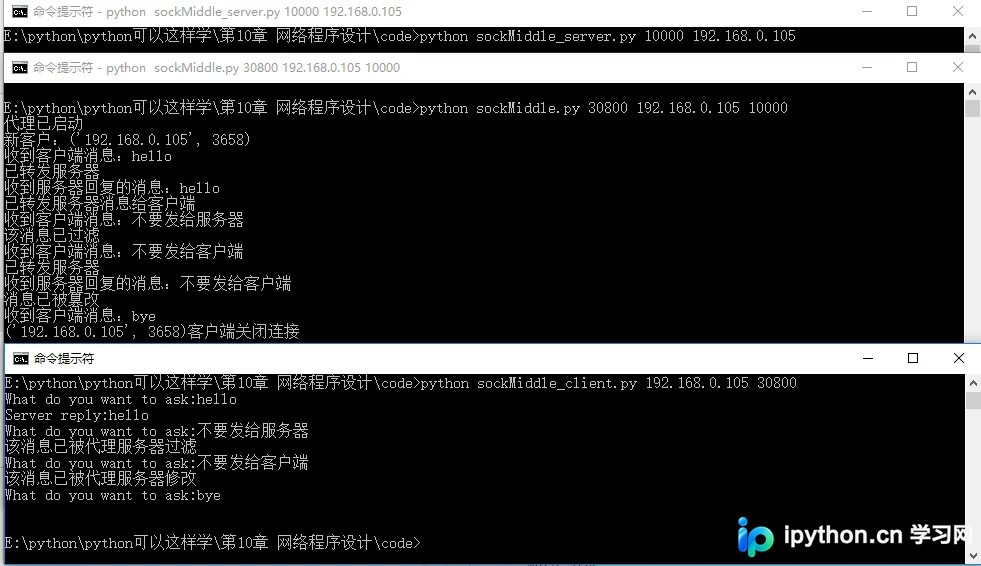
本文通过Python代码演示了简易代理服务器的实现,涵盖服务端、代理层及客户端的完整交互流程。示例展示了代理服务器如何记录并修改通信内容,包括消息过滤与篡改功能。文章指出此类机制可能侵犯用户隐私,建议涉及资金交易时谨慎使用代理。