


Python使用itertools模块实现排列与组合计算
本文介绍如何利用Python标准库itertools模块高效解决列表元素的排列与组合问题。通过test_func1、test_func11、test_func2及test_func22四个函数,分别演示了元素不重复排列、元素可重复排列、元素不重复组合及元素可重复组合的具体实现与结果统计,适用于需要快速生成全排列或组合场景的开发需求。
2026-10-13
7
本文介绍如何利用Python标准库itertools模块高效解决列表元素的排列与组合问题。通过test_func1、test_func11、test_func2及test_func22四个函数,分别演示了元素不重复排列、元素可重复排列、元素不重复组合及元素可重复组合的具体实现与结果统计,适用于需要快速生成全排列或组合场景的开发需求。
本文详解Python读取.docx文件正文信息的原理。.docx本质是包含XML的ZIP压缩包,正文存储于word/document.xml中。通过Python解压文件并解析该XML,可提取文本内容。文中提供基于ZipFile和BeautifulSoup的完整代码示例,展示如何遍历并打印文档正文。
本文详细介绍在 CentOS 7 系统中编译安装 Python 3.5.5 及 Scrapy 框架的完整步骤。内容涵盖开发工具依赖安装、Python 源码编译、软链接配置以及 Scrapy 的安装与验证,确保在不破坏系统原有 Python 2.7 的前提下完成环境搭建。
本文分享一个基于Python的简易商城购物车代码实例。程序通过列表存储商品清单,接收用户输入的工资金额,支持循环选购商品并实时计算余额。代码包含输入合法性校验、余额不足提示及退出打印购物清单功能,并演示了终端彩色输出用法,适合Python初学者参考学习。
本文详解Python内置函数callable()的用法,用于判断对象是否可调用。通过示例说明函数、类、实现__call__方法的实例及lambda表达式均为可调用对象,而整数、字符串等基础类型不可调用,帮助开发者理解Python对象调用机制。
本文介绍如何使用Python编写脚本实现文件中指定子串的替换功能。通过读取源文件并写入新文件,支持可选的备份参数,确保操作安全。文章提供了完整的代码示例及执行过程解析,适用于需要批量修改文本内容的场景。
本文介绍Python中读取目录下所有文件夹与文件路径的两种方法。通过os.walk直接遍历,或利用递归函数手动处理。重点解析路径拼接、编码转换及系统保留文件夹的处理,对比两种方式的优劣与适用场景。
本文详细介绍如何在Python环境中安装psutil库,涵盖环境确认、pip版本检查、具体安装命令及卸载方法。psutil是一个跨平台库,用于获取进程和系统利用率信息,适用于系统监控、分析和管理场景。
本文深入解析Python中locals()与globals()两个内置函数的工作机制。通过名字空间(Name Space)概念,阐述局部、全局及内置变量的查找顺序。重点对比两者行为差异:locals()返回局部变量字典的副本,修改无效;而globals()直接返回全局变量字典,修改会实时影响全局变量。结合代码实例说明import与from...import对名字空间的影响,帮助开发者准确掌握变量作用域管理。
本文详细介绍Python中readlines()方法的使用。该方法用于读取文件直至结束符EOF,返回包含所有行的列表,便于通过for循环处理。文章提供了Python 2与Python 3环境下的具体代码实例,演示如何打开文件、逐行读取并关闭文件,帮助开发者掌握文件内容的高效读取技巧。
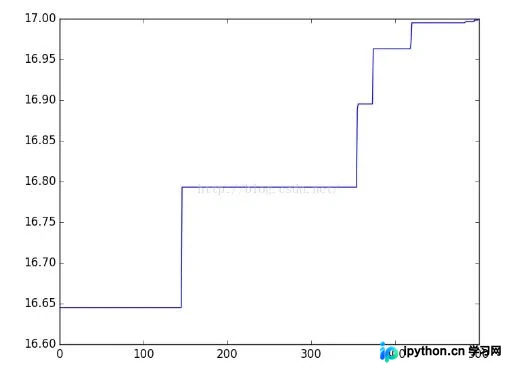
本文详细介绍如何使用Python实现基础遗传算法,以y = 10 * sin(5x) + 7 * cos(4x)的最大值求解为例。内容涵盖种群初始化、二进制编码解码、适应度评估、轮盘赌选择、交叉变异及结果可视化。通过完整代码解析,展示遗传算法在数值优化中的应用流程与核心逻辑。
本文介绍利用Python内置filter函数和切片操作实现筛选法求素数的方法。通过遍历候选数字并过滤非素数,演示了算法逻辑。尽管效率有限,但代码简洁,适合学习filter与切片用法。