Python实现文字PDF转图片PDF:无需保存中间图片的高效方案
本文介绍如何使用Python将文字版PDF转换为图片版PDF,解决WPS等软件对图片PDF转换收费的问题。通过PyMuPDF库,直接在内存中处理页面渲染与PDF重组,无需保存中间图片文件,实现高效、安全的批量转换。
2026-10-15
21
本文介绍如何使用Python将文字版PDF转换为图片版PDF,解决WPS等软件对图片PDF转换收费的问题。通过PyMuPDF库,直接在内存中处理页面渲染与PDF重组,无需保存中间图片文件,实现高效、安全的批量转换。
本文介绍如何使用Python语言结合requests和json库,从QQ音乐网站抓取指定歌手的歌曲清单。通过解析网页请求头、分析API参数及编写自动化脚本,实现以CSV格式输出歌曲数据。文章包含详细操作步骤、完整代码示例及运行结果分析,帮助开发者掌握基础的网络爬虫技能。
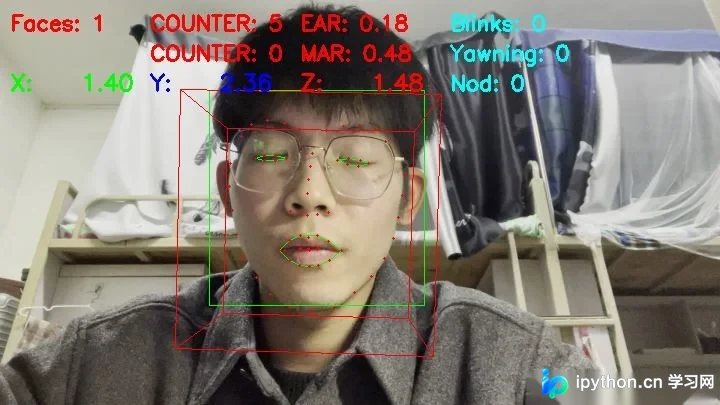
本文介绍基于Python的疲劳驾驶检测系统实现,重点解析困倦与低头行为的识别算法。通过头部姿态估计(solvePnP)与眼睛/嘴巴长宽比(EAR/MAR)计算,结合OpenCV实现实时监测。代码包含关键点提取、姿态求解及重投影误差验证,适用于驾驶安全监控场景,提供完整功能实现参考。
本文深入解析 Python 中 lambda 表达式的语法结构、与普通函数的区别及其在 map、filter 和 reduce 等高阶函数中的应用。文章指出,虽然 lambda 适用于简单逻辑,但复杂场景下建议使用命名辅助函数以提高代码可读性和调试效率。
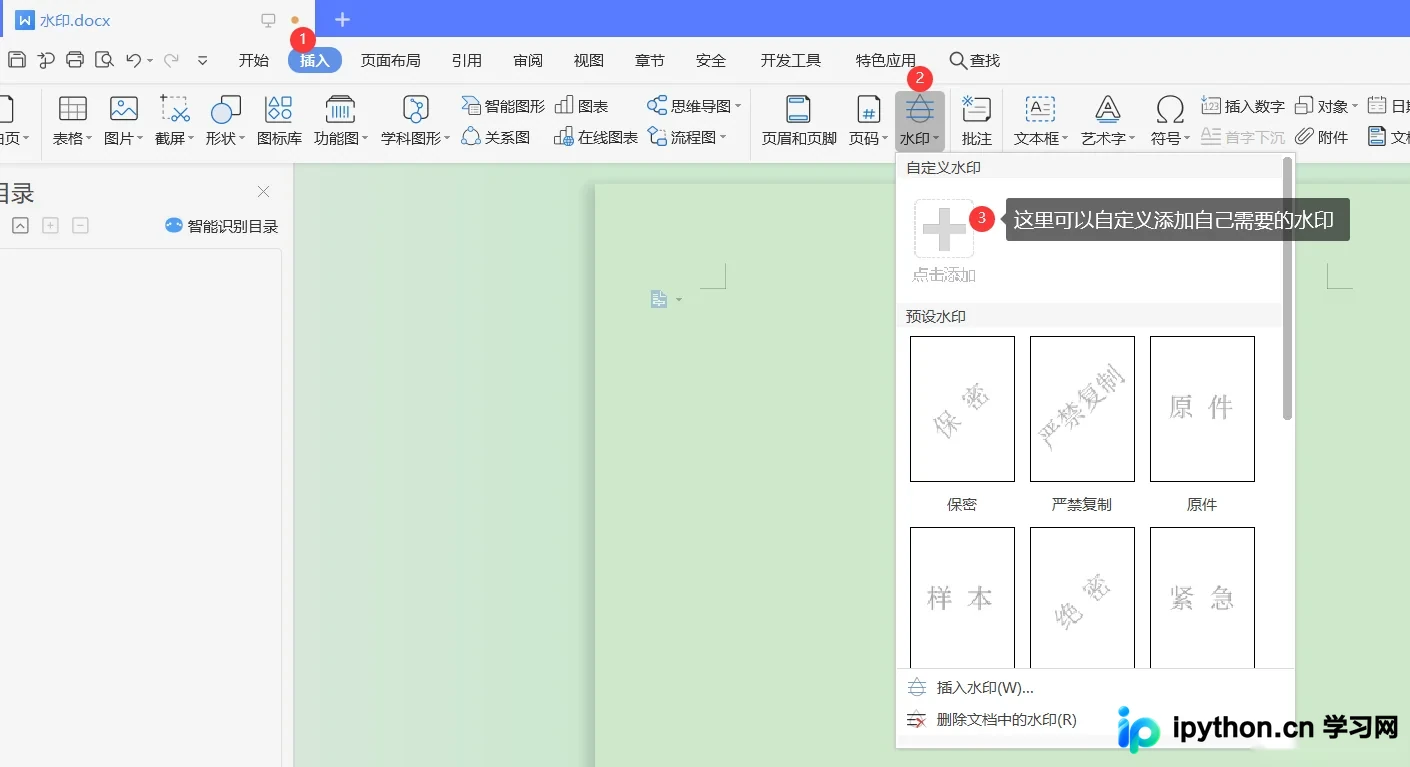
本文介绍如何使用Python的PyPDF2库为PDF文件批量添加水印,并详细解决运行过程中常见的UnicodeEncodeError编码异常。通过修改PyPDF2源码中的generic.py和utils.py文件,实现中文字符的正确处理,确保水印添加功能稳定运行。
本文详细介绍Python中lxml库的etree模块,涵盖从安装到高级解析的全流程。内容包含创建与操作子节点、管理属性、设置文本、处理XML与HTML解析以及使用XPath定位元素,帮助开发者高效进行标签解析。
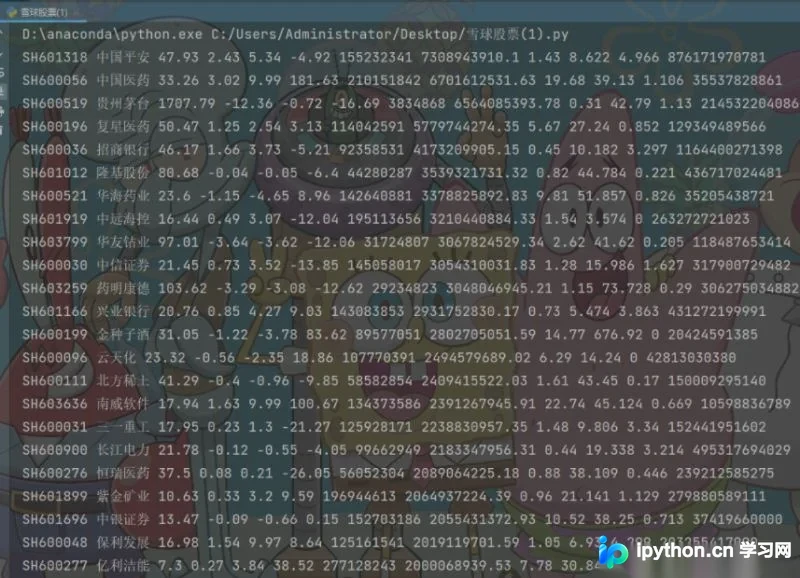
本文详细介绍如何使用Python从雪球网采集股票实时数据,包括requests请求、数据解析及CSV保存。接着利用pandas处理数据,通过pyecharts库生成成交量柱状图,实现股票数据的可视化展示,适合Python初学者参考。
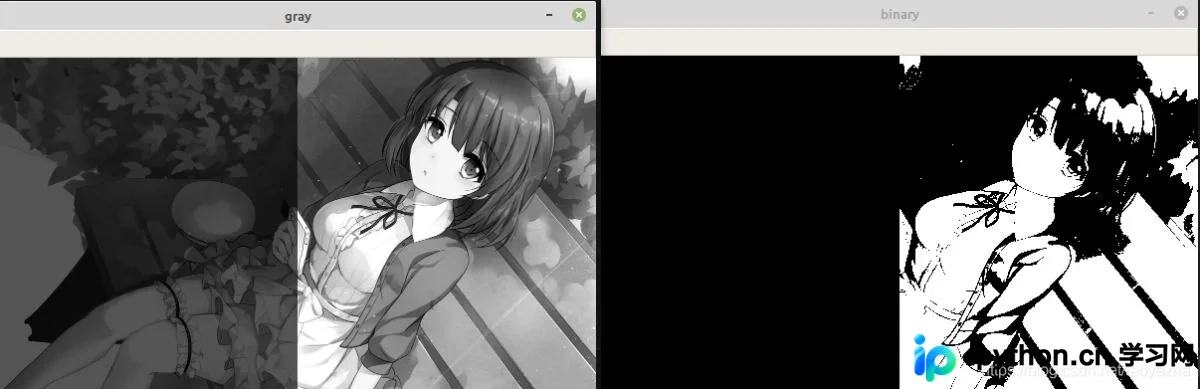
本文深入解析OpenCV中cv2.adaptiveThreshold函数的应用,针对全局阈值法在明暗不均图像中失效的问题,介绍如何通过局部区域计算动态阈值。详细讲解ADAPTIVE_THRESH_MEAN_C与GAUSSIAN_C两种算法、blockSize及C参数的影响,并结合Python代码演示如何优化轮廓提取效果。
本文详解Python接口自动化中文件上传与下载接口的实现。上传接口需使用Content-Type: multipart/form-data,通过files参数传递二进制流及元组格式的文件信息;下载接口则通过GET请求获取二进制响应内容并保存至本地。文章提供完整代码示例,涵盖参数构造、请求发送及结果断言,适用于文档、图片等格式的文件自动化测试场景。

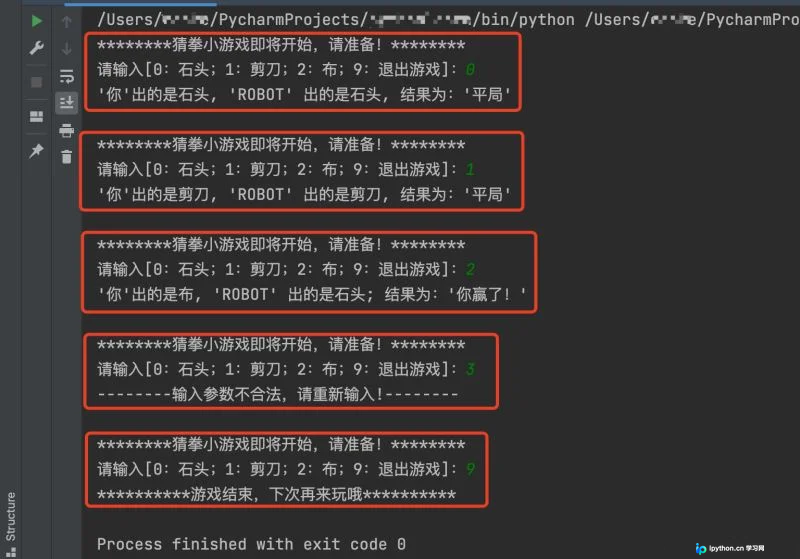
本文通过两个经典案例——猜拳与猜数字游戏,系统讲解Python基础语法在实战中的应用。内容涵盖条件判断、循环结构、随机数生成及输入输出处理,帮助初学者巩固Python零基础知识,掌握脚本编写技巧,完成从理论到实践的转变。
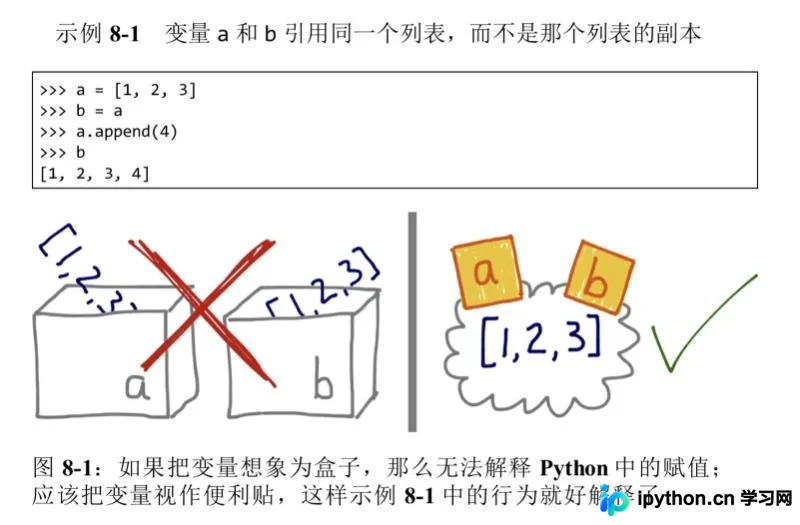
本文深入解析Python中变量引用的底层逻辑,区分直接赋值、浅拷贝与深拷贝的行为差异。通过对比C++等语言,阐明Python“一切皆引用”的概念,并详细说明在修改可变与不可变对象时,不同拷贝方式对原数据的影响及内存表现。
本文深入解析Python Pandas库中DataFrame的stack()、unstack()和pivot()三个核心数据重塑方法。通过具体代码示例,展示如何将列索引转换为行索引(stack),实现逆操作(unstack),以及利用pivot进行灵活的数据透视表构建。文章涵盖多重索引处理、Series对象转换及参数设置,帮助开发者高效处理结构化数据。