

Python字典深浅拷贝机制与高效遍历方法解析
本文深入解析Python中字典、列表等可变对象的赋值、浅拷贝与深拷贝机制,通过内存地址变化直观展示区别。同时对比了字典的两种常见循环方式,指出直接遍历Key与items()方法的性能差异,为大数据量场景下的代码优化提供实践建议。
2026-10-13
14
本文深入解析Python中字典、列表等可变对象的赋值、浅拷贝与深拷贝机制,通过内存地址变化直观展示区别。同时对比了字典的两种常见循环方式,指出直接遍历Key与items()方法的性能差异,为大数据量场景下的代码优化提供实践建议。
本文深入解析Python中默认参数的调用方式,通过示例展示三种常见调用形式。重点阐述默认值仅在函数定义时赋值一次的机制,特别是当默认参数为列表等可变对象时可能引发的累积错误。文章提供了使用None作为默认值的标准解决方案,帮助开发者避免潜在bug,提升代码健壮性。
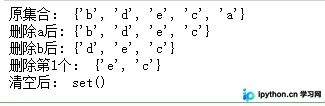
本文详细解析Python中集合的多种删除与更新方法。涵盖使用remove和discard指定删除元素的区别,以及利用difference_update、intersection_update和symmetric_difference_update实现集合间差集、交集和对称差集的更新操作,附带完整代码示例。
本文深入解析Python中sorted函数的核心原理,重点讲解key参数提取排序依据及reverse参数的反向排序功能。通过Person类的__lt__魔法方法重写示例,演示如何实现多条件自定义排序,帮助开发者掌握复杂数据结构的排序技巧。
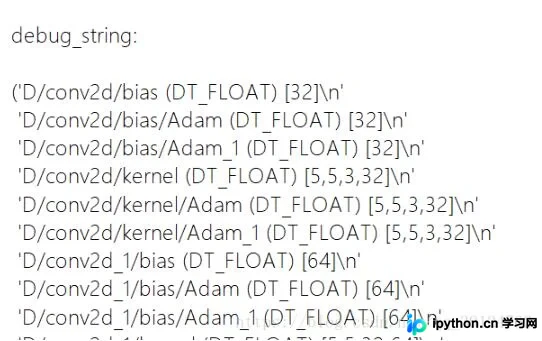
本文介绍如何在 TensorFlow 中使用 tf.train.NewCheckpointReader 类来读取保存的模型文件。通过该工具,开发者可以查看模型中所有变量的名称、数据类型及形状,并直接获取特定变量的张量值,适用于模型调试与权重分析。
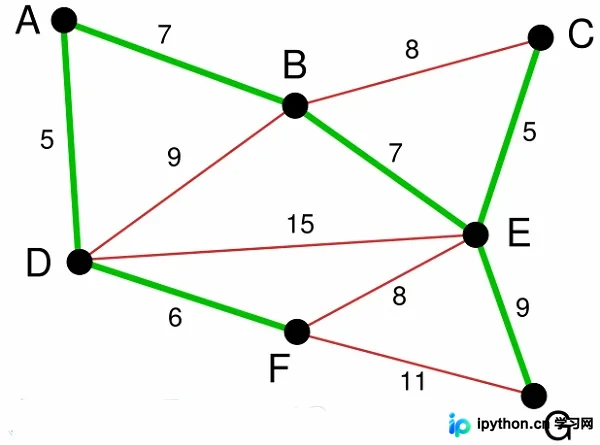
本文详细讲解如何使用C语言实现求解带权无向图最小生成树的两种经典算法:Prim算法与Kruskal算法。Prim算法通过维护最低成本数组逐步扩展生成树,适合稠密图;Kruskal算法利用并查集思想按边权值排序选取不构成环的边,适合稀疏图。文章提供完整代码示例、逻辑解析及具体输入输出测试,帮助开发者理解核心原理并直接应用于实际项目。
本文详细解析了Python中单链表反转的实现方法。通过定义Node类构建链表,利用Reserver函数遍历节点并调整指针指向,将原链表顺序逆置。文中逐步拆解了指针移动、临时节点保存及边界处理等关键步骤,帮助开发者深入理解链表操作的核心逻辑。
本文详细介绍Django中实现文件下载的三种主要方式:HttpResponse、StreamingHttpResponse以及推荐的FileResponse。通过对比源码机制与代码示例,解析如何正确设置Content-Type和Content-Disposition响应头,并针对Excel、PDF等常见文件类型提供具体的视图实现方案,帮助开发者选择最优下载策略。
本文详细解析Django Admin密码遗忘后的重置方法。通过Django Shell执行set_password命令可快速修改已知用户名的密码;若连管理员账号也遗忘,可直接查询MySQL数据库中的auth_user表获取用户名。步骤清晰,适用于各类Django项目维护场景。
本文详细介绍Python标准库doctest的使用方法。通过解析文档字符串(Docstring)中的交互式示例,doctest能自动验证代码输出是否符合预期。文章涵盖测试用例构造规范、在__main__中调用testmod()以及通过命令行python3 -m doctest执行测试的具体步骤,帮助开发者在开发过程中便捷地实现轻量级单元测试。
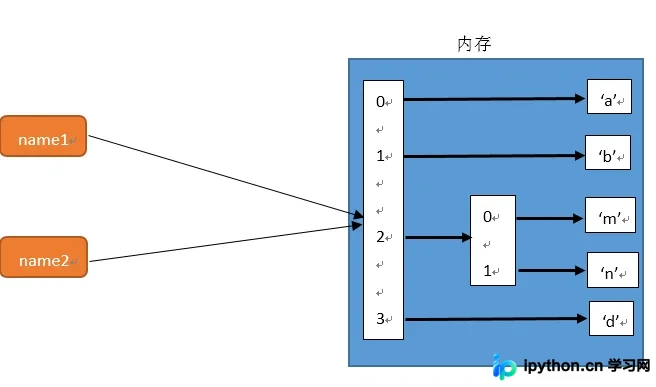
本文详细介绍 Python3 中元组(tuple)的基础用法。内容涵盖元组的创建、访问、截取、连接与删除操作,深入解析元组不可变的内存机制及含可变对象时的特殊情况。此外,还讲解了如何使用 collections.namedtuple 创建具名元组,以及常见的元组操作技巧。
本文介绍在Python中获取列表内重复数据所有下标的方法。通过遍历统计目标值出现次数,利用切片和索引定位功能,依次计算并累加偏移量,从而收集所有匹配项的完整索引位置。