


Python NumPy/Pandas中axis=0与axis=1的区别详解
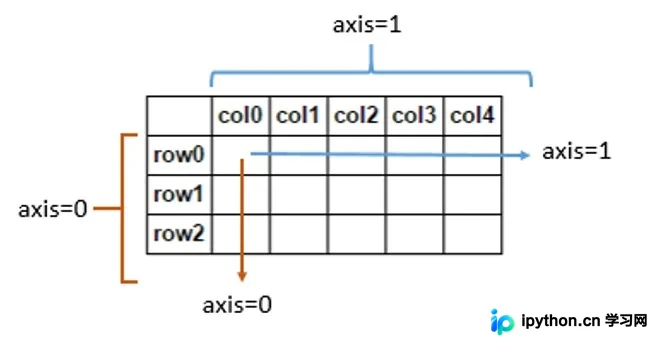
在Python数据分析中,axis=0和axis=1是核心概念。axis=0代表沿行方向(跨列)操作,如计算每列均值;axis=1代表沿列方向(跨行)操作,如计算每行均值。理解这一区别对于正确执行数据聚合和列删除至关重要。
2026-10-11
7
在Python数据分析中,axis=0和axis=1是核心概念。axis=0代表沿行方向(跨列)操作,如计算每列均值;axis=1代表沿列方向(跨行)操作,如计算每行均值。理解这一区别对于正确执行数据聚合和列删除至关重要。
pySerial 是 Python 处理串口通信的标准第三方库。本文系统梳理该库在嵌入式设备对接、硬件控制与仪器数据采集中的典型应用,给出从环境安装、端口参数配置到数据读写、缓冲区监控及安全释放的完整操作示例,帮助开发者快速建立稳定的串行通信链路。
掌握Pandas中DataFrame.replace()函数的核心参数与多种替换场景。本文通过单值、字典映射、列表对应及正则表达式四个实操步骤,演示如何高效清洗数据并规避原地修改的风险,助力Python数据分析流程更稳定。
本文介绍如何使用Python实现TF-IDF算法进行文本关键词提取。TF-IDF由词频(TF)和逆文档频率(IDF)组成,通过计算词频与逆文档频率的乘积来评估词语在文档中的重要性。文章详细讲解了TF-IDF的计算步骤,包括计算词频、逆文档频率以及最终的TF-IDF值,并提供了完整的Python代码实现。
Python处理文本时依赖正则表达式实现高效模式匹配。本文详细演示re.search定位首个匹配、re.findall与re.finditer批量获取、re.compile预编译优化性能、命名捕获组解析结构化文本,以及re.sub一键清除换行与空格的完整操作,附带可直接运行的代码示例,覆盖日常数据清洗与解析需求。
本文深入解析Python中强大的可变参数传递机制。通过对比旧版本中利用字符串拼接与eval模拟参数传递的复杂做法,以及现代Python中直接使用*操作符解包任意可迭代对象(如元组、列表、字典、生成器)的简洁方式,帮助开发者理解函数参数传递的演进与最佳实践。
本文深入解析Python中两大核心测试工具:doctest与unittest。通过具体代码示例,展示如何利用doctest在文档字符串中嵌入测试用例,以及如何利用unittest构建结构化的测试套件。文章涵盖环境准备、代码编写、命令执行及结果验证,帮助开发者快速掌握Python自动化测试的核心技能。
本文介绍如何使用 Python wxauto 库对 Windows 版微信客户端进行 UI 级自动化控制。通过实例化对象,可快速获取通讯录与群组数据、提取聊天记录、定向发送文本及多媒体文件,并编写轮询脚本实现关键词触发的自动回复。配合基础的环境配置与注意事项,适合用于轻量级营销通知、客服应答辅助或内部信息同步等场景。
本文介绍在Python中将列表内字符串首字母大写的两种常用方法。通过内置的capitalize()函数结合列表推导式,或使用map()函数配合lambda表达式,均可高效实现字符串格式化处理。
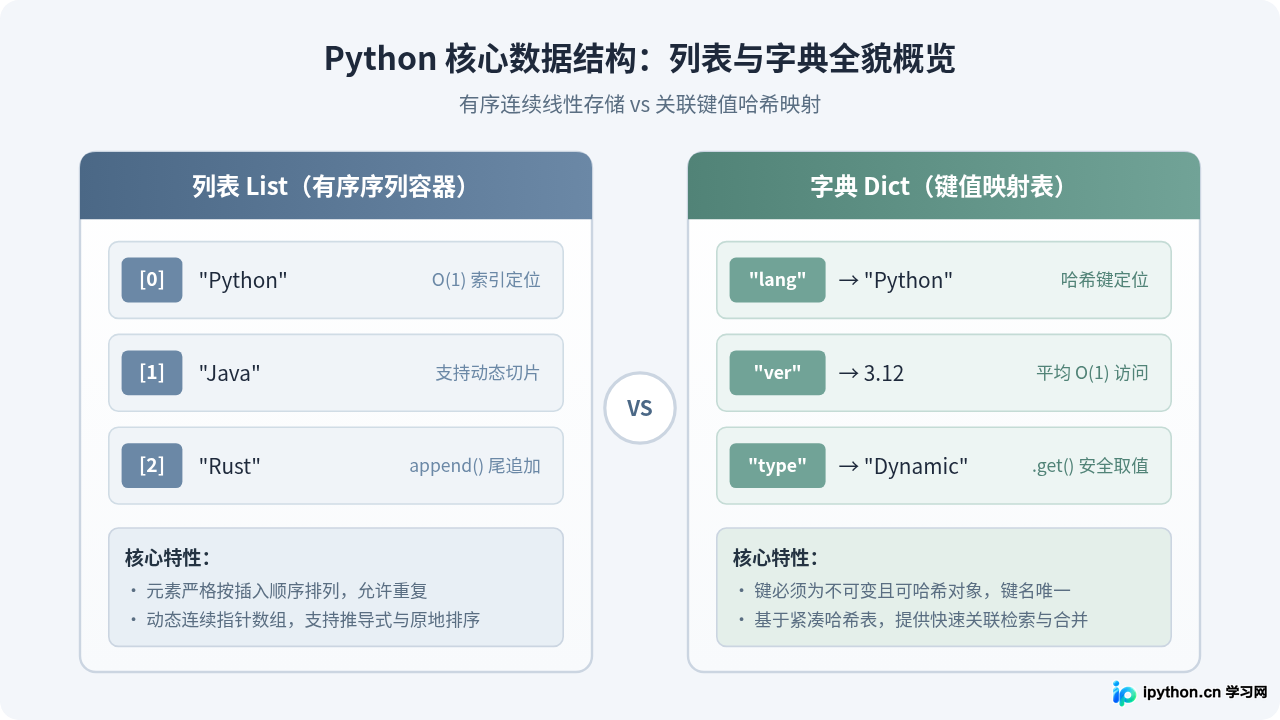
深入讲解Python中最核心的两种内置数据结构——列表(List)与字典(Dictionary)的基础用法与高效操作技巧,涵盖内存模型对比、常用增删改查方法、推导式应用、常见误区与实战流转。
该报错通常在Pandas尝试将含重复索引的数据映射至唯一新索引时触发。可通过保留首条记录的去重操作、重置默认索引或对重复项进行分组聚合来彻底消除冲突,并在执行reindex前利用index.is_unique进行校验,确保后续数据处理流程顺畅。