Python并发编程详解:进程、线程与协程的核心区别与应用
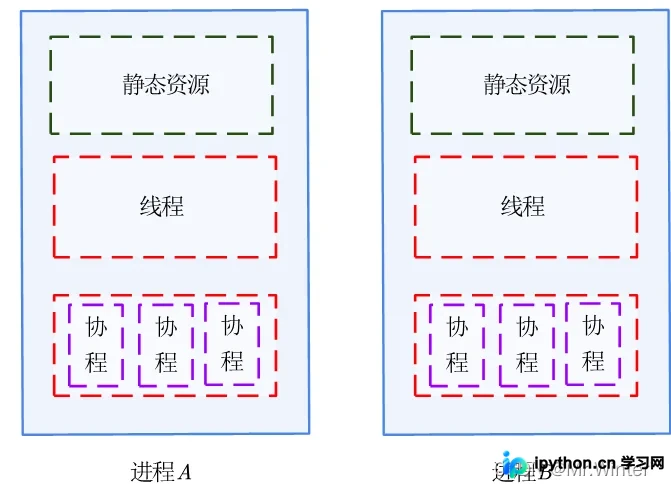
本文深入解析Python中的并发编程模型,详细对比进程、线程和协程的概念、特性及适用场景。通过multiprocessing、threading和asyncio库的代码示例,阐述多进程处理、多线程锁机制及协程异步IO的实现方式,帮助开发者根据IO密集或计算密集型任务选择最优并发方案。
2026-10-15
0
本文深入解析Python中的并发编程模型,详细对比进程、线程和协程的概念、特性及适用场景。通过multiprocessing、threading和asyncio库的代码示例,阐述多进程处理、多线程锁机制及协程异步IO的实现方式,帮助开发者根据IO密集或计算密集型任务选择最优并发方案。
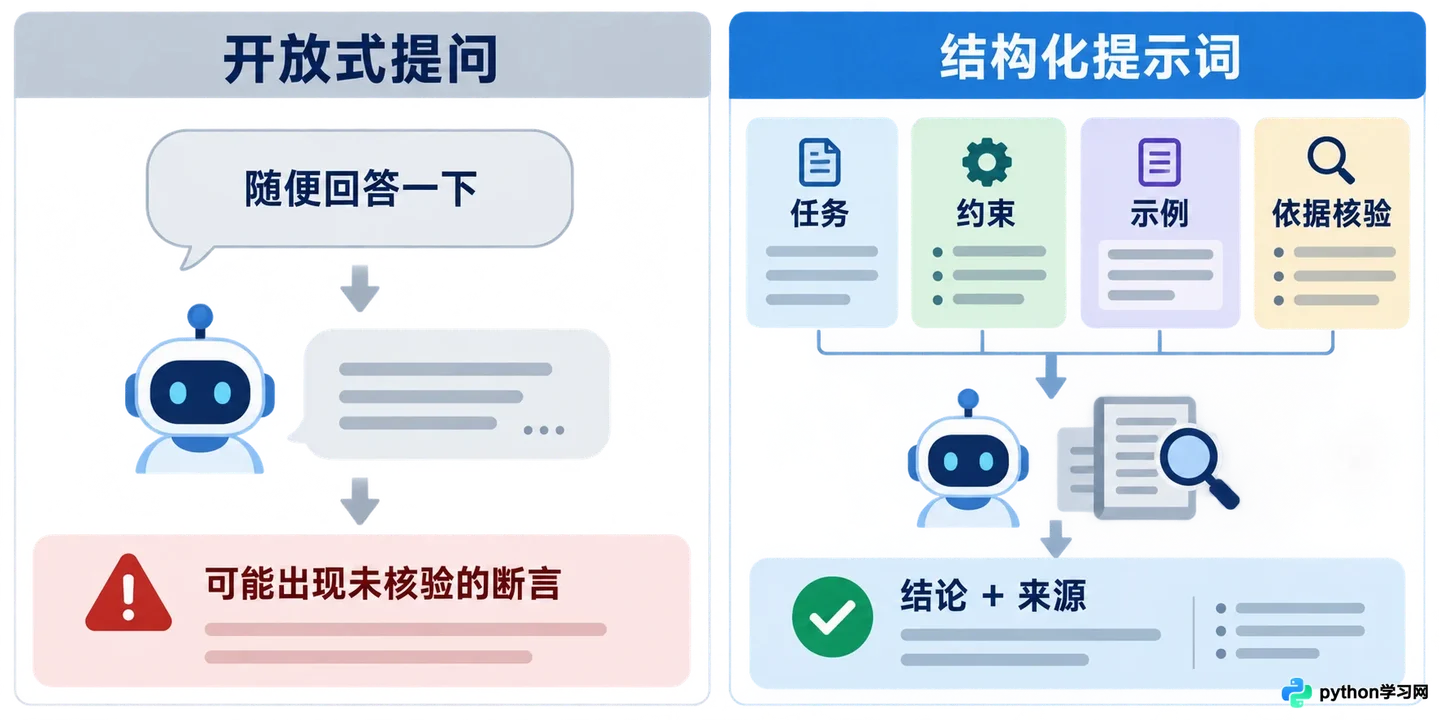
本文从实际业务场景出发,探讨在大模型应用开发中如何通过精细化的提示词工程(如思维链、少样本学习)和多层级的输出校验策略(如引用溯源、逻辑一致性检查)来抑制模型幻觉。文章不堆砌参数,而是聚焦于“如何让AI说真话”的工程实践,帮助开发者在准确性与灵活性之间找到平衡点。
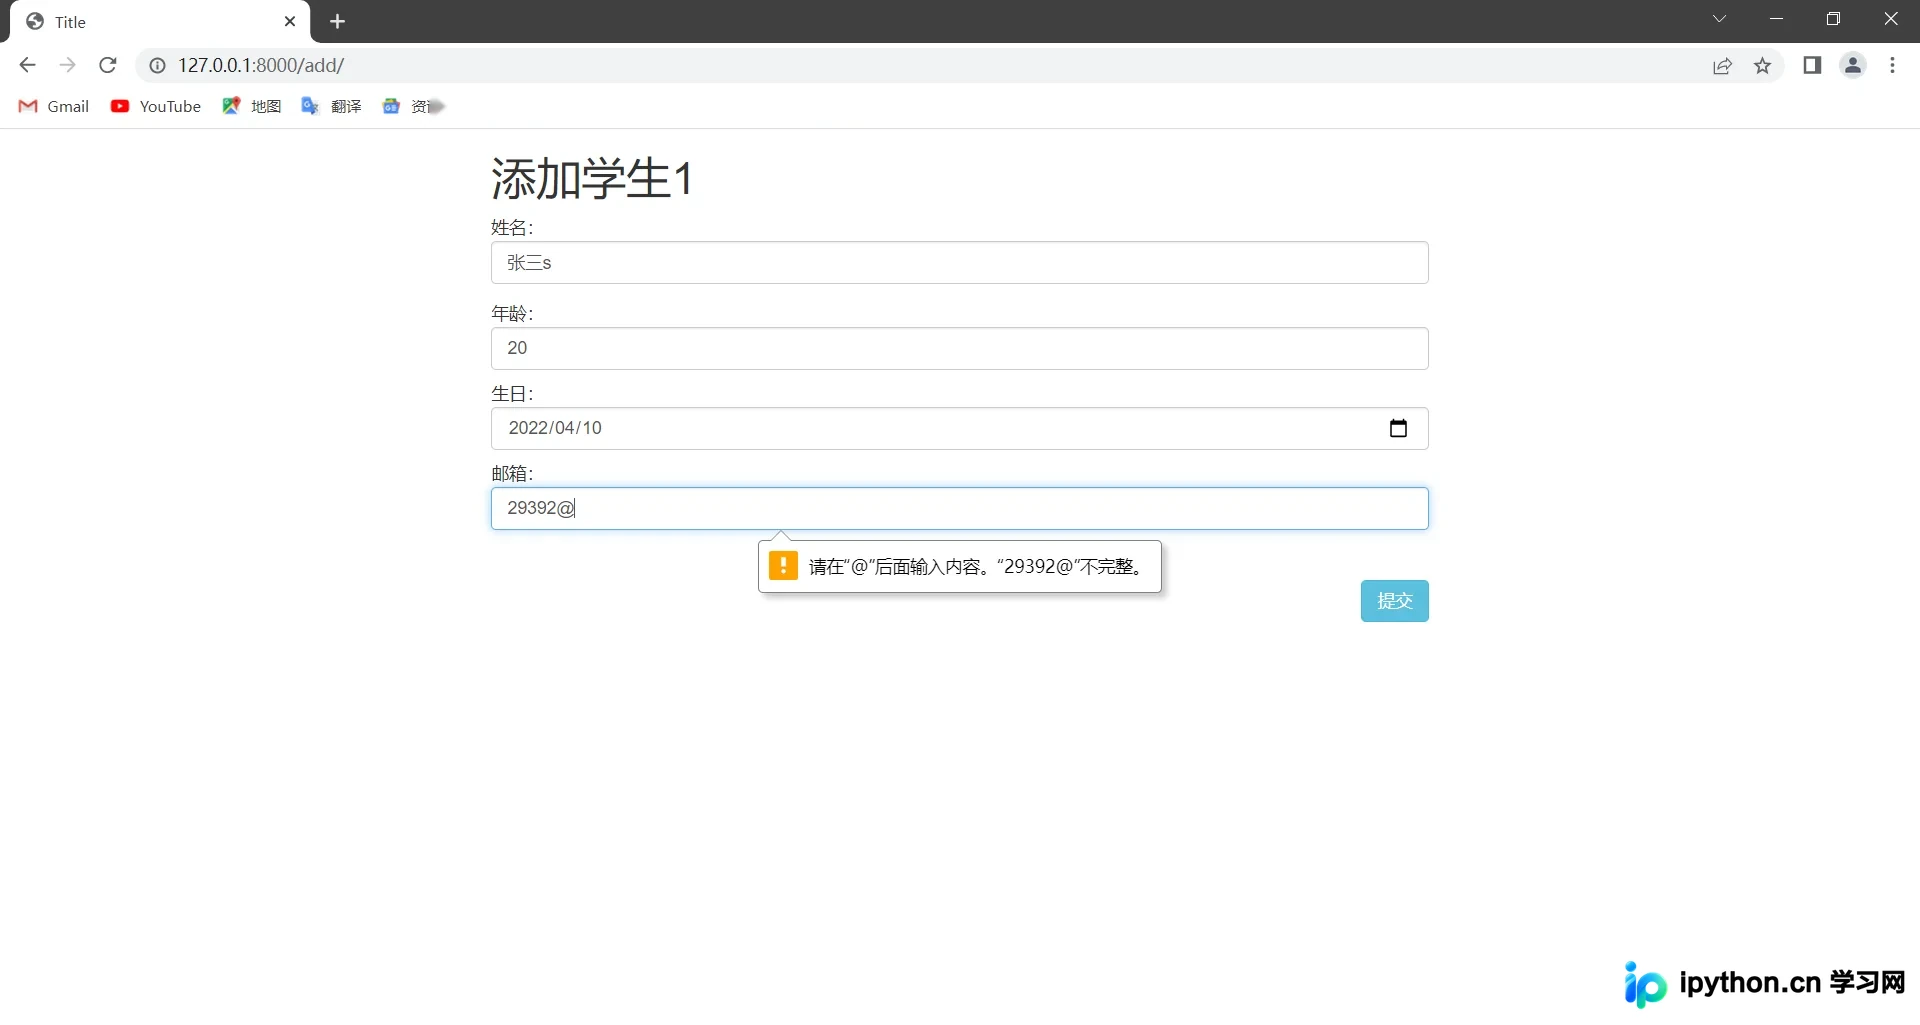
本文详细介绍 Django 中 ModelForm 组件的配置与使用。涵盖从创建模型类、生成迁移文件,到定义表单类、配置字段校验与样式。深入讲解如何自定义添加模型中不存在的字段(如确认密码)、控制显示字段、自定义错误提示信息及输入控件参数,并对比 Form 与 ModelForm 的适用场景,帮助开发者高效构建数据录入功能。
本文详细介绍Go语言中限制协程并发数的两种核心方案。第一种基于带缓冲的channel,通过读写阻塞实现限流,代码简洁但难以动态调整;第二种基于sync.Mutex和计数器,支持运行时动态修改最大并发数及等待任务完成。文章提供完整代码示例及性能评估,帮助开发者根据场景选择最佳实践。
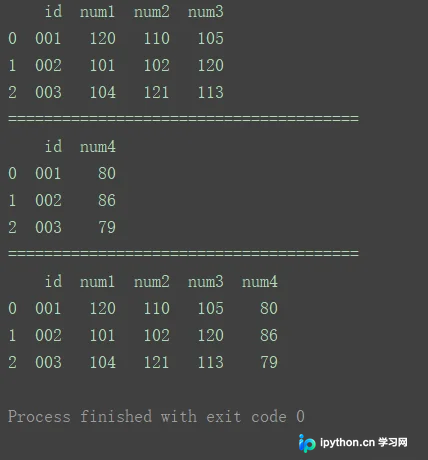
本文详细解析Python中Pandas库的数据合并方法。重点讲解merge()函数的inner、outer、left、right四种连接方式及多对一、多对多场景,并对比concat()在纵向堆叠与横向对齐时的参数配置,通过代码示例展示索引、键值处理及keys标记技巧。
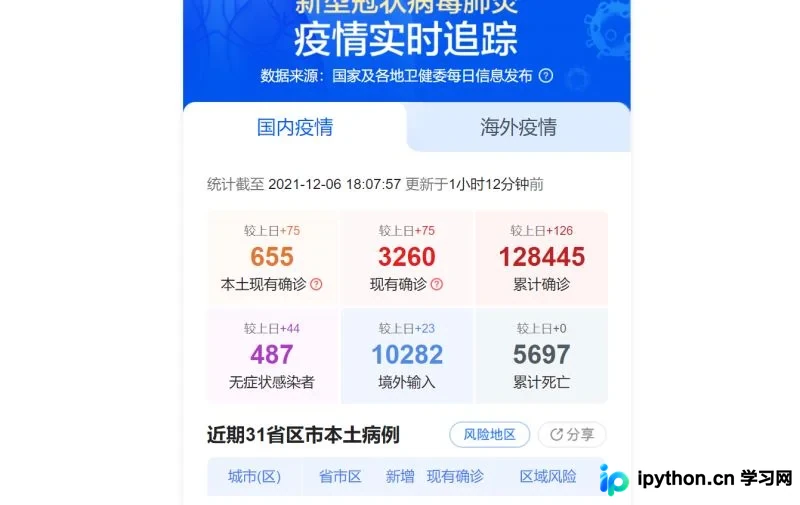
本文详细介绍如何使用Python进行疫情数据爬取与可视化。通过requests获取腾讯接口数据,利用pandas清洗保存,最后使用pyecharts绘制死亡率、治愈率及各地区确诊分布图表,完整展示从数据获取到可视化展示的全流程。
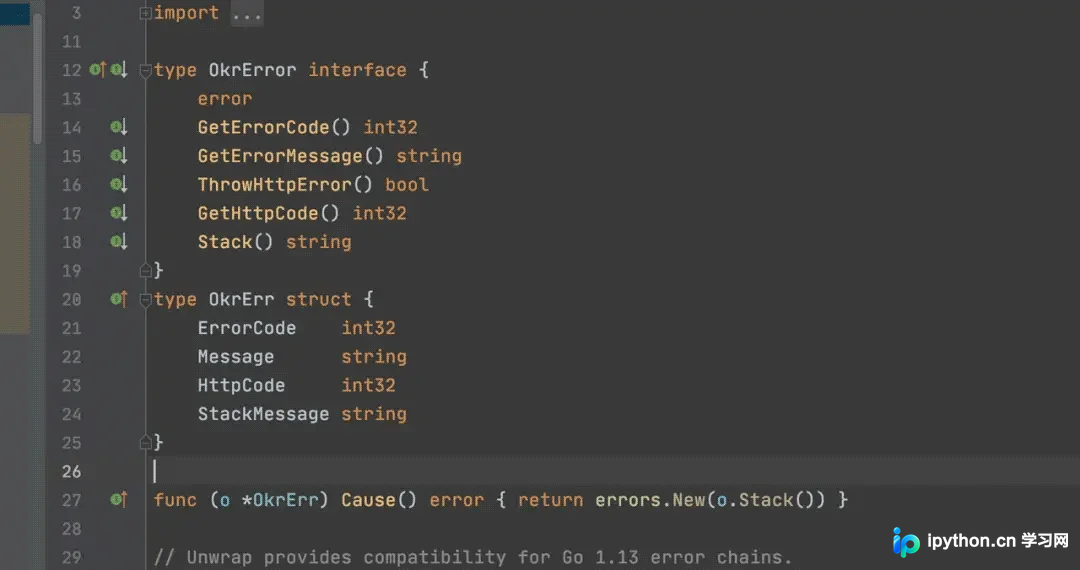
本文深入解析 Golang 反射机制的核心原理,剖析 interface 类型在运行时获取元数据的操作方式。通过基准测试对比结构体初始化、字段读写及方法调用的性能损耗,指出 FieldByName 等动态查询带来的显著瓶颈。结合 OKR 系统日志注入的实际案例,展示如何利用反射编写通用中间件,并提供启动期缓存索引的优化策略,帮助开发者在灵活性与性能间找到平衡。
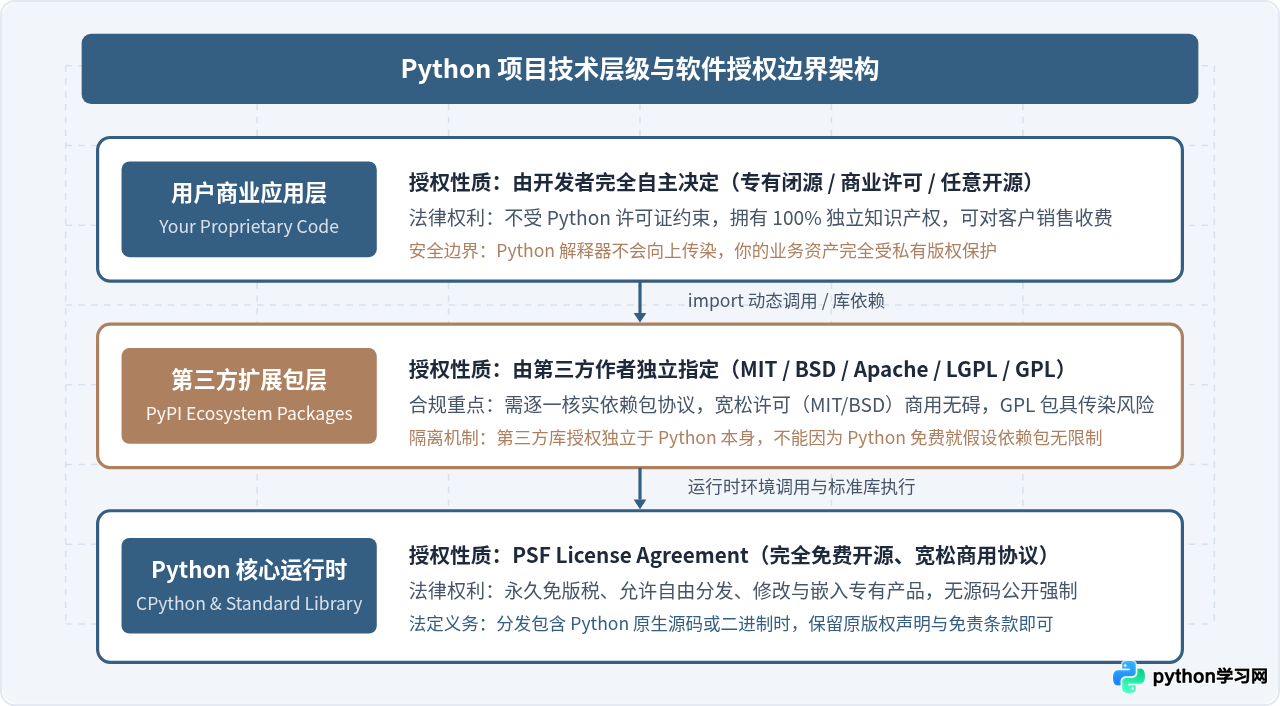
详细解答Python是否免费,剖析PSF许可证在个人学习、企业内部系统、商业SaaS以及独立分发闭源软件时的具体权利、法定义务与合规要点。
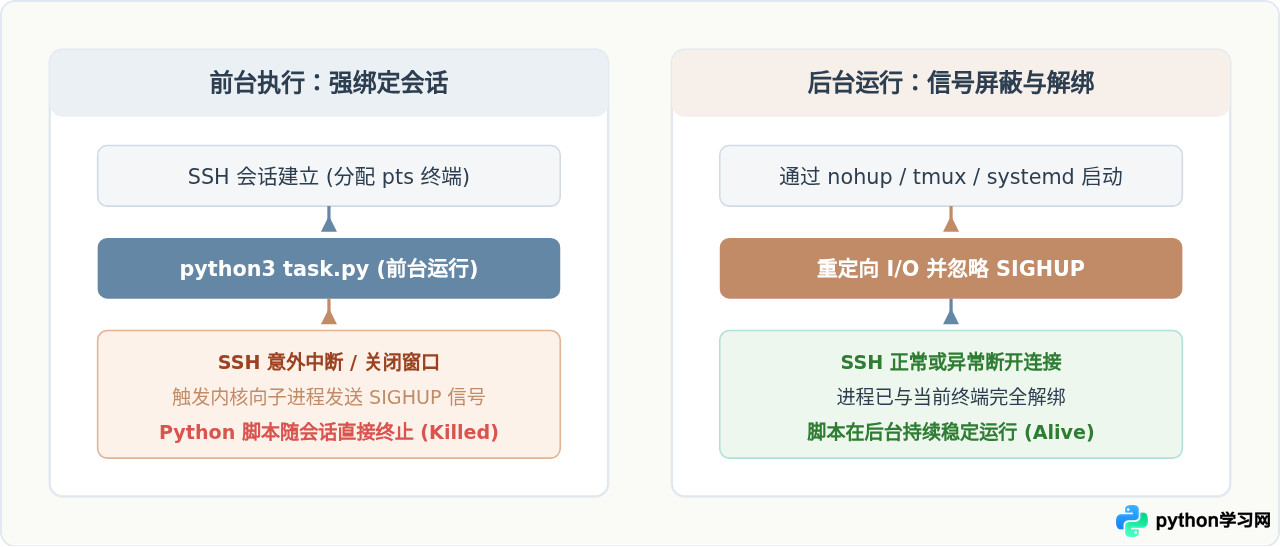
详细讲解在Linux服务器上后台稳定运行Python脚本的主流方法,涵盖nohup与I/O重定向、tmux终端复用、systemd生产级服务配置,并深度解析缓冲区问题与进程管理实践。
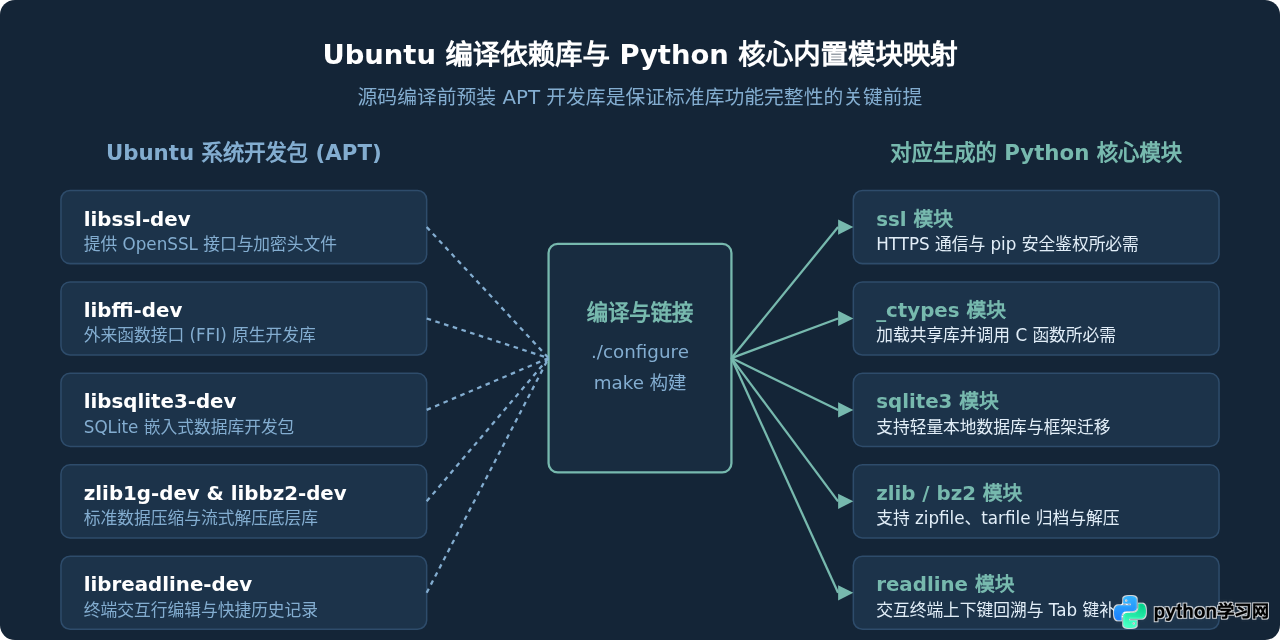
详细介绍在 Ubuntu 系统中从官方源码编译并安装最新版 Python 的完整操作步骤,涵盖依赖安装、编译优化配置、altinstall 安装隔离与验证。
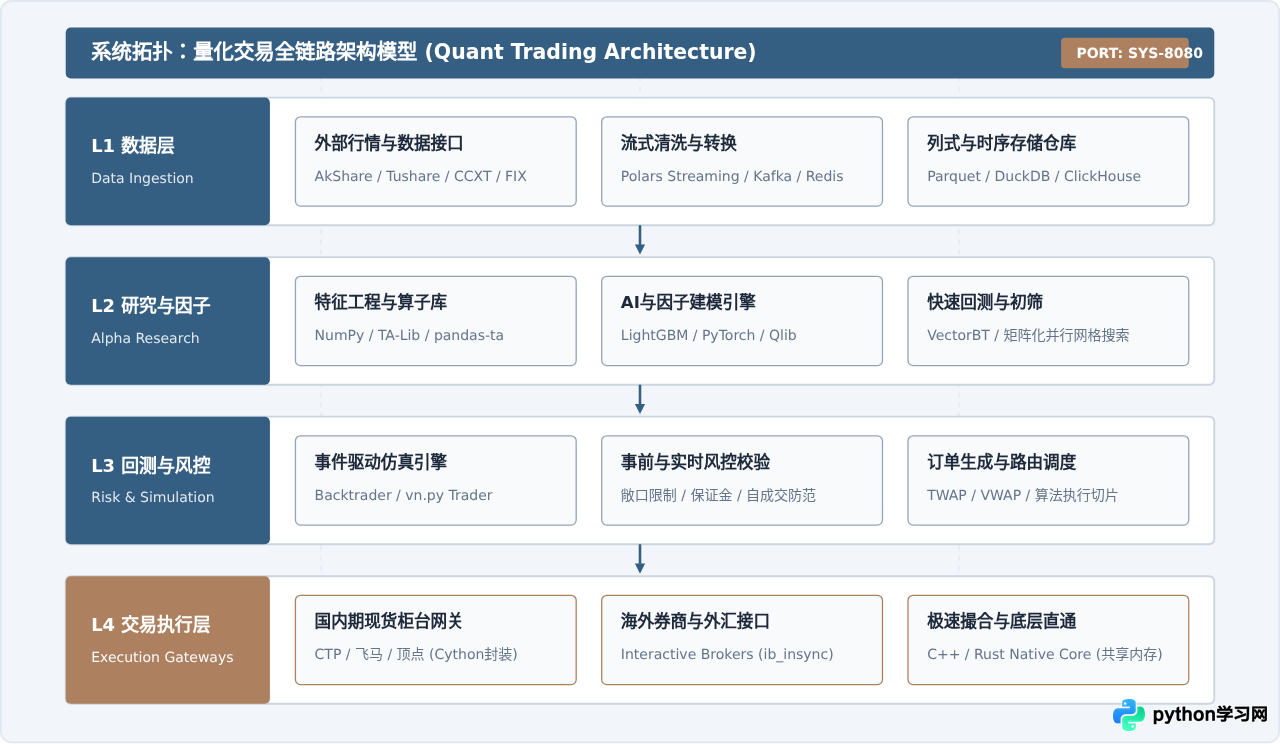
全面解析Python在金融科技与量化交易领域的实际应用现状、系统工程架构、核心技术栈选型、回测与实盘研发流程以及性能优化方案。