

Golang 反射实战:原理、性能优化与中间件应用详解

本文深入解析 Golang 反射(Reflection)机制的核心原理,分析其在结构体操作、数据序列化及中间件开发中的实际应用。通过详细的基准测试数据,对比直接调用与反射操作的显著性能差异,重点揭示 FieldByName 等方法的高昂开销,并提供利用运行前索引优化性能的实用方案。
Golang 类型设计与反射原理
理解 Go 语言的反射,首先需要厘清变量在内存中的构成。在 Golang 中,任何变量都由 类型(Type)和 值(Value)两部分组成。要掌握反射,必须区分两种类型概念:
- Static Type(静态类型):代码编译时可见的类型,如声明时的
int、string。编译期间编译器即可确定。 - Concrete Type(具体类型):运行时系统中的实际类型。只有在
interface类型的变量中,才包含具体的类型信息。
反射主要作用于 interface{} 类型。通过反射,程序可以在运行时检查变量的类型和值,甚至修改它们的值和调用其方法,而无需在编译时知道确切的类型。reflect 包提供了两个核心入口:reflect.TypeOf() 用于获取接口背后的类型信息(返回 reflect.Type 接口),reflect.ValueOf() 用于获取接口的值信息(返回 reflect.Value 结构)。
何时使用反射:解决多态与通用逻辑
反射通常用于处理“未知类型”或“通用处理”的场景。例如 JSON 序列化库(如 encoding/json)需要遍历结构体的所有字段进行映射,但编译时无法预知结构体的具体字段。此时可以通过 switch-case 硬编码处理已知类型,但这会导致代码无限膨胀:
func Sprint(x interface{}) string {
    type stringer interface {
        String() string
    }
    switch x := x.(type) {
    case stringer:
        return x.String()
    case string:
        return x
    case int:
        return strconv.Itoa(x)
    // ... 其他类型需逐个添加
    default:
        return "wrong parameter type"
    }
}
当支持的类型越来越多时,switch 语句将变得难以维护。反射允许以统一的逻辑处理任意结构体和切片,是实现通用工具库(如 ORM、序列化器、校验器)的关键技术。
反射基础操作实战
在实际业务中,反射常用于对象的动态创建、字段的读取/修改以及基于条件过滤的数据组装。以下是针对结构体处理的三个常见场景:
第1步:利用反射创建结构体实例
当需要一个泛型工厂方法,根据传入的类型动态创建实例时使用。注意,如果传入的是指针,需要先获取底层元素类型。
func NewUserInfoByReflect(req interface{}) *UserInfo {
    if req == nil {
        return nil
    }
    reqType := reflect.TypeOf(req)
    // 如果是指针类型,取消引用获取基础类型
    if reqType.Kind() == reflect.Ptr {
        reqType = reqType.Elem()
    }
    // reflect.New 创建一个指向新零值的指针
    return reflect.New(reqType).Interface().(*UserInfo)
}
第2步:动态读取并过滤结构体字段
在处理响应数据时,可能需要根据特定条件(如 ID)过滤 Slice 字段。通过遍历字段并判断类型是否为 Slice,再进行数据筛选:
func FilterOkrRespData(reqData interface{}, objId int64) {
    rv := reflect.ValueOf(reqData).Elem()
    for i := 0; i < rv.NumField(); i++ {
        fieldValue := rv.Field(i)
        if fieldValue.Kind() != reflect.Slice {
            continue
        }
        // 获取 Slice 的元素类型(例如 []*ObjInfo)
        sliceType := fieldValue.Type().Elem()

        // 创建新的空 Slice
        newSlice := reflect.MakeSlice(reflect.SliceOf(sliceType), 0, 0)

        // 遍历原 Slice,保留符合条件的元素
        for j := 0; j < fieldValue.Len(); j++ {
            item := fieldValue.Index(j).Elem() // 获取当前元素的 struct 值
            // 假设我们需要过滤 ObjId == objId 的项
            objIdVal := item.FieldByName("ObjId").Int()
            if objIdVal == objId {
                newSlice = reflect.Append(newSlice, fieldValue.Index(j))
            }
        }
        // 将过滤后的结果写回原结构体字段
        fieldValue.Set(newSlice)
    }
}
第3步:修改结构体字段值
修改字段前,必须确保该字段是可设置的(CanSet() 返回 true),这通常要求传入的是非空指针的地址。同时,尽量使用字段索引而非名称来降低开销。
func ModifyOkrDetailRespData(req interface{}) {
    reqValue := reflect.ValueOf(req).Elem()
    // 检查是否可设置
    fmt.Println(reqValue.CanSet())

    // 获取 UInfo 字段的类型
    uType := reqValue.FieldByName("UInfo").Type().Elem()

    // 创建一个新的 UserInfo 实例
    uInfo := reflect.New(uType)

    // 使用索引访问字段以提高性能(假设为第1个字段)
    reqValue.Field(1).Set(uInfo)
}
性能分析与优化策略
反射之所以被认为是低效的,是因为它在运行时需要进行大量的类型检查和内存间接寻址。为了量化这种差距,我们进行了针对结构体初始化、字段读写和方法调用的基准测试(Benchmark)。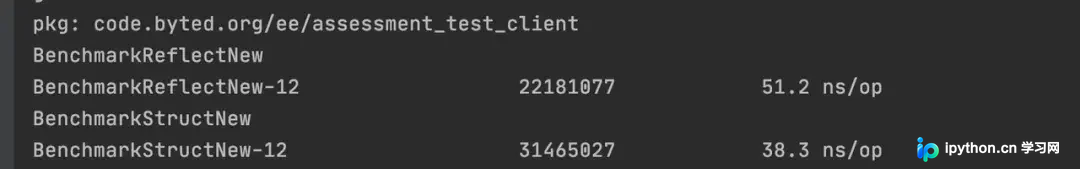
结构体初始化的性能对比
通过反射创建对象 vs 直接使用 new():
// 反射方式
tf = reflect.New(t).Interface().(*TestReflectField)
// 直接方式
tf = new(TestReflectField)
测试结果 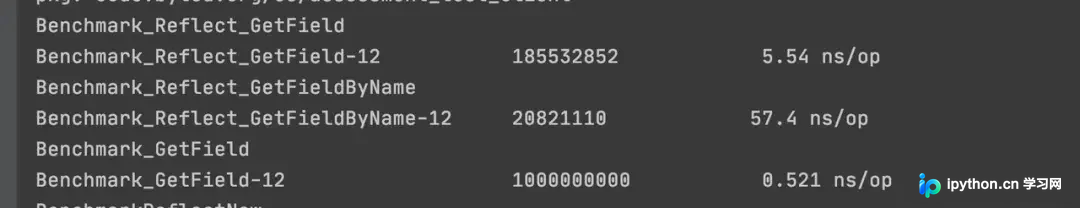 显示,反射创建对象的耗时略高于直接创建,但在单次操作中差距尚属可控范围。这表明在初始化场景中,反射的性能损耗相对较小。
字段读写的性能陷阱
这是性能差距最显著的部分。直接访问字段只需要一条指令,而反射需要经过类型查询、安全检查等多步操作:
- 索引访问(Field(index)):速度较快,但仍然比直接赋值慢约 10 倍。
- 名称访问(FieldByName(name)):极其缓慢,通常需要直接访问的数百倍时间。因为内部实现是遍历结构体的类型描述符,比对字段名,然后查找偏移量。
测试结果 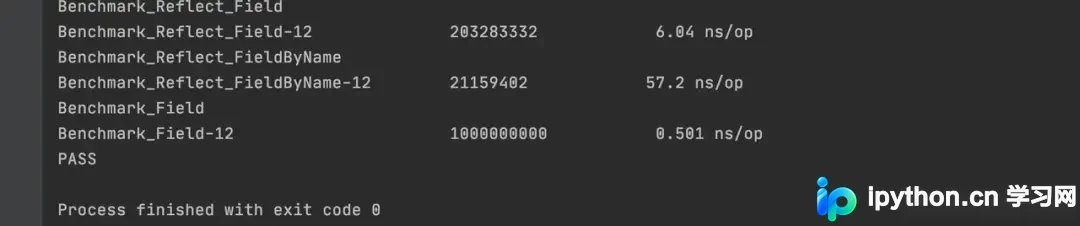 清晰表明:
FieldByName 的性能远低于 Field。如果在高频循环中使用 FieldByName,将对系统性能造成严重拖累。
方法调用的性能开销
反射调用方法(Method.Call)同样涉及参数打包、类型校验和函数派发。无论是无参调用还是带有多参数的复杂调用,其效率均远低于直接方法调用。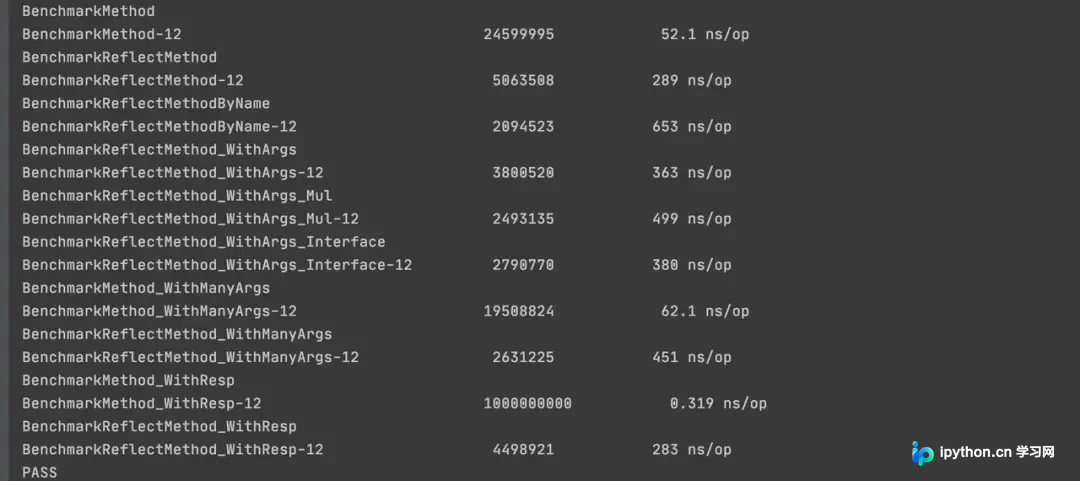 展示了不同参数情况下的耗时对比,进一步证实了反射调用链路的沉重负担。
反射应用的实战案例:通用中间件
在 OKR 等业务系统中,经常需要在请求进入核心逻辑前,从 Request Struct 中提取公共字段(如 UserID、Locale)并注入到 Context 中。利用反射,可以编写一个通用的拦截中间件,自动识别所有携带 OkrBase 字结构的请求:
func OkrBaseMW(next endpoint.EndPoint) endpoint.EndPoint {
    return func(ctx context.Context, req interface{}) (resp interface{}, err error) {
        requestValue := reflect.ValueOf(req)
        if requestValue.IsNil() {
            return next(ctx, req)
        }

        // 处理指针解引用
        kind := requestValue.Type().Kind()
        if kind == reflect.Ptr {
            requestValue = requestValue.Elem()
        }

        // 必须是结构体才能继续
        if requestValue.Kind() != reflect.Struct {
            return next(ctx, req)
        }

        // 提取 OkrBase 字段
        okrBaseField := requestValue.FieldByName("OkrBase")
        if !okrBaseField.IsValid() {
            return next(ctx, req)
        }

        // 尝试转换为具体类型并注入上下文
        if okr, ok := okrBaseField.Interface().(*okrx.OkrBase); ok && okr != nil {
            ctx = contextWithUserInfo(ctx, okr)
            ctx = contextWithLocaleInfo(ctx, okr)
            // ... 其他 Context 注入逻辑
        }

        return next(ctx, req)
    }
}
这种模式极大地简化了业务层的样板代码,只需定义好 Struct 结构,中间件即可自动完成上下文透传。
结论与最佳实践
反射是 Golang 中一把双刃剑。它能提供极高的灵活性,支撑起数据库映射、JSON 序列化等基础设施,但其带来的性能损耗也不容忽视。
优化建议:
- 避免在热路径使用反射:对于高并发、对延迟敏感的业务逻辑,尽量使用直接类型操作。
- 慎用
FieldByName和MethodByName:如果需要频繁访问某个字段,应在程序启动阶段通过reflect.Type.FieldByName().Index获取字段索引,并在后续反射操作中复用该索引。 - 合理使用:在初始化、数据转换、框架开发等非频繁执行的场景下,放心使用反射。
以上就是Golang 中反射的应用实例详解的详细内容,更多关于Golang 反射应用的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









