Java Apollo 配置中心本地部署与 Spring Boot 集成指南
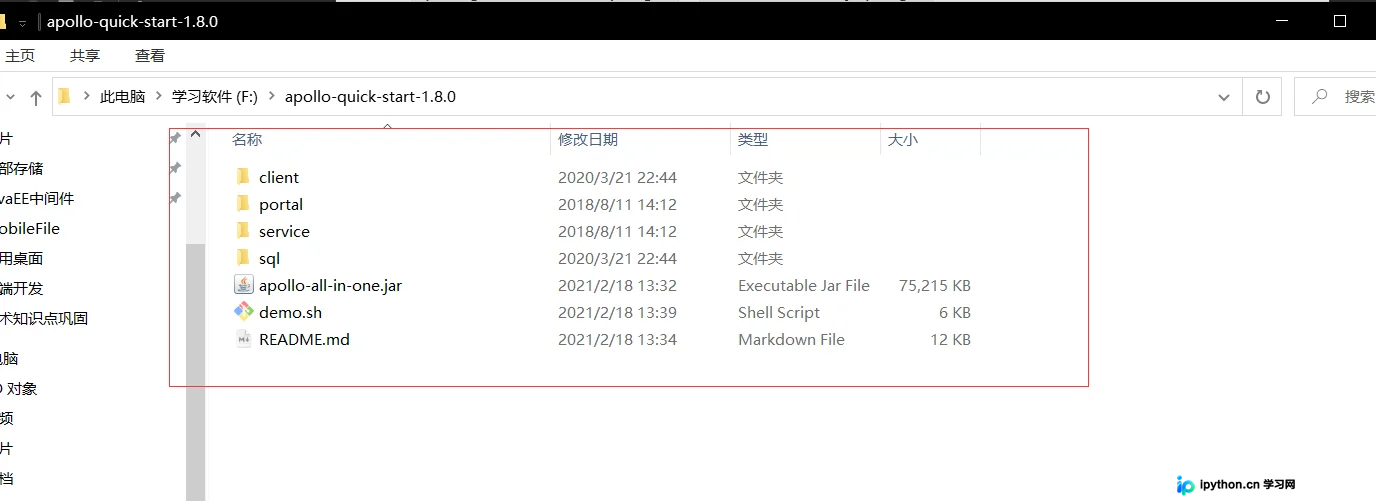
本文详细讲解如何从零搭建 Apollo 配置中心本地开发环境,包括数据库初始化、Quick Start 包打包启动及端口配置。同时演示如何将 Apollo 集成至 Spring Boot 项目,通过修改 pom.xml 引入 apollo-client 依赖,并配置 application.yml 实现配置的动态加载与管理,帮助开发者快速掌握分布式配置中心的搭建与应用。
2026-10-16
0
本文详细讲解如何从零搭建 Apollo 配置中心本地开发环境,包括数据库初始化、Quick Start 包打包启动及端口配置。同时演示如何将 Apollo 集成至 Spring Boot 项目,通过修改 pom.xml 引入 apollo-client 依赖,并配置 application.yml 实现配置的动态加载与管理,帮助开发者快速掌握分布式配置中心的搭建与应用。
本文深入解析Java中包(package)的核心作用、命名规范及常用内置包,并系统梳理四种访问修饰符(public, protected, default, private)的访问范围。通过同类、同包、不同包子类及不同包的代码实例,直观展示成员变量与方法的可见性控制规则,帮助开发者掌握Java封装的最佳实践。
本文详细解析 Entity Framework Code First 中的实体关系配置,涵盖一对一、一对多及多对多关系的设置方法。通过 Fluent API 和 Data Annotations 两种技术,讲解了 Has/With 语义、外键映射、逆导航属性解决多重引用以及级联删除控制,帮助开发者构建符合业务逻辑的数据模型。
本文详细介绍Java中处理异常的五个关键关键字:throw、throws、try、catch和finally。通过代码示例讲解如何手动抛出异常、声明受检异常、捕获并处理异常,以及确保资源清理的finally块使用规则。涵盖异常获取信息方法及多重异常捕获技巧,帮助开发者构建健壮的Java应用错误处理机制。
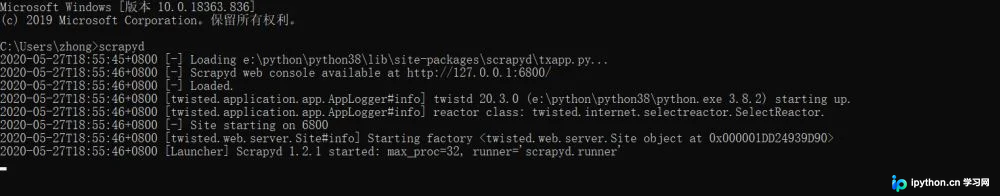
本文详细介绍Scrapy爬虫在生产环境中的服务器部署方案,涵盖Scrapyd服务端、ScrapydClient客户端及ScrapydWeb可视化管理工具的安装与配置。通过具体命令演示项目上传、爬虫启动及参数传递,并结合实际爬取数据展示部署效果与常见问题分析,帮助开发者实现高效、可视化的爬虫集群管理。
本文详细解析Django ORM中三种核心数据关联关系:一对一、一对多及多对多映射。通过具体代码示例,演示OneToOneField、ForeignKey及ManyToManyField的定义与使用,涵盖正向与反向查询技巧,包括反向属性book_set的生成机制及异常处理,帮助开发者掌握Django数据库建模的核心技能。
本文详细介绍 Flask-SQLAlchemy 的核心用法,涵盖数据库会话(db.session)的提交、回滚与错误处理机制。深入解析 query 对象的过滤器(filter/filter_by)与执行器(first/all/get)的使用,并通过代码示例展示数据插入、更新、删除及一对多关联查询的具体实现,帮助开发者掌握 Flask 中的 ORM 数据操作。
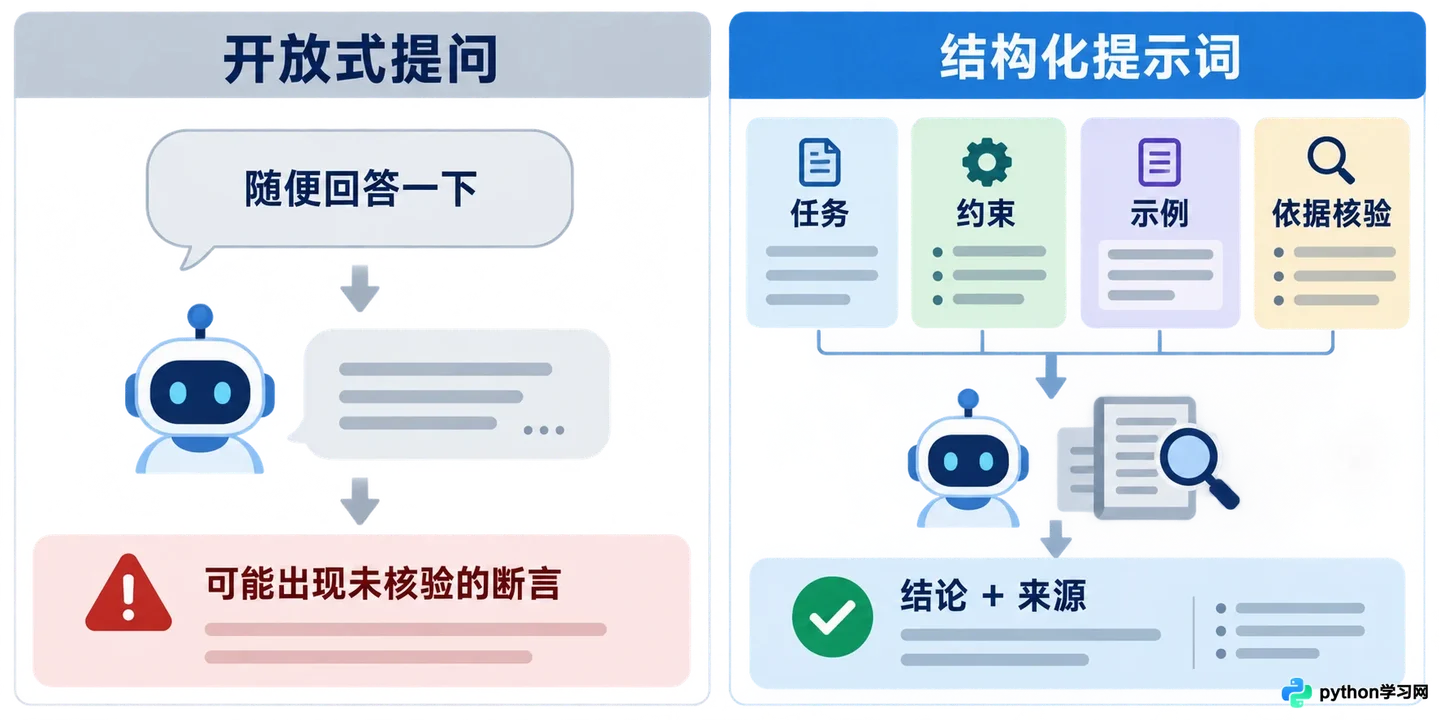
本文从实际业务场景出发,探讨在大模型应用开发中如何通过精细化的提示词工程(如思维链、少样本学习)和多层级的输出校验策略(如引用溯源、逻辑一致性检查)来抑制模型幻觉。文章不堆砌参数,而是聚焦于“如何让AI说真话”的工程实践,帮助开发者在准确性与灵活性之间找到平衡点。
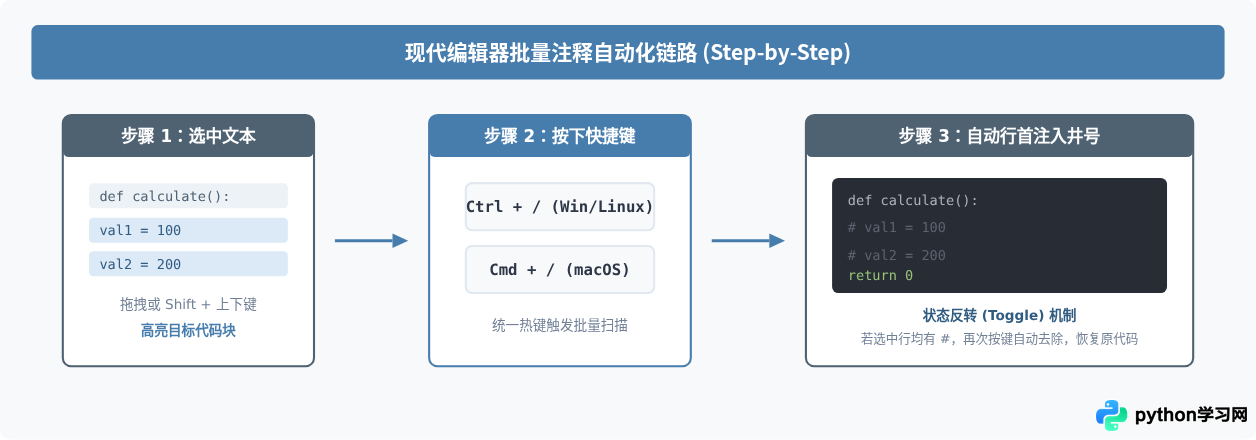
详细讲解Python批量注释多行代码的有效方法,包括各大主流编辑器(VS Code、PyCharm、Jupyter等)快捷键操作、三引号多行字符串的原理与缩进陷阱,以及正则批量替换与自动化处理技巧。
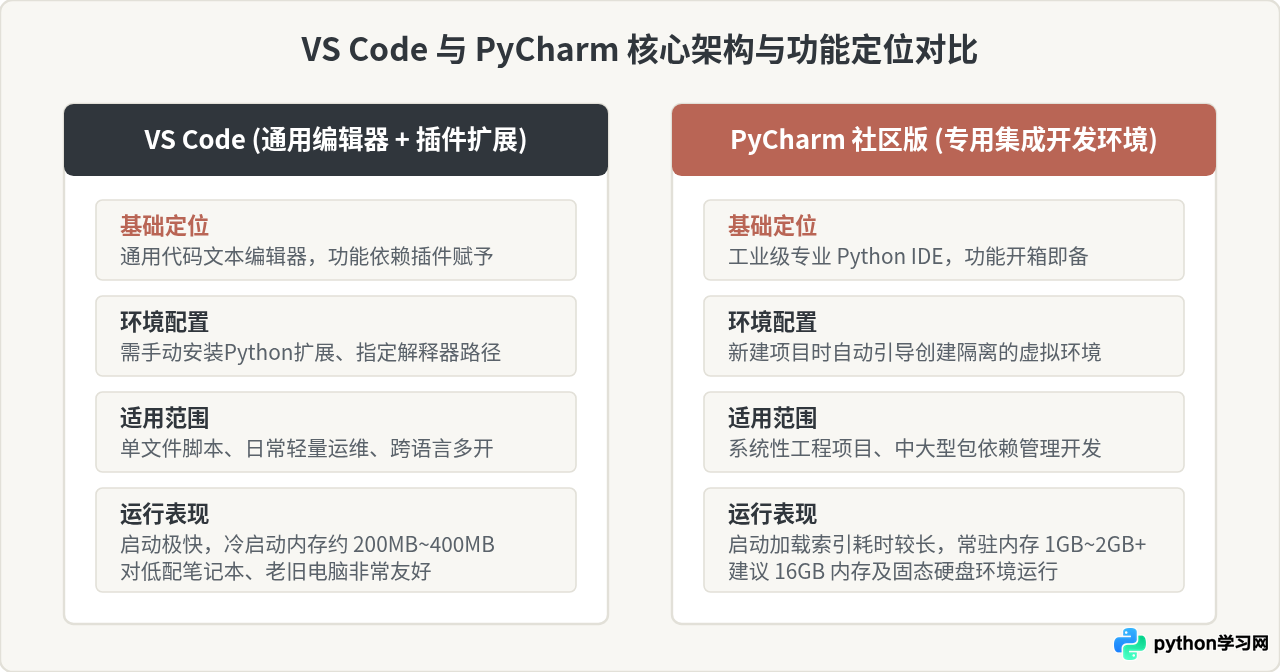
深入对比VS Code与PyCharm两款主流Python开发工具在入门门槛、系统资源占用、配置流程与适用场景上的差异,帮助初学者快速选择合适的开发环境。
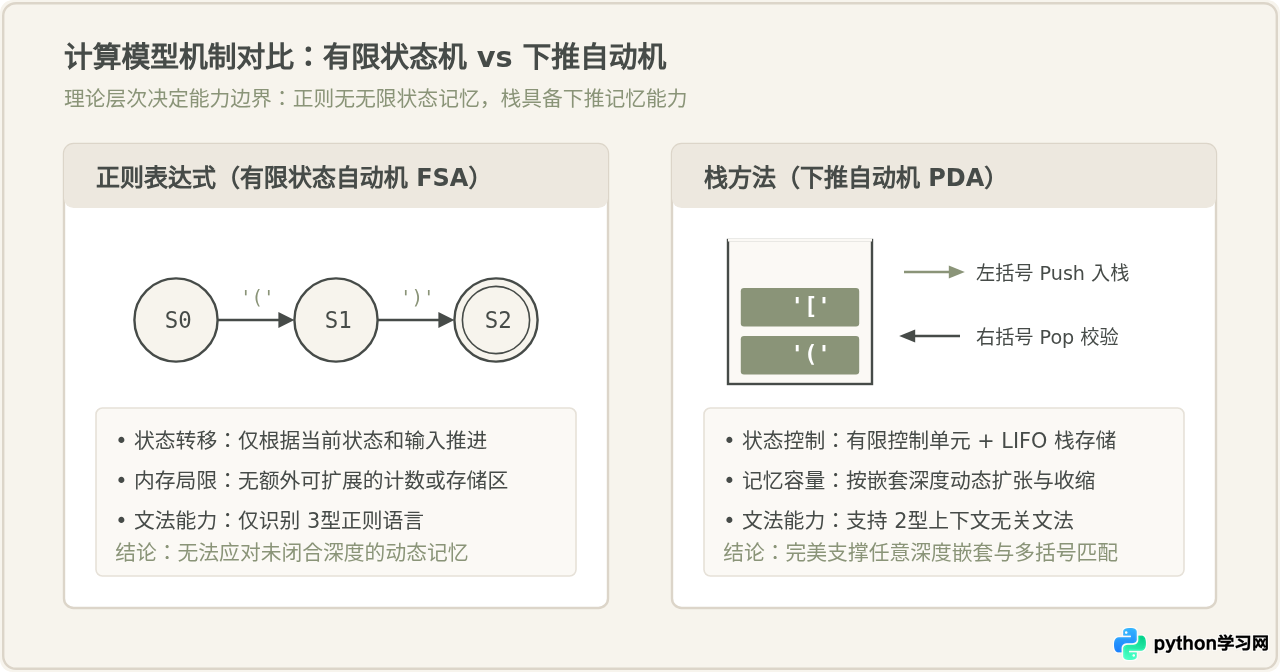
深入对比Python中使用栈方法与正则表达式匹配括号的机制差异、适用场景、实现代码与边界条件,解析任意嵌套匹配与单层扁平提取的技术选型。
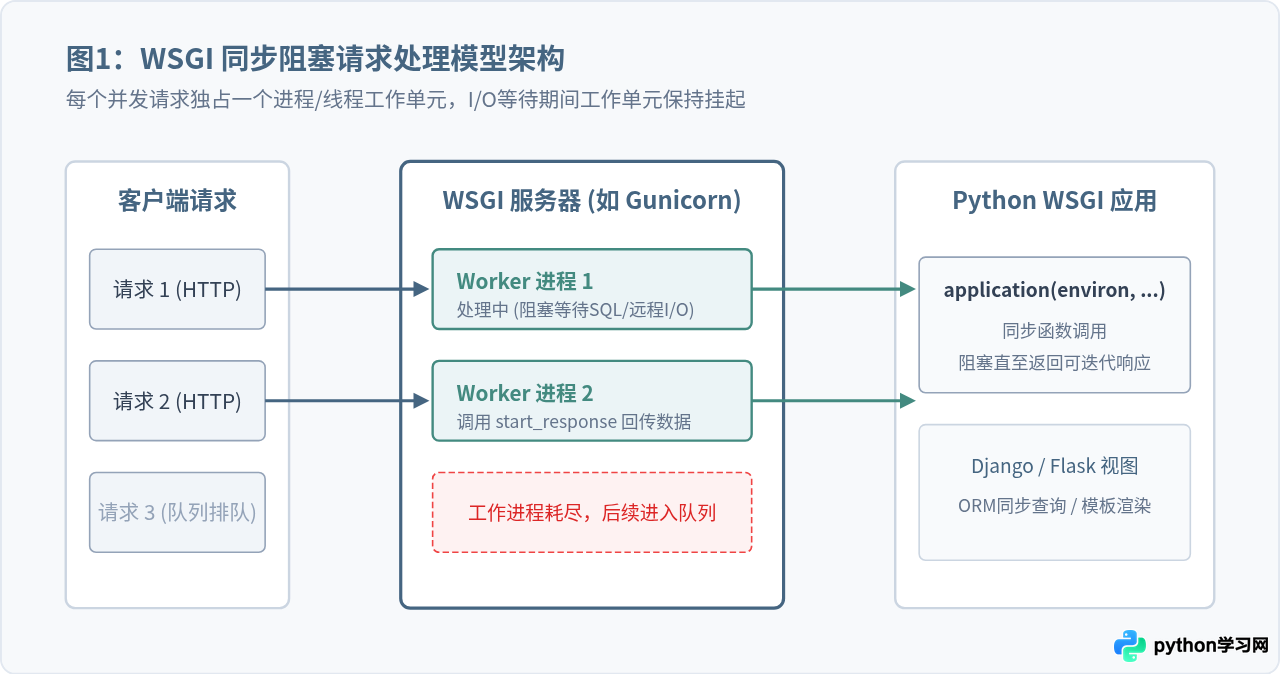
深入解析Python Web领域的WSGI与ASGI协议核心差异,对比同步阻塞与异步事件循环机制,并详细阐述两者对Gunicorn、Uvicorn等Web服务器选型与生产部署方案的影响。