MySQL流程控制函数IF()、IFNULL()、NULLIF()与ISNULL()详解
本文详细介绍了MySQL中四个关键流程控制函数的用法:IF()用于条件分支,IFNULL()处理空值替代,NULLIF()在相等时返回NULL,ISNULL()判断非空状态。通过具体SQL示例展示各函数参数结构与返回值逻辑,帮助开发者灵活应对数据清洗与查询场景。
2026-10-16
0
本文详细介绍了MySQL中四个关键流程控制函数的用法:IF()用于条件分支,IFNULL()处理空值替代,NULLIF()在相等时返回NULL,ISNULL()判断非空状态。通过具体SQL示例展示各函数参数结构与返回值逻辑,帮助开发者灵活应对数据清洗与查询场景。
本文详解 MySQL 中利用 RAND() 函数实现数据的随机抽取与批量更新。通过 ORDER BY RAND() LIMIT 语法可快速获取指定数量的随机记录;直接使用 UPDATE SET 字段=Rand() 即可一次性覆盖更新多行数据,避免低效循环。同时简要说明 RAND(seed) 的确定性用法及性能注意事项。
本文解析MySQL中回表现象的原理。对比聚簇索引与非聚簇索引(二级索引)在叶子节点存储数据的区别,解释为何使用非主键索引查询时需要额外通过主键值检索完整数据。结合B+树特性说明回表机制,并提供利用覆盖索引消除回表的优化方案。
本文介绍在SQL Server中通过变量构建并执行动态SQL语句的方法,涵盖表名、字段名等外部输入参数的处理。重点解析推荐的sp_executesql及其参数化输入输出优势,以及基础的exec命令拼接方式,并提供通用分页及条件查询的完整代码示例。
解决 SQL Server 处理大量数据时的性能瓶颈。本文介绍一个通用的分页存储过程 execByPage,通过动态生成带标识列的临时表,兼容原有 SQL 语句,无需修改应用层代码即可高效返回指定页数据及总记录数,避免游标和复杂 ID 依赖,显著提升大数据量查询速度。
本文解析 MySQL 中 COUNT(*)、COUNT(1) 和 COUNT(字段) 的性能差异。通过实验证明在 InnoDB 引擎下,COUNT(*) 与 COUNT(1) 效率几乎一致且最优,因为它们均会选择最小的辅助索引进行全表扫描计数;而 COUNT(主键字段) 需额外回表或判断 NULL 值,速度略慢。同时说明了 information_schema.TABLES_ROWS 仅作为估算值不可靠,并指出 InnoDB 基于 MVCC 无法像 MyISAM 那样直接存储行数。
详解Windows平台下MySQL ZIP Archive免安装压缩版的完整部署流程,包括解压规范、my.ini核心配置编写、mysqld手动初始化数据目录、Windows系统服务注册及初始密码修改与排错。
本文深入解析MySQL进阶查询技术,涵盖单行与多行函数的应用、GROUP BY分组与HAVING筛选的区别、LIMIT分页语法及执行顺序,详细演示WHERE/FROM子查询及内连接、左外连接和自连接的实现逻辑。通过具体代码示例,帮助开发者掌握高效的数据检索与关联分析技巧。
本文详细介绍如何在Docker容器中搭建PHP环境以运行Workerman框架,并配置MySQL 5.7和Redis服务。通过容器化部署,解决依赖安装、端口映射及远程访问设置等问题,确保GatewayWorker项目稳定运行。
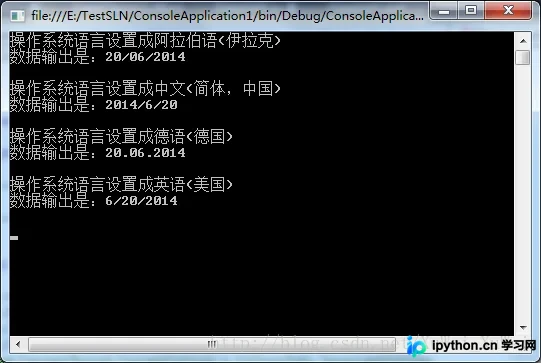
在C#开发中,CultureInfo类控制着数字、日期等数据的本地化显示。本文将通过代码示例展示不同文化设置下DateTime.Now输出的差异,并重点讲解如何利用Thread.CurrentThread.CurrentCulture和CultureInfo.InvariantCulture来解决跨地区服务器数据读取不一致的问题,确保机器间传输数据的稳定性。
面对MySQL千万级数据,直接使用LIMIT offset, size会导致严重的延迟。本文解析深层原因,提供基于主键自增的回表优化、区间查询及业务层游标分页等实战方案,显著提升大偏移量下的查询性能。
本文讲解 SQL Server 执行计划(Estimate vs Actual)的区别,通过 SSMS 快捷方式及 SET SHOWPLAN_XML 语句生成并保存为 .sqlplan 文件,利用内置比较工具分析性能瓶颈。