

MySQL回表查询原理解析:聚簇索引、二级索引与优化方法

回表是MySQL数据库查询中的常见性能瓶颈。由于聚簇索引与非聚簇索引在数据存储结构上的差异,使用非主键索引查询时往往需要额外的I/O操作来获取完整数据。本文将深入解析其背后的B+树存储原理,并介绍如何通过覆盖索引进行有效优化。
什么是聚簇索引与非聚簇索引
MySQL的索引按照物理存储方式主要划分为两类:聚簇索引(Clustered Index)和非聚簇索引(Non-Clustered Index)。理解这两者的关系是掌握回表机制的前提。
- 聚簇索引:即主键索引。InnoDB引擎要求表必须包含一个聚簇索引来定义数据的物理存储顺序。
- 非聚簇索引:又称辅助索引或二级索引(Secondary Index)。除聚簇索引外的所有其他索引均属于此类。
两种索引的区别与回表原理
聚簇索引与非聚簇索引在使用相同的B+Tree数据结构的同时,其叶子节点存储的内容存在本质区别:
- 聚簇索引叶子节点:直接存储一行完整的记录数据。
- 非聚簇索引叶子节点:仅存储该索引列对应的键值(Key)和主键值(Primary Key)。其中,主键值相当于一个书签(Bookmark),指向存储在聚簇索引中的数据行。
第1步:使用主键索引查询
当通过主键查找数据时,MySQL直接在聚簇索引的B+树中定位到叶子节点,即可获取全部数据。此过程无需再次访问数据行,不存在回表现象。
select * from user where id = 1;第2步:使用非主键索引查询
若查询条件涉及非主键字段(如姓名),查询流程分为两步:
第一步:在二级索引(如name列)的B+树中查找到匹配的主键值。
第二步:使用该主键值回到聚簇索引中查询,以获取其余列数据。这个“回到”聚簇索引的过程即为回表。
select * from user where name = 'Jack';相较于主键查询,非主键查询多执行了一次针对聚簇索引树的检索操作,增加了IO开销。
B+树的底层存储结构
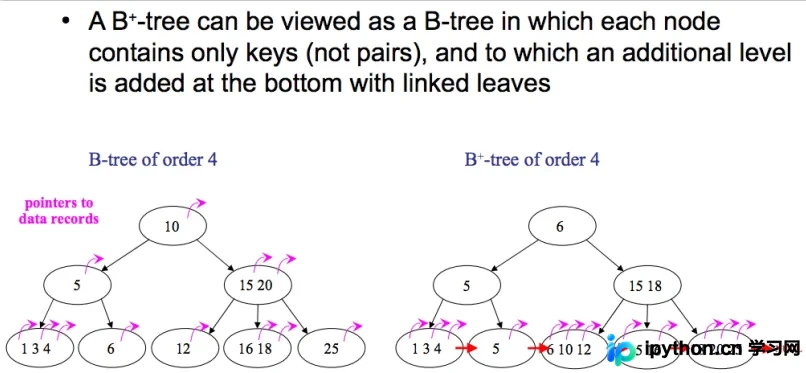
InnoDB采用B+树作为索引结构,其结构特点决定了上述查询效率的差异。B+树内部节点只存储键值用于导航索引路径,真正的记录指针集中存放在所有叶子节点中,且叶子节点之间通过双向链表连接,便于范围查询。
如何避免回表以提高查询效率
在业务允许的情况下,可以通过覆盖索引(Covering Index)来避免回表。
所谓覆盖索引,是指查询所需要的全部数据字段都包含在索引列中。当命中覆盖索引时,MySQL只需遍历索引树即可返回结果,无需“回到”聚簇索引去读取数据行。此外,对于部分常用字段,可以采用复合索引的方式,将多个查询条件纳入同一个索引中,同样可以达到减少回表次数甚至完全避免回表的效果。
以上就是MySQL回表查询原理解析与优化方法的详细内容,更多关于MySQL数据库性能优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









