深入理解C语言数组下标为何从0开始:底层寻址机制解析
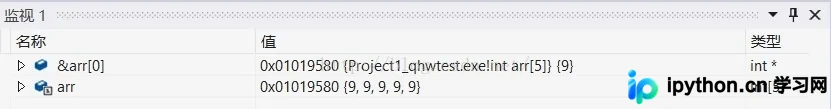
本文通过Visual Studio反汇编分析,揭示C语言数组下标从0开始的根本原因。对比基于基址加偏移量(Base + Index*Size)的0起始寻址与需要额外减法操作的1起始寻址,证明0起始设计消除了不必要的算术运算,显著提升了CPU在内存访问时的效率。这种设计体现了计算机体系结构对执行性能的追求,是理解C语言高效性的关键细节。
2026-10-16
0
本文通过Visual Studio反汇编分析,揭示C语言数组下标从0开始的根本原因。对比基于基址加偏移量(Base + Index*Size)的0起始寻址与需要额外减法操作的1起始寻址,证明0起始设计消除了不必要的算术运算,显著提升了CPU在内存访问时的效率。这种设计体现了计算机体系结构对执行性能的追求,是理解C语言高效性的关键细节。
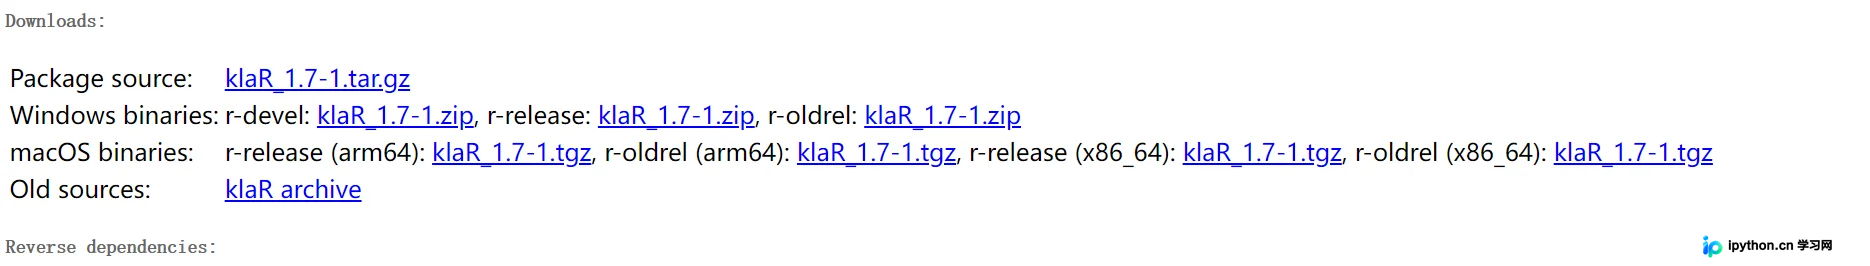
在R语言进行机器学习开发时,常因版本兼容性问题需要手动升级或降级特定包。以解决klaR包报错为例,详细介绍如何通过CRAN Archive安装历史版本,包括卸载旧包、指定tar.gz源码路径及重新安装的全过程,确保模型训练环境稳定。
在开发中,PHP 等弱类型语言可无需声明结构直接读写深层嵌套数据,而 Go 等强类型语言需逐层断言赋值。本文通过对比两种语言的差异,介绍使用 databox 库如何通过类似路径的方式实现 Go 对 PHP 动态数组特性的兼容读写,提供实际代码操作说明。
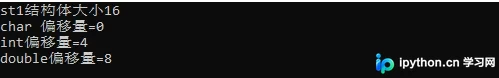
本文详细解析了C++结构体的内存对齐机制,包括对齐模数、成员偏移量计算及结构体大小填充规则。通过VS2019环境下的# pragma pack指令实验,验证了不同对齐设置对内存占用的影响,并证明了优化成员排列顺序可有效节省空间。
文章深入解析MySQL中索引的概念、作用及适用场景,详细列出无法利用索引的查询条件。通过转账案例讲解事务(Transaction)的重要性,阐述其四大特性(原子性、一致性、隔离性、持久性),并演示使用start transaction、commit和rollback语句进行数据库操作的实际流程。
本文深入对比Python中列表与集合的性能差异。通过大O渐进表示法解析时间复杂度,实测发现集合在大数据量查找上远快于列表,但需以更高的内存空间为代价。文章提供具体代码示例与getsizeof测试结果,帮助开发者根据数据规模合理选择数据结构。
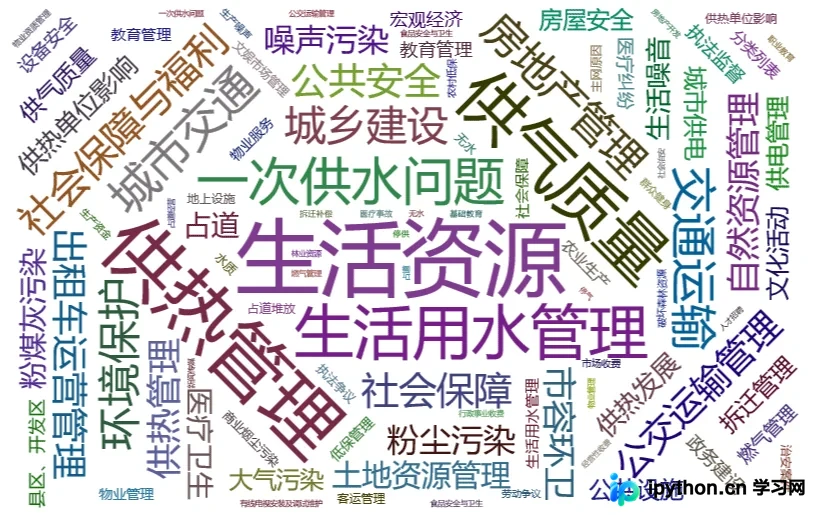
本文介绍如何使用Python库pyecharts绘制词云图。通过调整shape参数可改变轮廓,支持自定义文字样式。文章提供了从基础数据输入到结合jieba进行智能分词的一键生成案例,帮助读者快速掌握词云可视化的核心技巧。
本文深入解析Python函数中形式参数与实际参数的区别,以及值传递和引用传递的工作机制。通过对比字符串等不可变类型与列表等可变类型的传递行为,阐明形参修改对实参的影响差异,帮助开发者理解Python对象引用的底层逻辑。
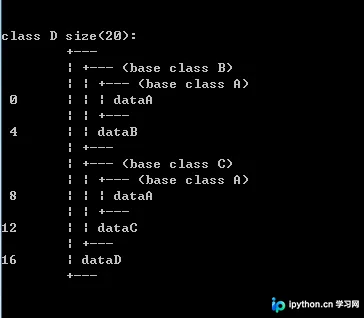
本文通过Visual Studio命令选项深入剖析C++普通多继承与虚继承的内存差异。重点解释菱形继承中vbptr指针的作用机制,展示编译器如何通过虚基类表偏移量确保唯一基类实例,解决数据冗余问题并提供相关验证代码。
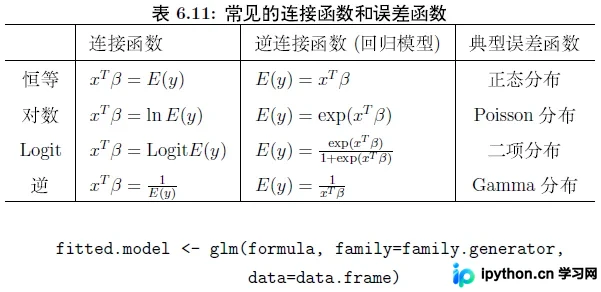
本文介绍如何使用R语言的glm()函数拟合广义线性模型(GLM)。通过解析family参数中的正态分布与二项分布,重点演示了Logistic回归在二元分类问题中的应用。结合电流对动物影响的实际案例,展示了数据准备、模型构建、预测概率计算及可视化绘制的完整流程。
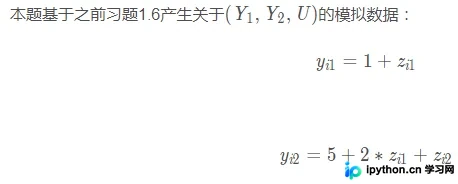
本文通过R语言模拟实验,探讨缺失数据场景下Bootstrap和Jackknife两种重抽样方法的差异。结果显示,直接对原始含缺失数据进行插补后重抽样会引入较大偏差;而在每次重抽样的子样本中独立进行线性插补,能显著降低估计误差,90%置信区间的覆盖次数更多,结果更可靠。
本文深入解析OpenCV中的图像标注技术,涵盖边界框、多边形分割及语义分割等核心方法。通过Python代码示例,详细演示如何使用cv2模块手动绘制直线、圆形和矩形边界框,并基于K近邻(KNN)算法实现图像颜色分割,为机器学习模型训练提供高质量标注数据。