

R语言实现广义线性回归模型:从原理到Logistic实操

广义线性模型是处理连续和离散响应变量统计建模的核心方法。本文基于R语言的 glm() 函数,详解如何通过指定不同的 family 族参数来适配正态分布与二项分布,并深入剖析 Logisitic 回归在分类问题中的代码实现、预测与可视化技巧。
广义线性模型的三大核心要素
广义线性模型(Generalized Linear Model, GLM)扩展了传统的正态线性模型,使其能够适用于属性数据和计数数据等离散情形。一个完整的 GLM 包含以下三个关键组成部分:
- 线性自变量:响应变量的期望值 $E(y_i)$ 仅依赖于线性预测器 $eta^T x_i$。其中 $eta$ 为未知参数向量。
- 连接函数:建立线性自变量与期望值 $E(y_i)$ 之间关系的单调可微函数,实现了非线性转换。
- 误差结构:假设观测值服从指数型分布族中的某一特定分布(如正态、泊松或二项分布),不再局限于正态误差假设。
R中glm()函数的关键参数
在 R 软件中,glm() 是拟合广义线性模型的标准函数。其基本语法结构如下:
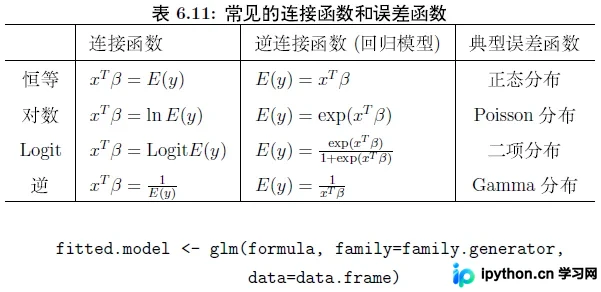
使用时需关注三个核心参数:
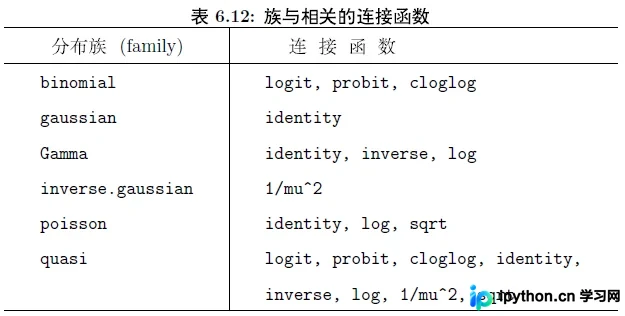
formula:定义模型的数学公式,格式与标准线性模型相同。family:最关键参数,用于指定误差分布族及其默认的连接函数。例如gaussian(正态)、Poisson(泊松)、binomial(二项)等。data:包含建模所需变量的数据框。
不同的分布族对应特定的连接函数(Link Function),常见的映射关系如下:
主要分布族的实际应用
正态分布族(高斯过程)
当响应用量为连续数值且误差近似正态时,使用正态分布族。其代码表示极为简洁:
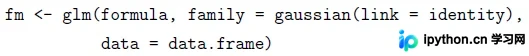
由于正态分布族的默认连接函数为恒等变换(identity),因此 link = identity 通常省略。此外,若未显式指定 family 参数,R 默认即采用高斯分布。值得注意的是,此时的 GLM 计算结果与直接使用标准线性模型 lm() 完全一致,但效率略低,通常在非正态数据时才建议使用 GLM 框架。
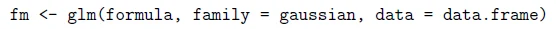
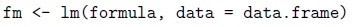
二项分布族与 Logistic 回归
当响应变量为二分类结果(如成功/失败、0/1)时,正态模型不再适用。此时应选用 binomial 族,默认的 logit 连接函数即构成了 Logistic 回归模型:
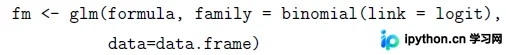
实操案例:电流强度对农场动物的影响
为了直观展示 Logistic 回归的应用,我们引入 R. Norell 的经典实验数据。该研究旨在分析不同强度的电流对 7 头小型牲畜嘴巴运动反应的影响。
第1步:数据准备与构造
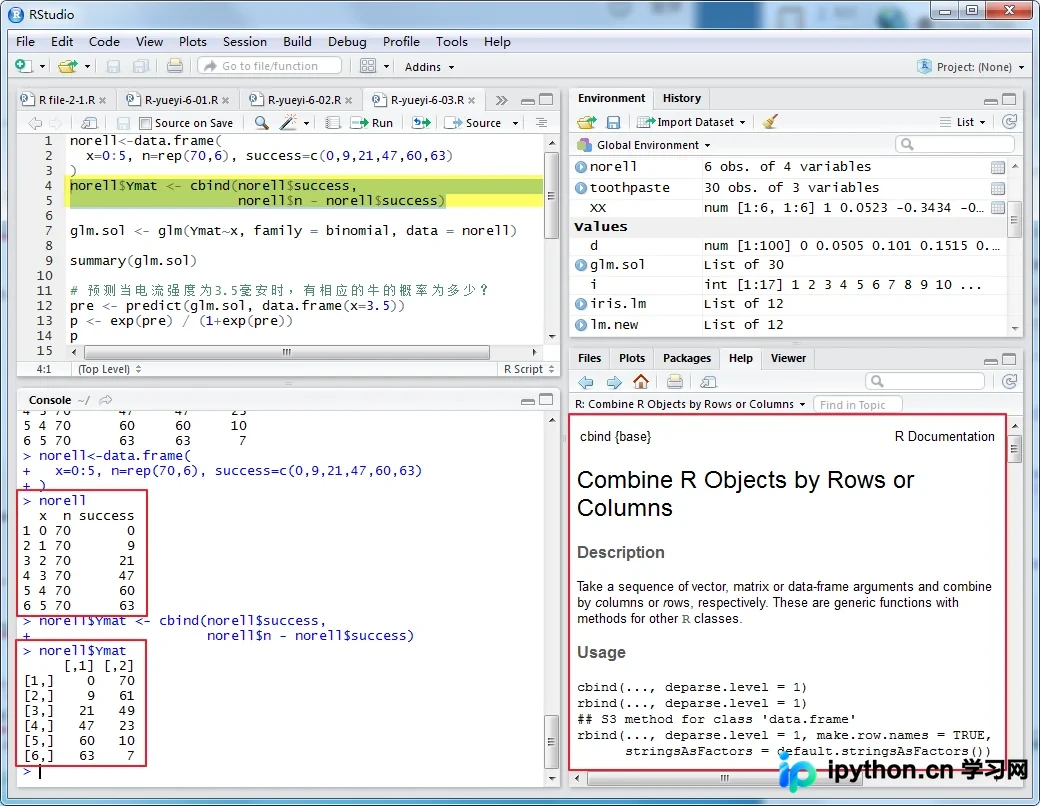
实验设置了 0-5 毫安共 6 种电流强度,每种强度重复多次。对于每个电流点,记录出现反应(成功)的次数和不出现反应(失败)的次数。在 R 中,我们通过构建矩阵并将其转为数据框来录入这种聚合数据:
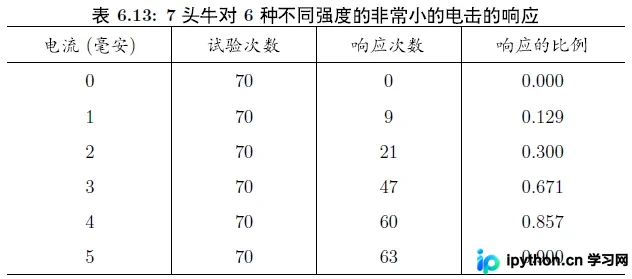
生成包含“成功次数”、“失败次数”与“电流强度”的数据框对象:
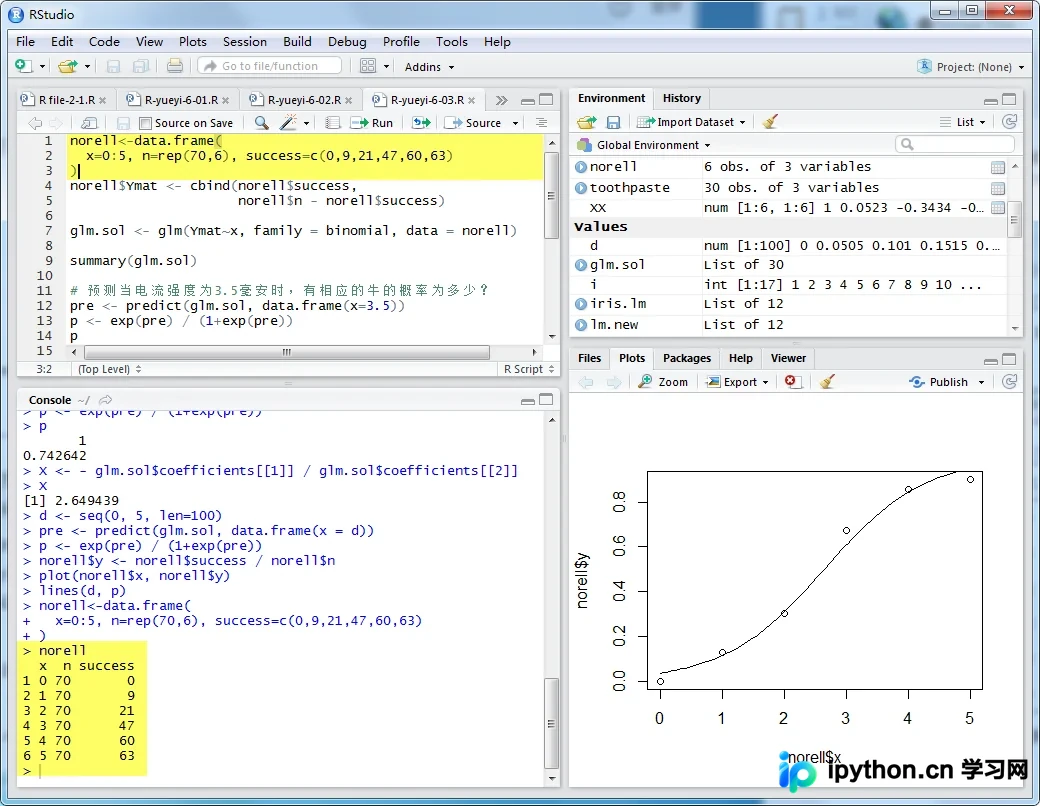
验证数据结构以确保无误:
第2步:构建与拟合 Logistic 模型
利用 cbind(成功, 失败) 的公式形式调用 glm(),设定 family = binomial:
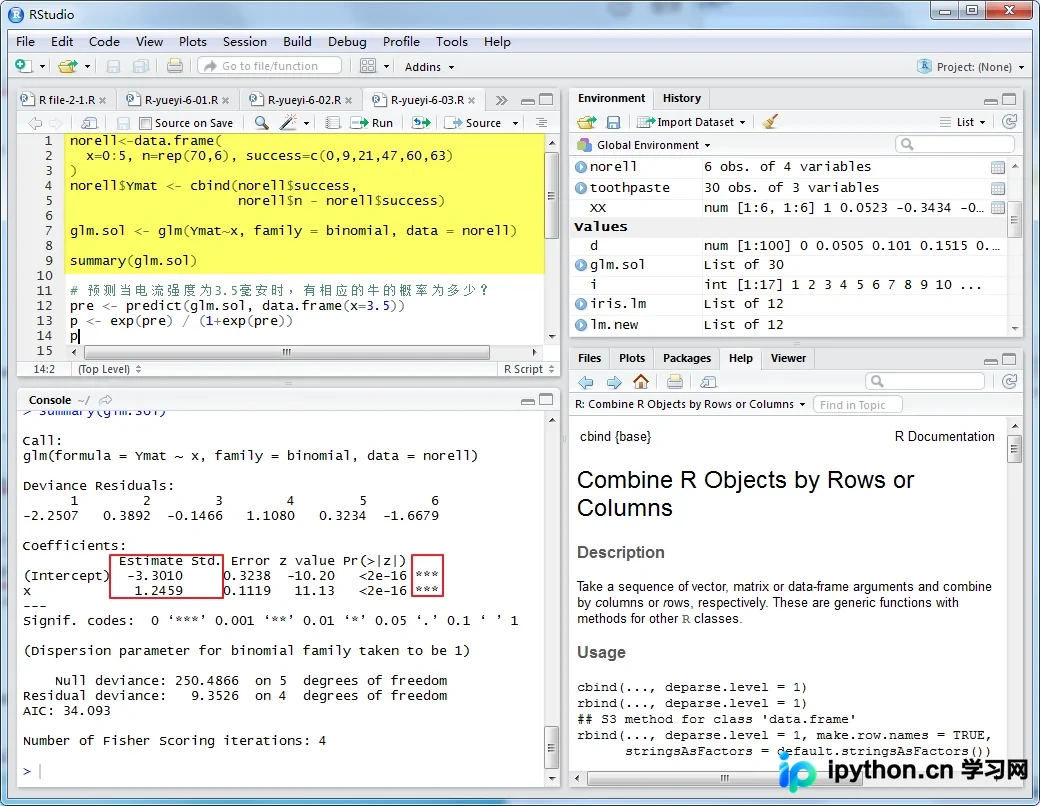
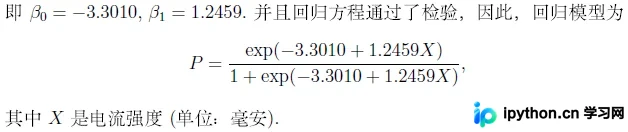
查看模型生成的系数及诊断信息,确认显著性:
第3步:模型预测与控制分析
模型建立后,即可进行概率预测。例如,预测电流强度为 3.5 毫安时的反应概率:
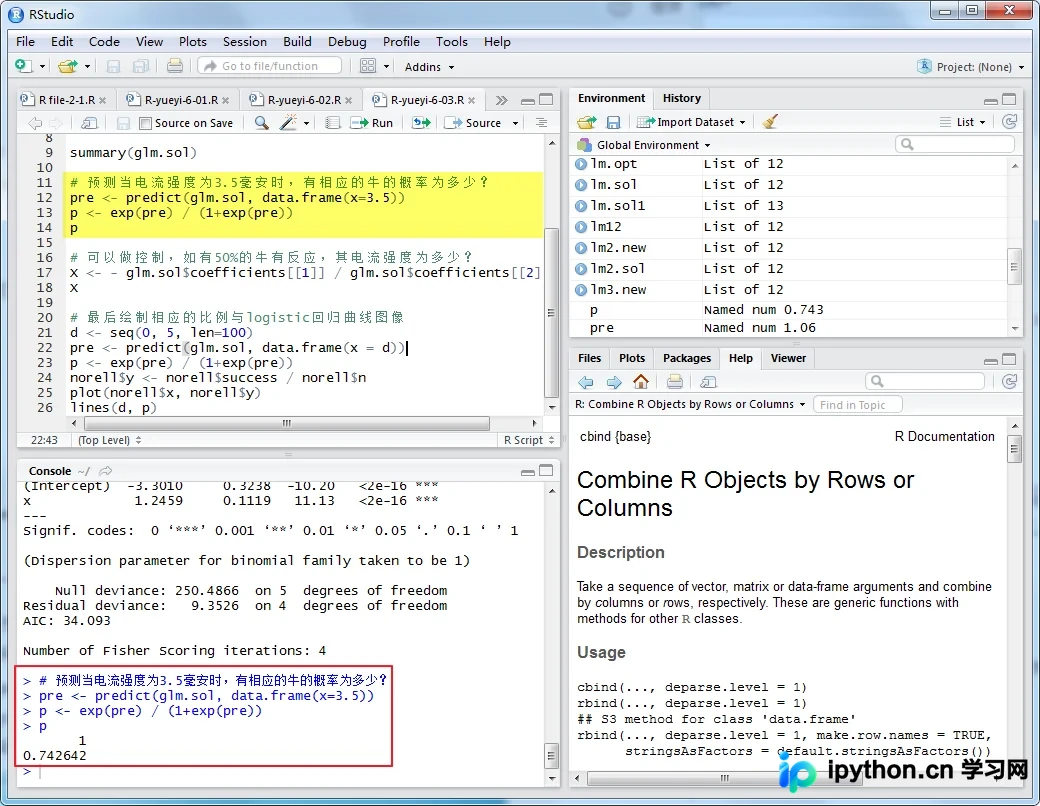
计算结果显示,在该电流下产生反应的概率约为 74.26%。
反之,若要找到使 50% 牲畜产生反应的临界电流强度,可解逆方程得出:
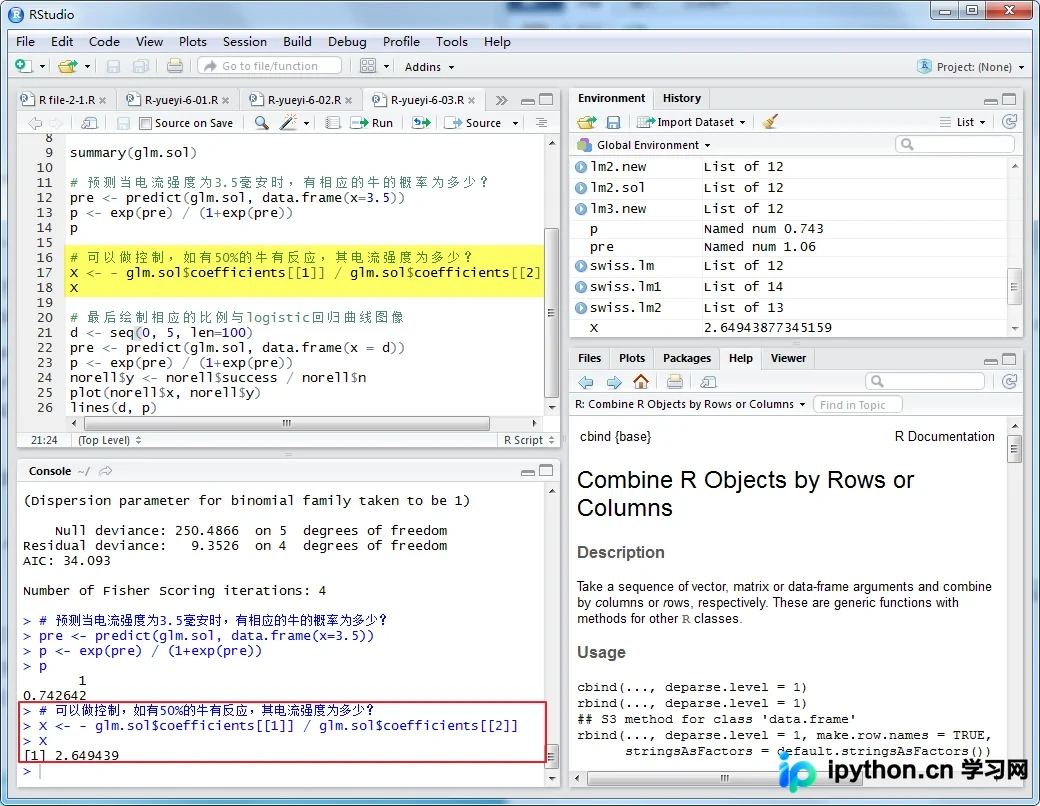
结果表明,约 2.65 毫安 的电流会导致半数个体出现响应。
第4步:结果可视化
通过绘制观测比例与拟合曲线的对比图,可以直观评估模型效果。以下代码生成了散点图及 Logistic 拟合曲线:
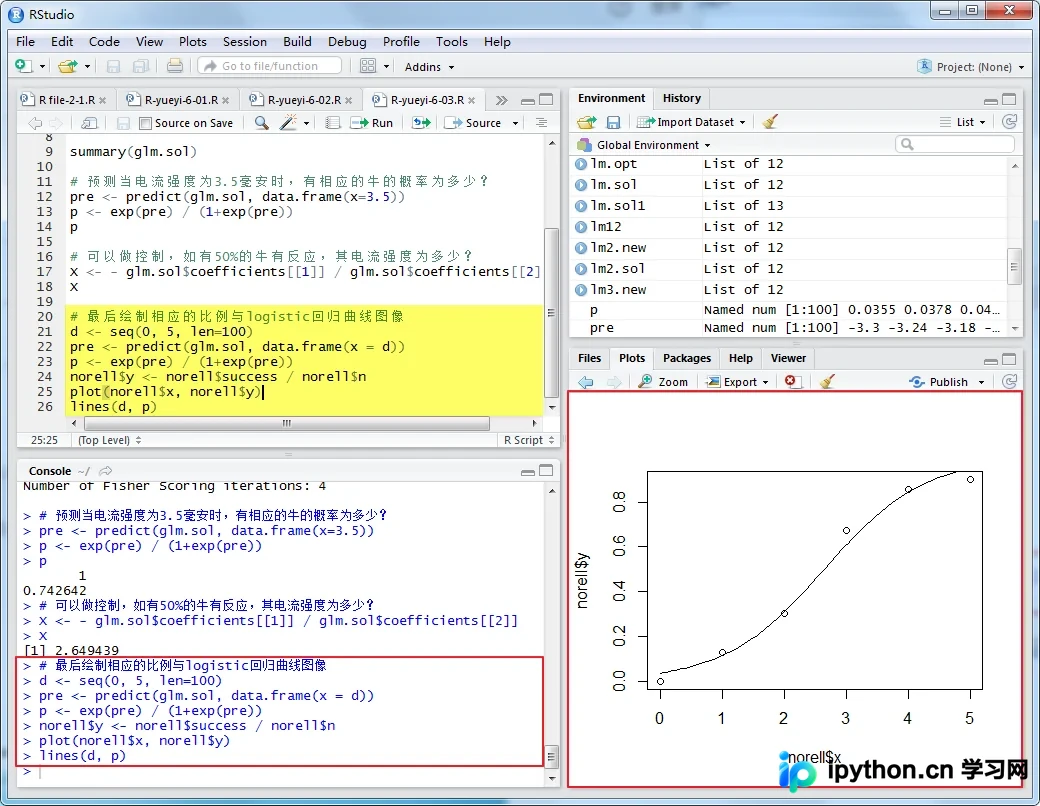
图中横坐标代表电流强度,纵坐标代表观察到的反应比例;叠加的线条即为根据模型计算出的理论预测概率曲线,二者吻合度越高说明模型表现越好。
以上就是 R 语言实现广义线性回归模型的详细内容,更多关于 R语言 广义线性回归模型的内容请搜索本站以前的文章或继续浏览下面的相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









