Pandas DataFrame.sample() 随机抽样详解与实战
本文详细介绍Pandas中DataFrame.sample()函数的使用方法,涵盖n、frac、replace、weights、random_state等核心参数的配置。通过具体代码示例演示如何按行数、比例或权重进行随机抽样,并解析axis方向控制及结果复现技巧,帮助开发者高效实现数据子集提取。
2026-10-15
0
本文详细介绍Pandas中DataFrame.sample()函数的使用方法,涵盖n、frac、replace、weights、random_state等核心参数的配置。通过具体代码示例演示如何按行数、比例或权重进行随机抽样,并解析axis方向控制及结果复现技巧,帮助开发者高效实现数据子集提取。
本文详解pandas中concatenate和combine_first的用法。concatenate用于拼接Series和DataFrame数据,支持指定轴方向;combine_first利用第二个对象填充第一个对象的缺失值。通过numpy和pandas代码示例,展示具体操作及返回结果类型。
本文详细介绍Python pandas库中apply函数的使用方法。涵盖其基本语法、axis参数对行列处理的影响,以及result_type等高级选项。通过DataFrame和Series的实际案例,演示如何结合lambda表达式、自定义函数及args/kwargs参数进行批量数据处理,帮助开发者高效实现数据转换与聚合。
本文详细介绍Python中Pandas库的核心数据结构Series和DataFrame。通过具体代码示例,演示如何利用标量、字典、Ndarray等数据源创建Series,以及如何基于字典、Series和二维数组构建DataFrame,帮助开发者快速掌握Pandas基础操作。
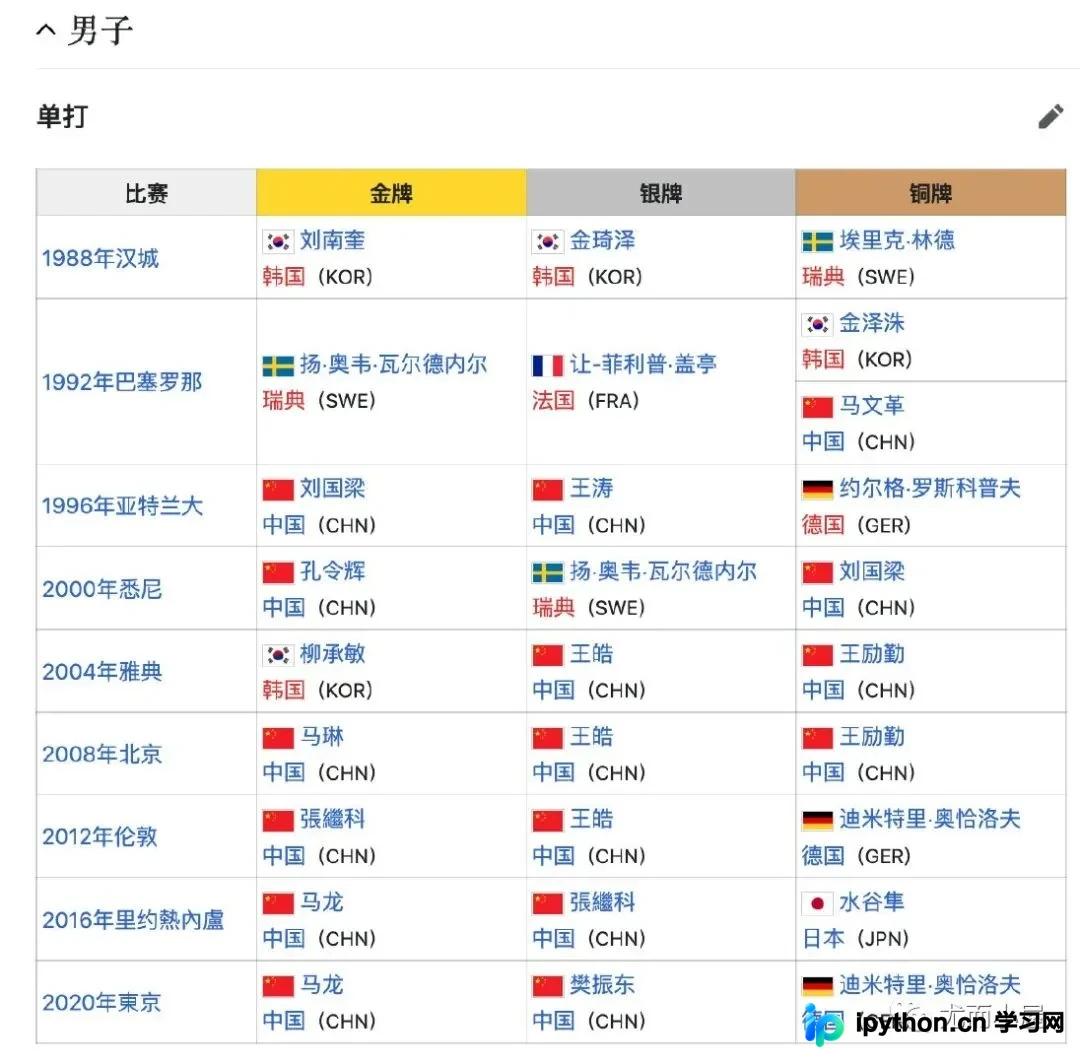
本文详细介绍Pandas中两种高效的数据读取方式:利用read_html直接解析网页表格,以及通过read_clipboard快速导入剪贴板数据。文章涵盖在线HTML与CSV文件的读取技巧,并提供具体代码示例与操作注意事项,帮助开发者简化数据获取流程。
本文详细介绍在Python数据分析中处理重复值的常用方法。通过Pandas库的duplicated()函数识别重复数据,利用sum()统计重复行数,并使用drop_duplicates()函数高效删除重复行。文章包含具体代码示例与常见错误排查,帮助开发者快速掌握数据清洗技巧。
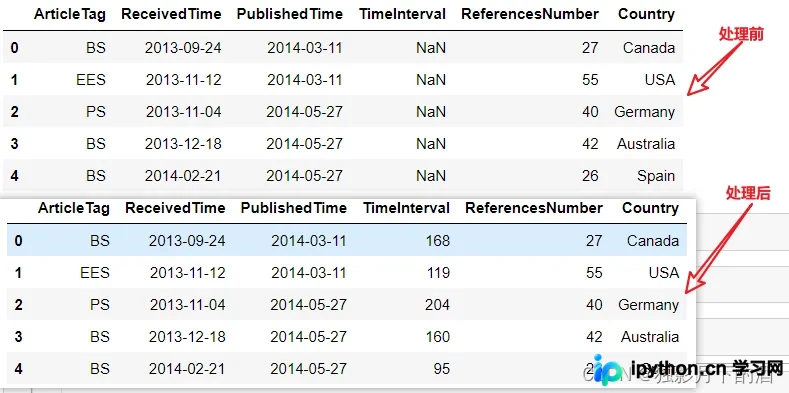
本文总结了在Pandas中批量替换字符的六种常用方法,包括map、replace、apply等函数的具体应用。通过实际代码示例,详细演示了如何将编码列批量转换为特定文本,帮助开发者高效完成数据清洗任务。
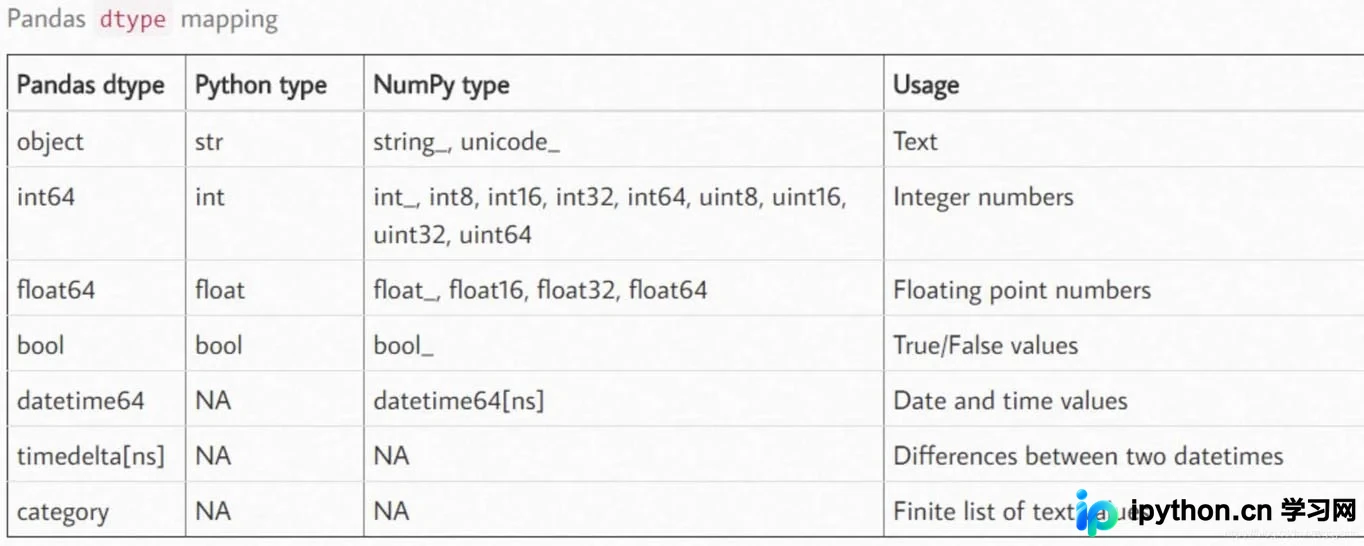
本文详细介绍Pandas中astype()函数的用法,涵盖基础类型转换、处理非标准数据格式(如含百分号的字符串)以及加载时指定类型。通过示例解析如何安全地将数值、字符串及时间类型进行转换,并指出转换失败时的处理策略,帮助开发者高效进行数据清洗。
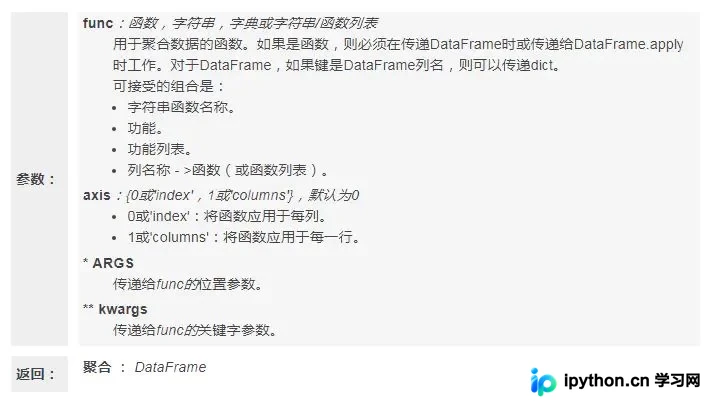
本文详细介绍pandas中DataFrame.agg()聚合函数的使用方法。通过对比numpy聚合函数,解析func参数的多种格式(函数、列表、字典),并演示如何在指定轴上执行单个或不同列的多重聚合操作,包括处理NaN填充的逻辑。
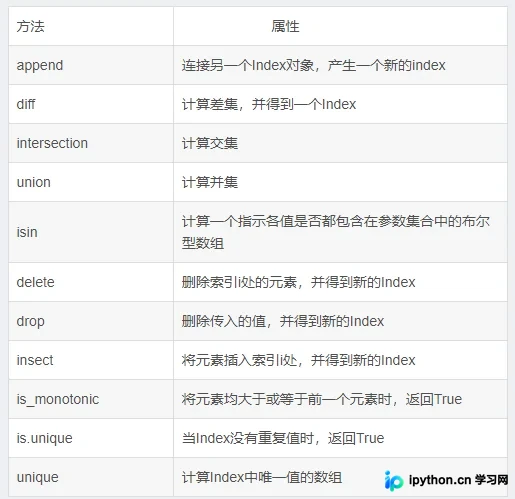
本文深入解析 Python Pandas 库中的三大核心数据结构:Series、DataFrame 和 Panel。详细讲解 Series 的一维数组特性、索引与标签的双重访问机制,以及基于字典和列表的创建方法。同时阐述 DataFrame 的表格型结构、列对齐与缺失值处理,并介绍 Index 对象的不可变性与常用属性查看方法,帮助开发者掌握 Pandas 数据处理基础。
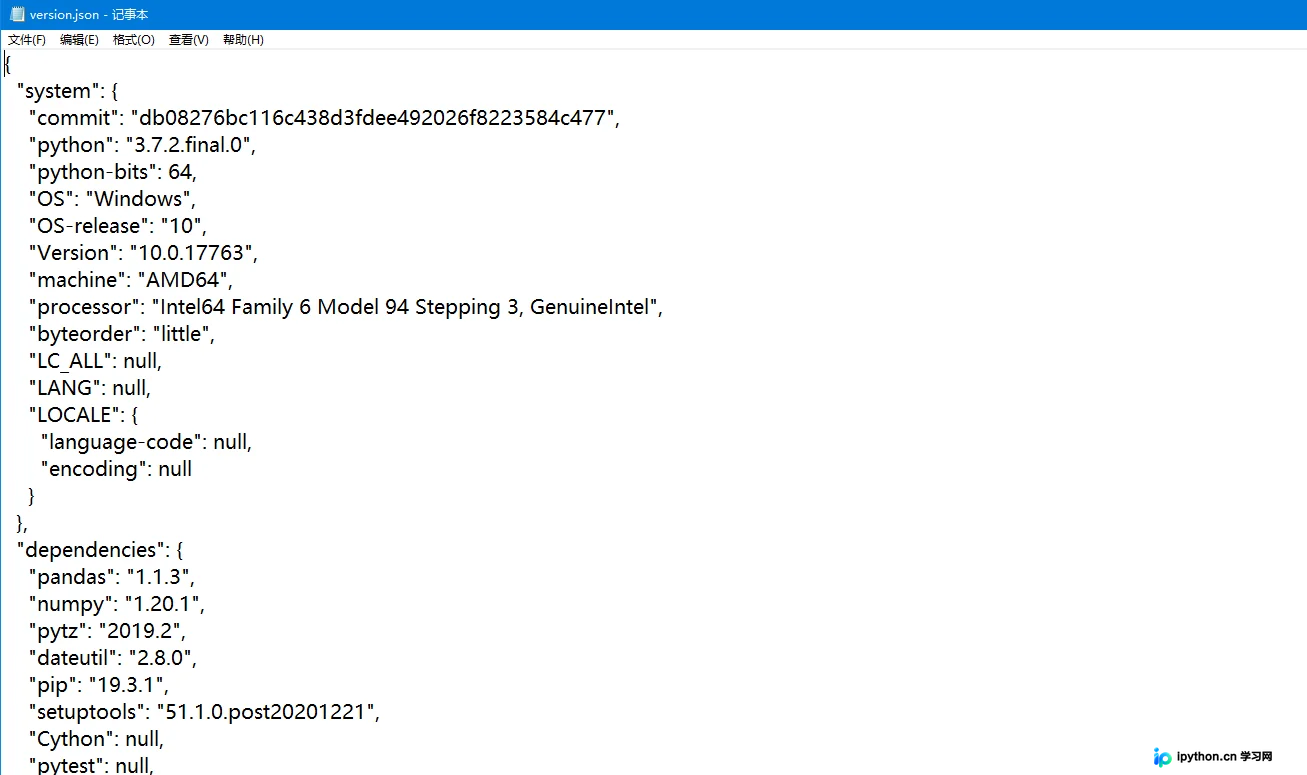
本文深入解析pandas中查看库版本及依赖信息的四个核心API:__version__、__git_version__、_version.get_versions()及show_versions()。通过剖析pandas._version模块与__init__.py源码,阐明版本信息的存储机制、命名空间重构过程及show_versions()在不同参数下的输出逻辑,帮助开发者理解版本检查背后的实现原理。
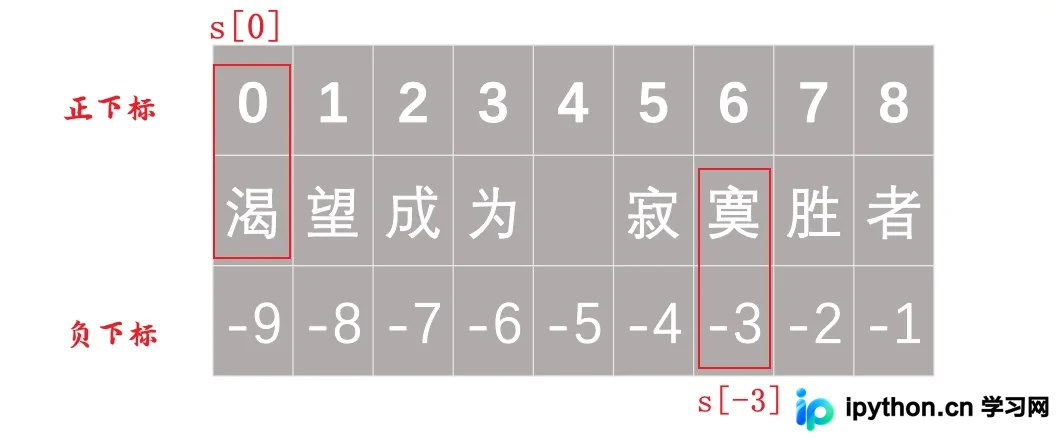
本文详细解析Python Pandas库中iloc与loc两种切片方法的实现机制。文章首先阐述含正负号下标的切片规则,随后对比iloc基于整数位置与loc基于标签索引的核心区别。通过具体代码示例,演示如何利用两者提取指定行、列、全表数据,以及基于条件的行筛选操作,帮助开发者准确掌握数据选取技巧。