Python读取Excel生成折线图的完整步骤与参数详解
本文详细介绍使用Python的pandas和matplotlib库读取Excel文件并绘制折线图的完整流程。涵盖从环境配置、库安装到代码实现的每一步,重点解析数据读取、绘图参数设置(如颜色、标记、线宽)及图表美化技巧,帮助开发者快速掌握数据可视化基础。
2026-10-16
0
本文详细介绍使用Python的pandas和matplotlib库读取Excel文件并绘制折线图的完整流程。涵盖从环境配置、库安装到代码实现的每一步,重点解析数据读取、绘图参数设置(如颜色、标记、线宽)及图表美化技巧,帮助开发者快速掌握数据可视化基础。
本文介绍了在C#环境中如何利用NPOI库实现Excel与DataSet之间的互操作。涵盖从.xls和.xlsx文件解析数据到内存对象,以及处理列名识别、数据类型转换(如时间格式),同时将数据集反向导出为Excel文件的完整代码实现。
本文介绍如何利用Python的pdfplumber库实现PDF文件中表格数据的批量提取并转换为Excel格式。通过示例代码演示了从单文件到多文件夹的处理流程,解决了WPS付费及手动操作耗时的问题,提供高效的数据处理方案。
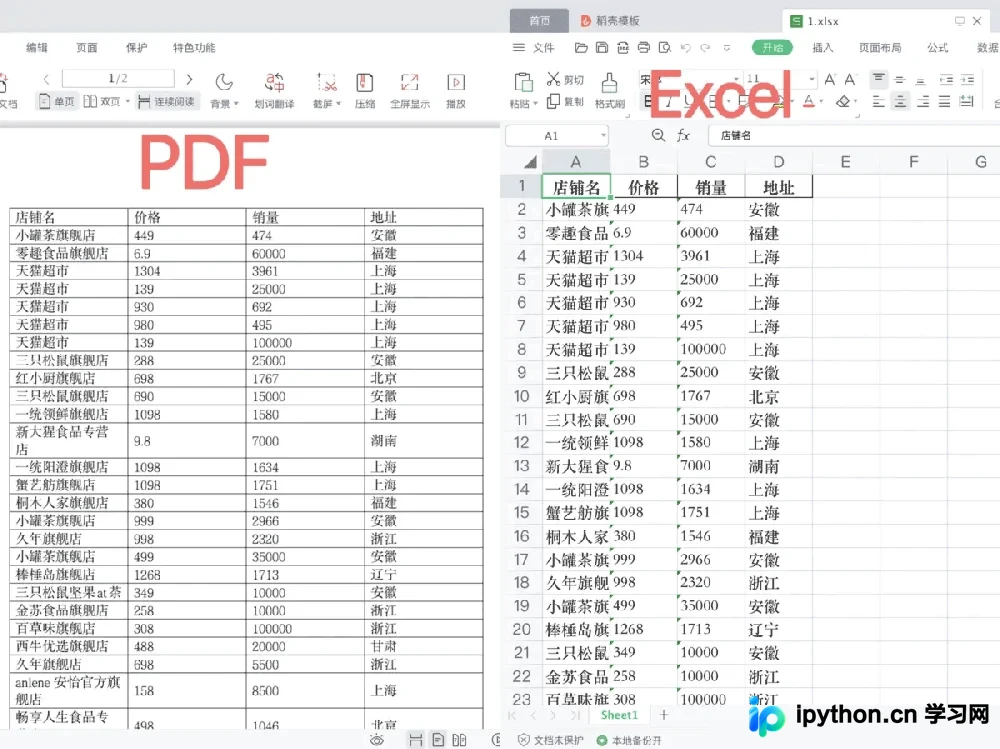
本文详细介绍在C#中将Excel(.xls和.xlsx)数据读取并转换为DataTable的两种主流实现方式。通过NPOI库处理旧版.xls格式,以及利用OpenXML SDK处理新版.xlsx格式,分别提供完整的代码示例、关键参数说明及注意事项,帮助开发者解决文件格式兼容与数据表结构映射问题。
本文详细介绍了在C#中将DataTable数据导出为Excel文件的两种常见实现方案。第一种基于商业组件Aspose.Cells,支持直接保存并自定义单元格样式、边框及对齐方式,适合对格式有较高要求的场景;第二种基于开源库NPOI(HSSF),通过遍历处理数据行并按65536行限制分Sheet存储,适用于需要兼容旧版.xls格式的批量数据处理。两者均提供了完整的代码示例以供参考。
本文总结了使用Pandas处理Excel文件时常见的Sheet相关问题,包括如何一次性写入多个Sheet、向已存在文件追加Sheet,以及覆盖特定Sheet而不影响其他Sheet的正确操作方法。通过示例代码展示了ExcelWriter类的使用及openpyxl引擎的配置,解决了自动重命名和顺序错乱等问题。
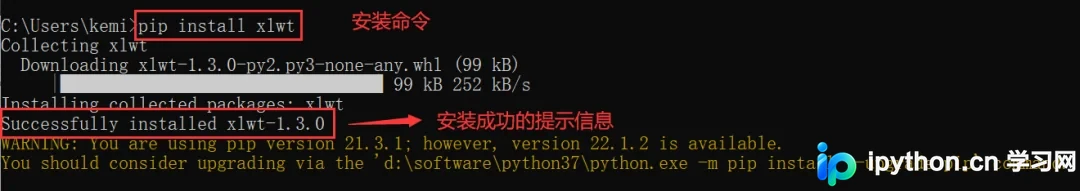
本文详解Python处理Excel的三大常用库:xlwt、xlrd和openpyxl。涵盖安装方法、读写步骤及完整代码实现,重点讲解如何创建、修改和读取.xls与.xlsx文件,适用于数据自动化处理场景。
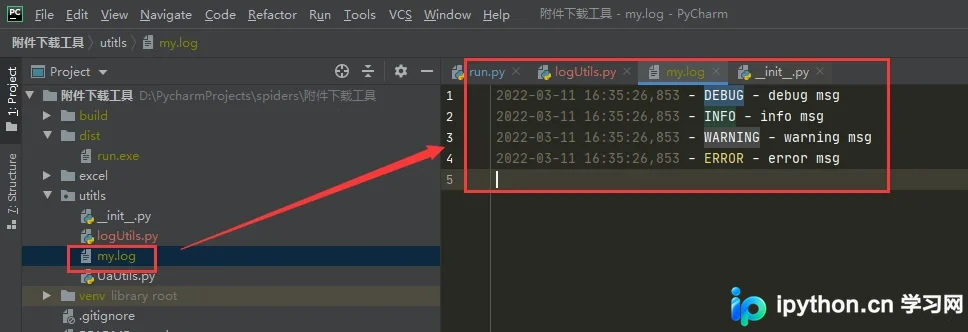
本文介绍如何使用Python和pandas编写命令行脚本处理Excel文件。内容包括封装logging日志模块、接收操作目录、检测并读取唯一Excel文件、自动备份、异常处理、动态添加列以及进度展示与阶段保存等实用技巧,帮助开发者高效完成数据批量处理任务。
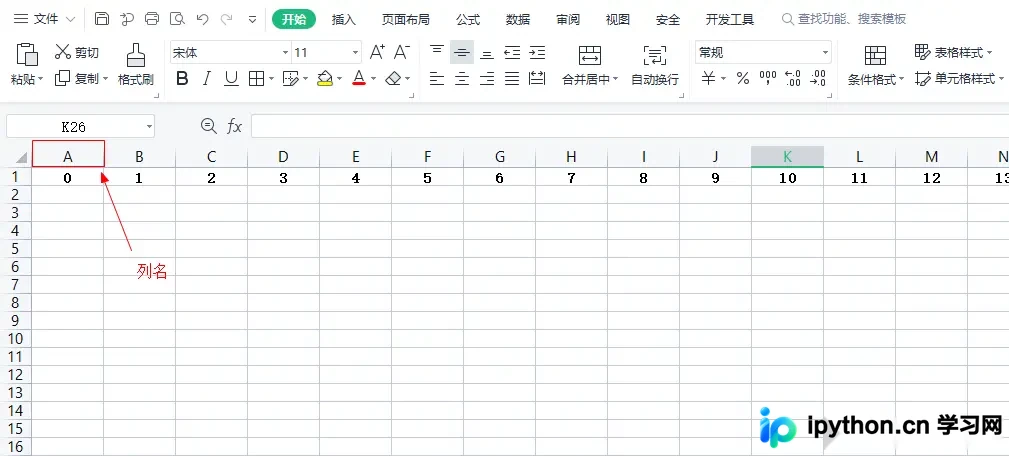
在开发涉及表格数据处理的应用时,常需将Excel的字母列名(如A, Z, AA)与数字索引进行互换。本文分享基于26进制原理的JavaScript纯函数实现代码,包含从列名获取序号及逆向生成的完整逻辑,支持跨语言移植与通用场景应用。
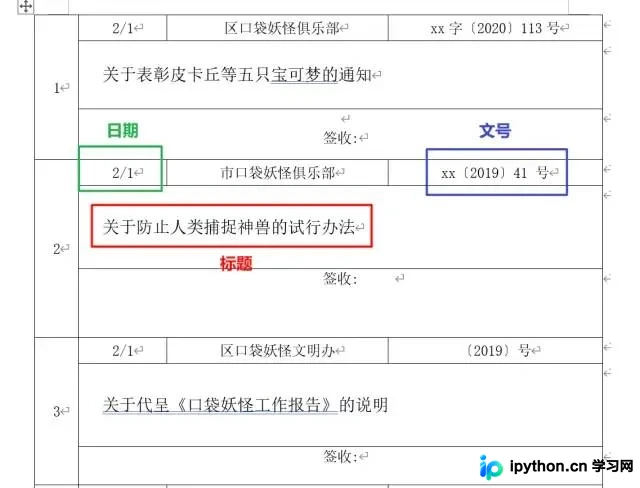
本文介绍如何利用Python脚本批量处理Word文档中的表格数据,自动提取日期、标题和文号等关键信息并导出为标准格式的Excel文件。通过解析docx表格结构、处理日期格式转换及异常捕获,实现高效的数据整理,替代繁琐的手动复制操作,适用于公务员及行政办公场景。
本文总结了14个使用Python Pandas库实现的Excel常用操作,涵盖关联查询、数据透视、差异对比、去重、缺失值处理、多条件筛选、模糊匹配、分类汇总、条件计算、空格去除、数据分列、异常值替换、分组统计及业务标签定义。通过具体代码示例,展示如何用Python高效完成日常数据处理任务,帮助读者巩固Python技能并提升数据处理能力。
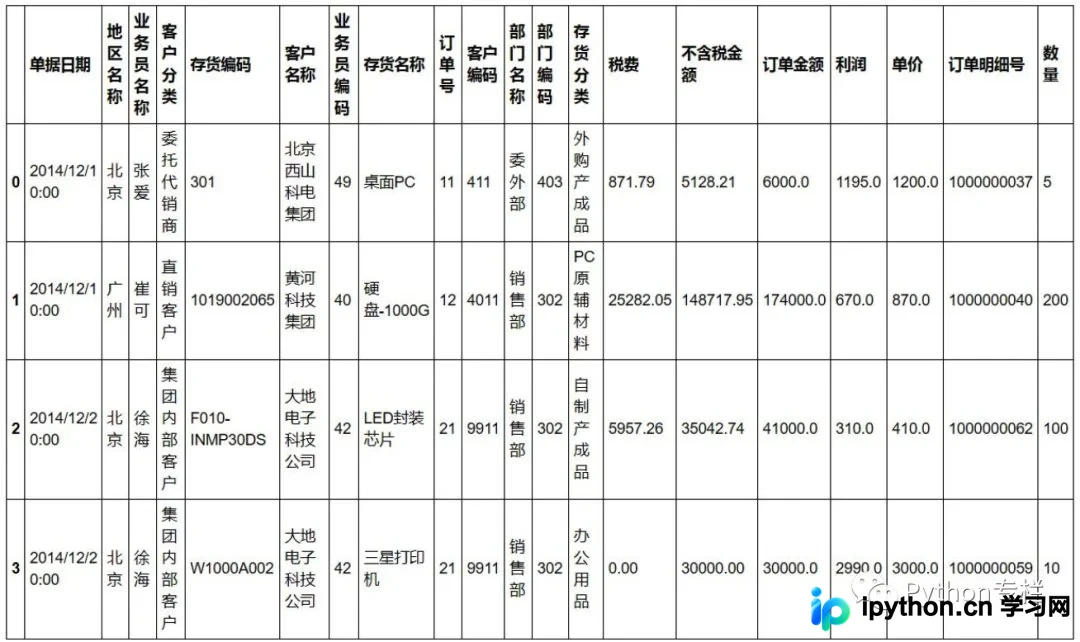
本文详解如何利用Python的Pandas库高效处理包含多个Sheet的Excel文件。通过sheet_name=None参数一次性读取所有工作表,遍历字典对象进行数据清洗(如新增列),并使用ExcelWriter将处理后的多份数据批量写入新Excel文件的对应Sheet中,实现自动化数据处理流程。