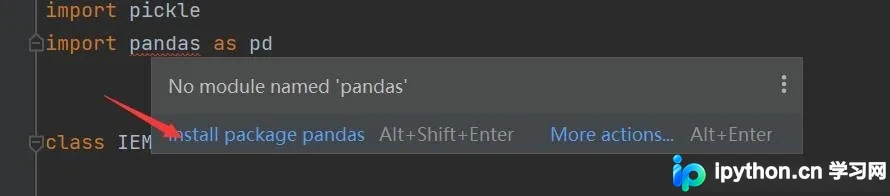
pandas实现数据合并的示例代码
本文详细介绍pandas中实现数据合并的四种核心方法:concat、merge、join和append。重点解析concat函数的axis、join、ignore_index等参数,merge的on、how、suffixes配置,以及join与merge在连接轴和数量上的差异,配合代码示例帮助快速掌握数据合并技巧。
2026-10-15
0
本文详细介绍pandas中实现数据合并的四种核心方法:concat、merge、join和append。重点解析concat函数的axis、join、ignore_index等参数,merge的on、how、suffixes配置,以及join与merge在连接轴和数量上的差异,配合代码示例帮助快速掌握数据合并技巧。
本文探讨NumPy中强制类型转换的机制,重点分析整数数组赋值浮点数时的隐式截断风险。通过示例演示如何正确使用dtype查看类型,并利用astype方法进行显式类型转换,包括浮点转整数及字符串数组转数值型,帮助开发者避免数据精度丢失问题。
本文汇总了13个提升Pandas数据分析效率的实用技巧,涵盖计算变量缺失率、获取分组最大值所在行、多列合并、特定字符串行删除、组内排序、类型列选择、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等核心场景,帮助开发者更高效地处理数据。
本文详解如何使用pandas将单行数据按分隔符拆分为多行,涵盖单列与多列拆分场景。同时介绍两种将多行数据合并回单行的方法,包括使用stack/join与explode结合groupby的方式,提供完整代码示例与效果展示。
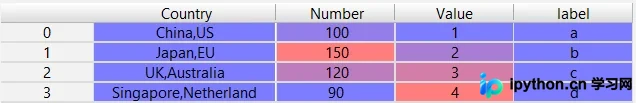
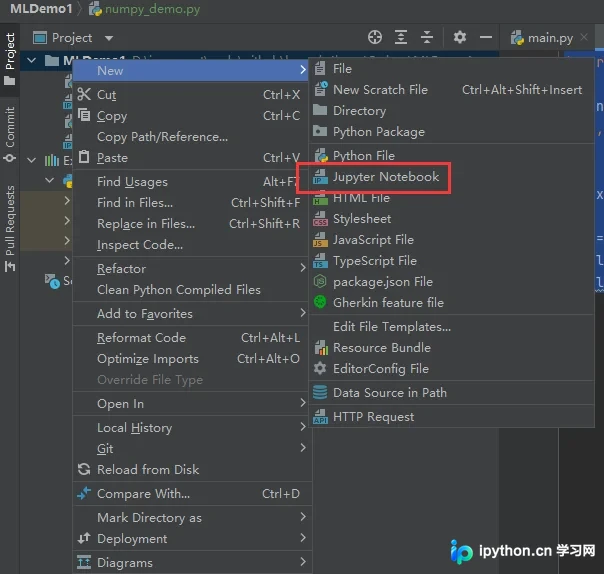
本文详细介绍如何在PyCharm中配置远程Jupyter Notebook环境。通过创建.ipynb文件并配置远程服务器URL与Token,可解决CreateProcess失败等常见报错。文章还分享了密钥拼接注意事项、后台启动命令及无Token模式的备用方案,帮助开发者高效搭建远程Python开发环境。
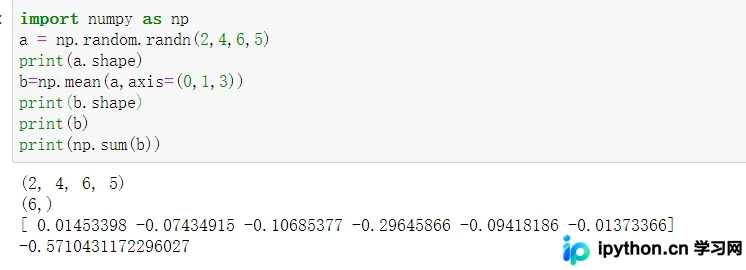
本文介绍如何在Numpy中对3x2x2矩阵进行通道间求均值,得到2x2结果。对比两种方法:直接使用np.mean指定axis参数,以及先reshape再求均值。虽然结果数值不同,但三种均值的总和相同。建议统一使用一种方法,出错时再尝试另一种。
本文深入解析NumPy数组切片中冒号(:)与负号(-1)的核心作用。冒号用于选取当前维度的所有子模块,而负号表示从后往前计数,-1特指最后一个元素。通过具体代码示例,展示如何结合两者进行多维数组的精准索引与数据提取,帮助开发者避免维度混淆,提升数据处理效率。
本文详解PyCharm中etree与lxml模块标红问题的两种常见原因及解决方法。首先解决解释器路径不匹配导致的红线,其次通过指定版本下载whl文件并pip安装修复库引用错误,帮助开发者快速恢复代码正常提示。
本文详细介绍如何在Jenkins中集成企业微信机器人,实现构建结果的实时推送。通过配置Qy Wechat Notification插件或自定义Python脚本,结合Webhook地址与责任人参数,可精准通知项目成员。文章涵盖从机器人创建、Jenkins参数配置到Python脚本处理失败用例并发送Markdown通知的完整流程,帮助团队提升发布信息的触达效率。
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
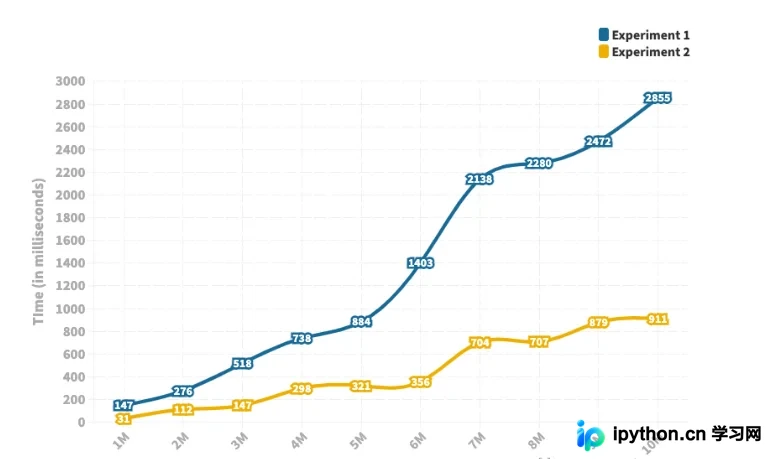
本文深入对比Pandas中Merge、Join和Concat三种数据合并方法的执行效率。通过从100万至1000万行的实验数据发现,Join操作在处理大规模数据时耗时显著低于Merge,且随数据量增长线性增加的速度更慢。建议处理海量数据时优先使用Join以提升性能。
本文介绍在PyCharm中导入第三方库的两种常用方法:通过IDE内置包管理界面安装,以及利用Anaconda环境自动同步。文章指出直接使用命令行pip可能遇到各种错误,建议检查解释器设置以确保在正确的虚拟环境中操作,从而避免安装失败。