

Python词频统计中怎么用正则去除标点和统一大小写
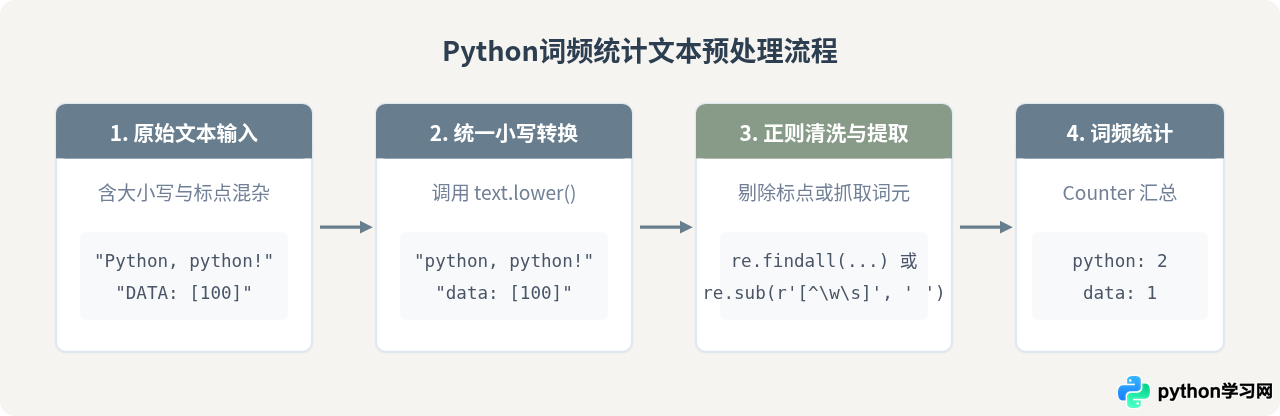
在Python词频统计中,标点符号和大小写差异会导致统计结果失真。本文详细讲解如何使用字符串lower()方法和re正则模块去除标点、清洗文本并准确统计词频,提供完整可运行的代码与方案对比。
2026-10-22
23

在Python词频统计中,标点符号和大小写差异会导致统计结果失真。本文详细讲解如何使用字符串lower()方法和re正则模块去除标点、清洗文本并准确统计词频,提供完整可运行的代码与方案对比。
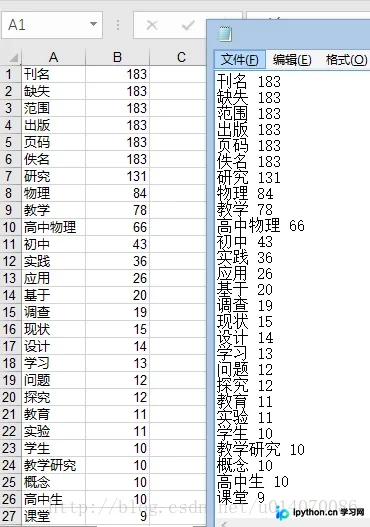
本文介绍如何利用Python的jieba库对中文论文题目进行分词与词频统计。通过安装jieba和xlwt库,读取文本文件后提取关键词并计算频率,最终将结果分别保存为txt和xls格式文件,适用于学术数据处理场景。
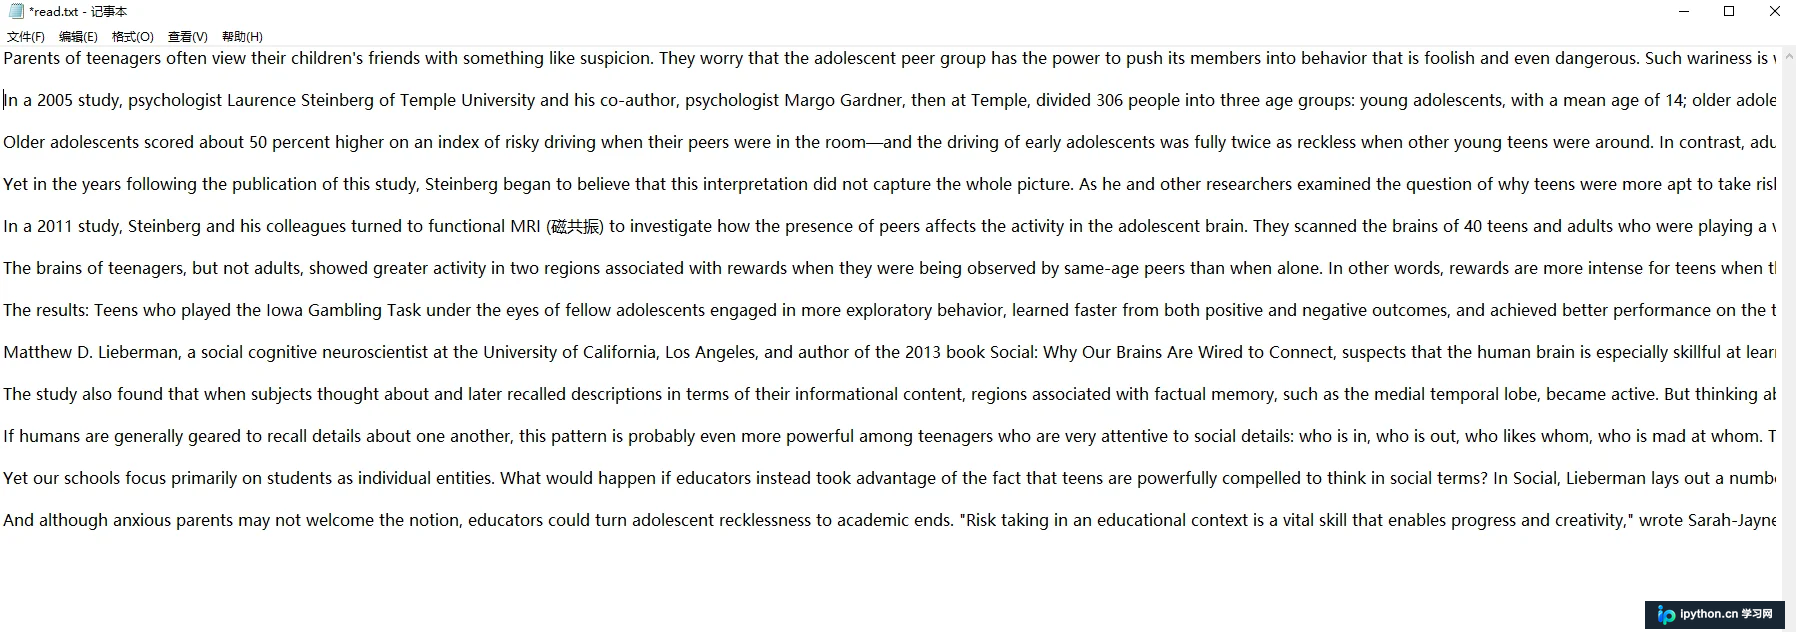
本文介绍使用Python实现词频统计软件的方法。涵盖文件读取、大小写转换、特殊字符去除、单词统计、排序及结果写入文本等步骤。通过正则表达式清洗数据,利用字典统计词频,并按出现次数降序排列,最终输出高频单词及总数,适合初学者参考。
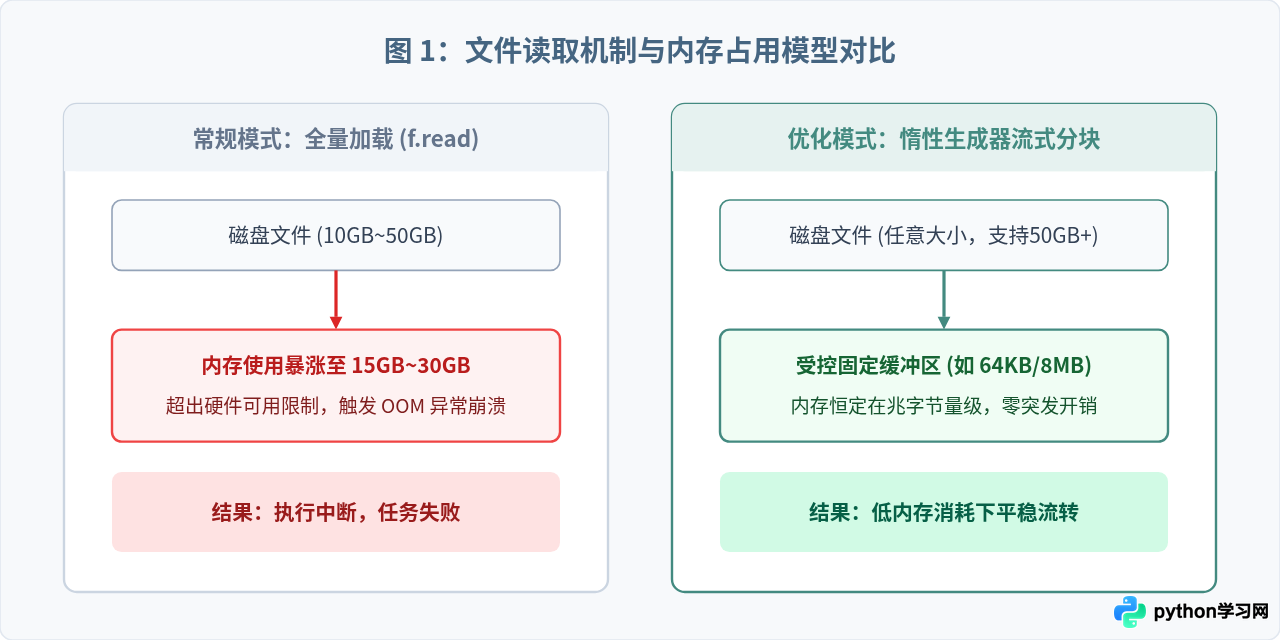
针对Python在处理数十GB超大文本文件时的内存耗尽问题,系统讲解基于生成器流式分块、跨块边界拼接、内存阈值溢写与外部多路归并的高性能词频统计方案。
本文详细介绍如何使用Python进行中文文本数据分析,重点讲解中文分词原理、jieba库核心用法、停用词清洗以及基于collections.Counter的高频词统计实战。
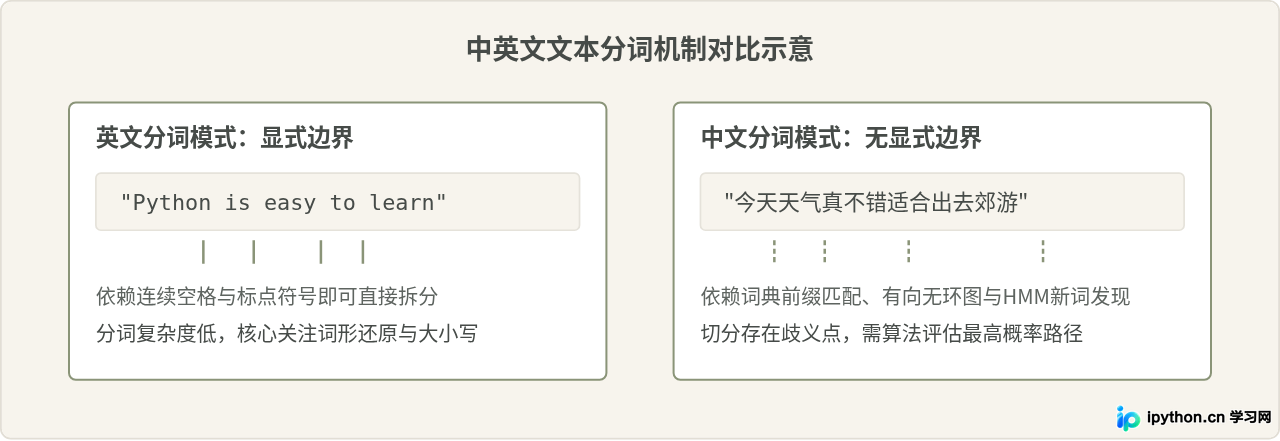
本文详解Python jieba库的安装配置及三种分词模式(精确、全、搜索引擎)的特点。通过荷塘月色案例,展示如何结合中文虚词列表进行词频统计,提供完整代码与运行结果分析,帮助开发者快速掌握中文文本处理技巧。
Python入门后,建议通过实战项目巩固基础。本文以统计文件单词频率为例,详解文件读写(open、io模块、with语句)、排序(sorted、lambda)、字典应用及collections.Counter的使用,帮助初学者掌握从数据处理到结果输出的完整流程。